

Python Scrapy 代理中间件使用与自定义实现详解

本文详细介绍Scrapy框架中代理中间件的使用与自定义方法。涵盖HttpProxyMiddleware的默认配置、通过Request meta参数设置代理、抓取快代理IP并验证可用性,以及继承HttpProxyMiddleware和直接编写中间件类两种自定义实现方案,帮助开发者解决IP被封或访问受限问题。
代理的应用场景
在编写爬虫代码时,代理的使用是不可避免的一环。在实际开发过程中,你可能会遇到以下几种需要引入代理的情况:
网络环境不稳定,需要通过代理改善连接;
目标网站在国内无法直接访问,需借助代理绕过限制;
目标网站已封锁当前IP地址,必须更换代理以继续抓取。
使用内置的 HttpProxyMiddleware 中间件
本次测试依然沿用 http://httpbin.org/ 作为目标站点,通过访问 http://httpbin.org/ip 接口可以获取当前请求所显示的 IP 地址。
HttpProxyMiddleware 中间件在 Scrapy 中默认处于启用状态,你可以查看其源码,重点关注 process_request() 方法的实现逻辑。
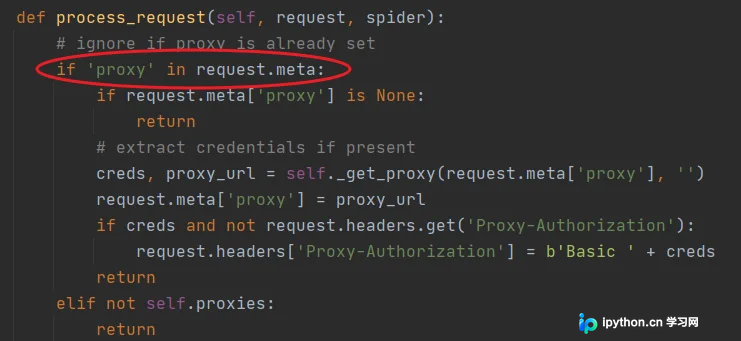
修改代理配置的方式十分简便,只需在 Requests 对象创建时,为其添加 meta 参数即可指定代理地址。
import scrapy
class PtSpider(scrapy.Spider):
    name = 'pt'
    allowed_domains = ['httpbin.org']
    start_urls = ['http://httpbin.org/ip']

    def start_requests(self):
        yield scrapy.Request(url=self.start_urls[0], meta={'proxy': 'http://202.5.116.49:8080'})
    def parse(self, response):
        print(response.text)
接下来,我们将尝试获取 https://www.kuaidaili.com/free/ 网站上的代理 IP,并测试这些代理是否有效可用。
import scrapy
class PtSpider(scrapy.Spider):
    name = 'pt'
    allowed_domains = ['httpbin.org', 'kuaidaili.com']
    start_urls = ['https://www.kuaidaili.com/free/']

    def parse(self, response):
        IP = response.xpath('//td[@data-title="IP"]/text()').getall()
        PORT = response.xpath('//td[@data-title="PORT"]/text()').getall()
        url = 'http://httpbin.org/ip'
        for ip, port in zip(IP, PORT):
            proxy = f"http://{ip}:{port}"
            meta = {
                'proxy': proxy,
                'dont_retry': True,
                'download_timeout': 10,
            }
            yield scrapy.Request(url=url, callback=self.check_proxy, meta=meta, dont_filter=True)
    def check_proxy(self, response):
        print(response.text)
随后,将筛选出的可用代理 IP 数据保存至 JSON 文件中以便后续使用。
import scrapy
class PtSpider(scrapy.Spider):
    name = 'pt'
    allowed_domains = ['httpbin.org', 'kuaidaili.com']
    start_urls = ['https://www.kuaidaili.com/free/']
    def parse(self, response):
        IP = response.xpath('//td[@data-title="IP"]/text()').getall()
        PORT = response.xpath('//td[@data-title="PORT"]/text()').getall()
        url = 'http://httpbin.org/ip'
        for ip, port in zip(IP, PORT):
            proxy = f"http://{ip}:{port}"
            meta = {
                'proxy': proxy,
                'dont_retry': True,
                'download_timeout': 10,
                '_proxy': proxy
            }
            yield scrapy.Request(url=url, callback=self.check_proxy, meta=meta, dont_filter=True)
    def check_proxy(self, response):
        proxy_ip = response.json()['origin']
        if proxy_ip is not None:
            yield {
                'proxy': response.meta['_proxy']
            }
同时,对 start_requests 方法进行相应修改,以支持抓取多达 10 页的代理数据。
class PtSpider(scrapy.Spider):
    name = 'pt'
    allowed_domains = ['httpbin.org', 'kuaidaili.com']
    url_format = 'https://www.kuaidaili.com/free/inha/{}/'
    def start_requests(self):
        for page in range(1, 11):
            yield scrapy.Request(url=self.url_format.format(page))
实现一个自定义的代理中间件相对简单,主要有两种实现途径。第一种方式是继承 HttpProxyMiddleware 类,具体代码如下:
from scrapy.downloadermiddlewares.httpproxy import HttpProxyMiddleware
from collections import defaultdict
import random
class RandomProxyMiddleware(HttpProxyMiddleware):
    def __init__(self, auth_encoding='latin-1'):
        self.auth_encoding = auth_encoding

        self.proxies = defaultdict(list)
        with open('./proxy.csv') as f:
            proxy_list = f.readlines()
            for proxy in proxy_list:
                scheme = 'http'
                url = proxy.strip()
                self.proxies[scheme].append(self._get_proxy(url, scheme))
    def _set_proxy(self, request, scheme):
        creds, proxy = random.choice(self.proxies[scheme])
        request.meta['proxy'] = proxy
        if creds:
            request.headers['Proxy-Authorization'] = b'Basic ' + creds
该段代码的核心在于重写了 __init__ 构造方法,并重新实现了 _set_proxy 方法,从而实现了随机获取代理的功能。
此外,还需同步修改 settings.py 配置文件中的相关代码。
DOWNLOADER_MIDDLEWARES = {
   'proxy_text.middlewares.RandomProxyMiddleware': 543,
}
创建一个新的代理中间件类
class NRandomProxyMiddleware(object):
    def __init__(self, settings):
        # 从settings中读取代理配置 PROXIES
        self.proxies = settings.getlist("PROXIES")
    def process_request(self, request, spider):
        request.meta["proxy"] = random.choice(self.proxies)
    @classmethod
    def from_crawler(cls, crawler):
        if not crawler.settings.getbool("HTTPPROXY_ENABLED"):
            raise NotConfigured
        return cls(crawler.settings)
观察该类可知,它从 settings.py 配置文件中的 PROXIES 配置项读取代理列表,因此需要按照如下所示修改对应配置:
DOWNLOADER_MIDDLEWARES = {
    'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': None,
    'proxy_text.middlewares.NRandomProxyMiddleware': 543,
}
# 代码是前文代码采集的结果
PROXIES = ['http://140.249.48.241:6969',
           'http://47.96.16.149:80',
           'http://140.249.48.241:6969',
           'http://47.100.14.22:9006',
           'http://47.100.14.22:9006']
如果你希望测试爬虫功能,可以编写一个随机返回请求代理的函数,将其应用到任意爬虫代码中,即可顺利实现本博客所述的功能目标。
以上就是关于 Python Scrapy 框架中代理中间件掌握与学习的详细内容,更多有关 Scrapy 框架代理中间件学习的资料,欢迎持续关注本站的其他相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









