

Python爬虫选哪个库?Requests、Scrapy与PySpider对比

如果只是抓取几个页面、调用接口或者写一个一次性数据脚本,通常先用 Requests;如果要连续抓取大量页面,需要并发、去重、重试、任务调度和数据管道,Scrapy更合适。至于 PySpider,它曾经以 WebUI、任务调度和分布式架构见长,但现在已经不适合作为新项目的常规首选。
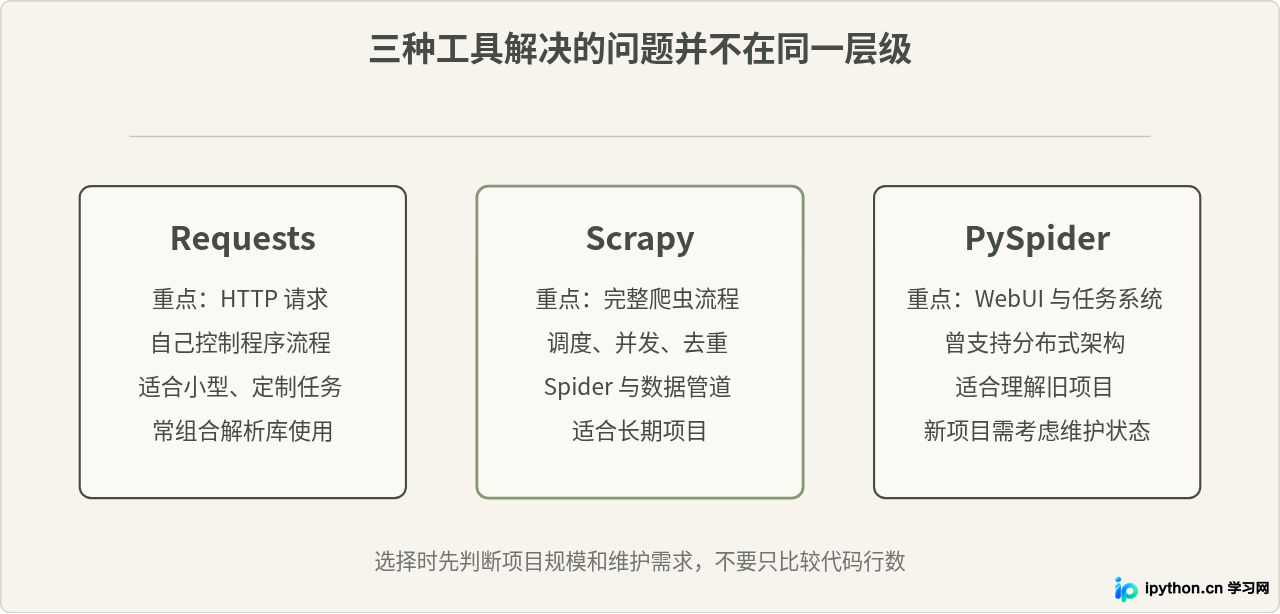
这三个名字经常一起出现在“Python爬虫工具推荐”中,但它们其实不完全属于同一层次。Requests 本质上是 HTTP 客户端库,Scrapy 是完整的爬虫框架,而 PySpider 更接近带可视化管理、调度和分布式能力的爬虫系统。选型时真正需要比较的,不是谁的代码更短,而是项目规模和后续维护方式。
一、先弄清楚:Requests、Scrapy和PySpider分别解决什么问题
Requests:把网页或接口请求回来
Requests 最擅长的事情很明确:发送 HTTP 请求,然后拿到服务器返回的内容。例如发送 GET、POST 请求、传递请求头、Cookie、参数和代理等。
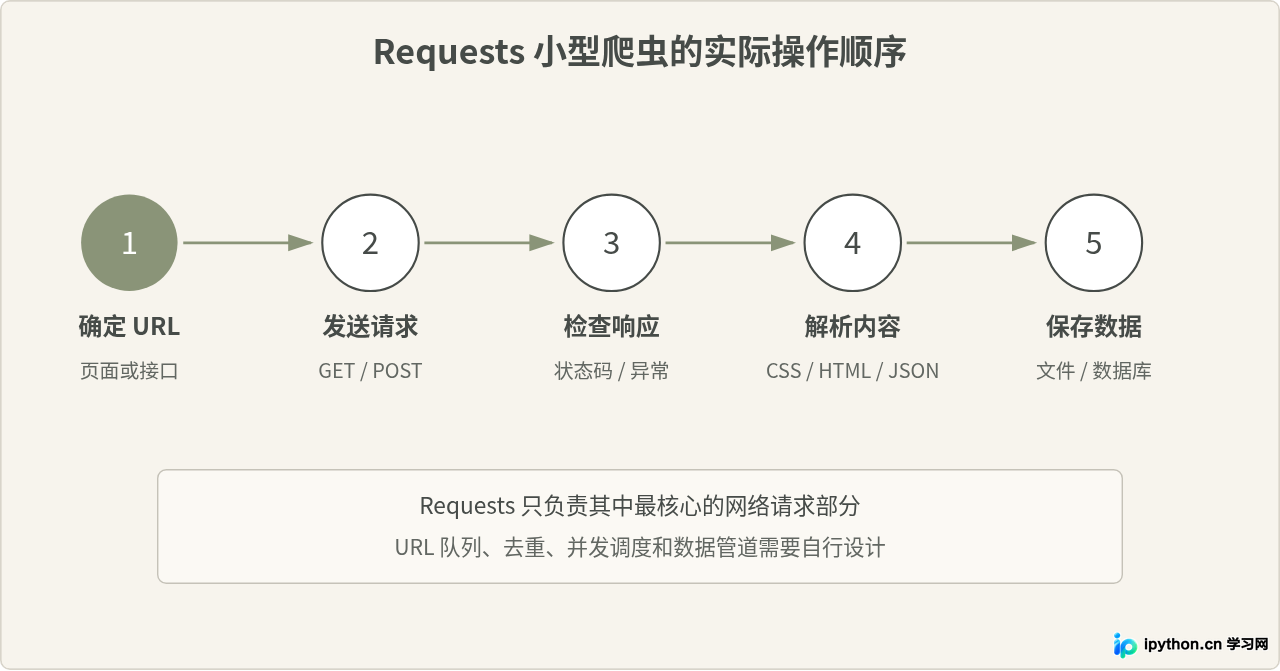
它不是一个完整的“爬虫框架”。Requests 不会自动替你维护待抓取 URL 队列,也没有内置的 Spider、Item Pipeline 和爬虫调度器。页面下载回来以后怎么解析、下一页怎么发现、数据怎么保存,都由自己的代码决定。
因此下面这种说法需要稍微修正:
更准确的说法是:Requests 是一个适合用于编写爬虫的 HTTP 请求库。对于小型爬虫,它确实可以承担最核心的网络请求部分,但解析、调度和数据存储仍需要自己组合其他代码或库。
Requests 官方文档提供了 GET、POST、JSON 解析、Cookie、Session、超时和异常处理等 HTTP 客户端能力,并特别建议实际程序为请求设置合理的 timeout。
Scrapy:把一次抓取变成完整的数据采集流程
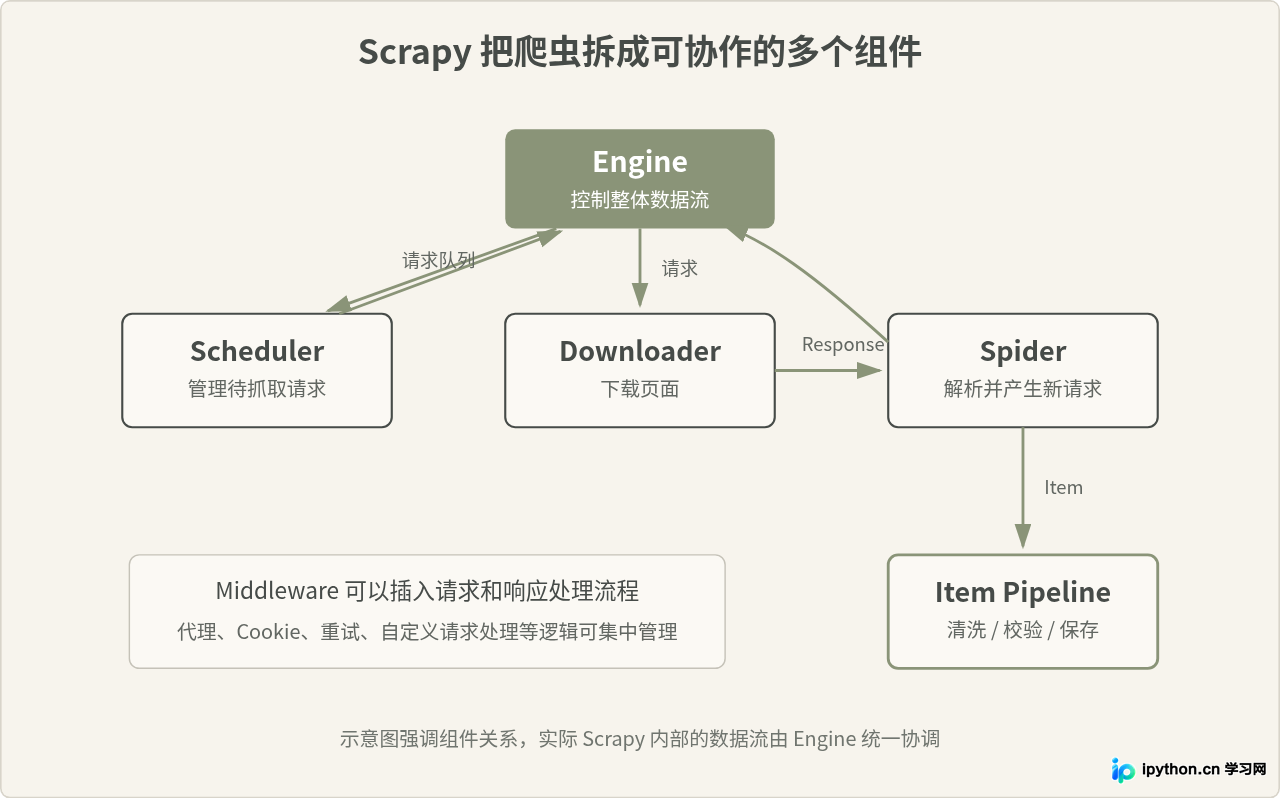
Scrapy 解决的是另外一个层次的问题。它不仅负责下载页面,还把一个爬虫项目拆成 Spider、Scheduler、Downloader、Middleware、Item Pipeline 等组件。
例如抓取一个拥有几万条文章的站点时,你通常要处理:
- 从列表页发现详情页;
- 不断生成新的待抓取 URL;
- 限制并发和访问速度;
- 过滤已经抓取过的页面;
- 处理失败请求和重定向;
- 提取结构化字段;
- 清洗数据并写入 JSON、CSV 或数据库。
这些工作如果完全用 Requests 自己搭建,代码会逐渐演变成一个小型爬虫框架。Scrapy 的价值,就是已经把这些常见模块组织好了。
Scrapy 当前文档仍在持续更新,其架构由 Engine、Scheduler、Downloader、Spider、Middleware 和 Item Pipeline 等组件组成,并采用非阻塞方式处理并发网络请求。
PySpider:偏向任务管理和可视化的爬虫系统
PySpider 的设计思路与前两者又不一样。它提供 WebUI,可以在浏览器中编辑抓取脚本、查看任务状态和结果,同时支持任务优先级、重试、周期抓取、数据库后端、消息队列和分布式组件。
这也是为什么过去一些教程会把 PySpider 推荐给“需要后台管理界面和定时任务”的项目。
但这里必须考虑维护状态。截至本文整理时,PySpider 官方 GitHub 仓库已经归档为只读,PyPI 上的最新正式版本仍然是 0.3.10,发布时间为 2018 年 4 月。官方项目资料列出的主要 Python 支持范围和部分固定依赖也明显属于较早的软件环境。对于今天新建的生产项目,这个因素比“有没有 WebUI”更加重要。
二、如果只想快速写一个爬虫,Requests最直接
例如需求只是读取一个公开页面的标题和链接,抓取数量很少,而且页面之间没有复杂的任务关系,这时直接使用 Requests 往往更清楚。
在终端建立虚拟环境后安装 Requests 和 BeautifulSoup:
python -m venv .venv
source .venv/bin/activate
pip install requests beautifulsoup4
Windows 下虚拟环境的激活命令不同,但后面的 Python 代码没有区别。
建立 spider_requests.py:
import requests
from bs4 import BeautifulSoup

url = "https://example.com/"

headers = {
    "User-Agent": "Mozilla/5.0"
}

try:
    response = requests.get(
        url,
        headers=headers,
        timeout=10
    )
    response.raise_for_status()
except requests.RequestException as exc:
    print(f"请求失败:{exc}")
    raise SystemExit(1)

soup = BeautifulSoup(response.text, "html.parser")

print("页面标题:", soup.title.get_text(strip=True) if soup.title else "无标题")

for link in soup.select("a[href]"):
    text = link.get_text(" ", strip=True)
    href = link.get("href")
    print(text, href)
执行:
python spider_requests.py这个例子可以看出 Requests 的特点:请求什么时候发送、失败怎么办、HTML 用什么解析、链接如何继续处理,都清清楚楚写在自己的 Python 程序里。
对于几十个甚至几百个 URL,这种方式并没有什么问题。尤其是抓接口时,Requests 往往比搭建完整 Scrapy 项目更省事。
三、什么时候应该从Requests换成Scrapy
不能简单地用“100 个页面用 Requests,10000 个页面就用 Scrapy”划一条数量线。页面数量只是因素之一,更重要的是任务结构。
假设要做一个新闻网站采集器:
- 首页产生频道页;
- 频道页产生分页;
- 分页产生文章详情页;
- 详情页提取标题、正文、发布时间和图片;
- 抓取失败以后需要重试;
- 已经处理过的 URL 不希望重复处理;
- 最终还要统一清洗字段并输出数据。
这种任务虽然也能用 Requests 完成,但你很快就要自己写队列、线程池或者异步逻辑、URL 去重、失败任务处理和数据保存模块。此时采用 Scrapy 通常更容易维护。
Scrapy 的 Spider 负责产生请求和解析 Response,Scheduler 管理等待抓取的请求,Downloader 获取页面,解析出的 Item 可以继续交给 Item Pipeline 做清洗、校验、去重或持久化。
四、一个最小Scrapy项目是什么样
Scrapy 入门代码比 Requests 多一些,但项目规模扩大以后,这些结构反而能减少混乱。
安装:
python -m venv .venv
source .venv/bin/activate
pip install Scrapy
Scrapy 当前官方文档建议在独立虚拟环境中安装。
创建项目:
scrapy startproject demo_spider
cd demo_spider
然后在 demo_spider/spiders/ 下创建 example.py:
import scrapy


class ExampleSpider(scrapy.Spider):
    name = "example"
    allowed_domains = ["example.com"]
    start_urls = ["https://example.com/"]

    def parse(self, response):
        yield {
            "title": response.css("title::text").get(),
            "url": response.url,
        }

        for href in response.css("a::attr(href)").getall():
            yield response.follow(href, callback=self.parse)
执行:
scrapy crawl example -O result.json这里的 response.css() 属于 Scrapy 的 Selector 功能,可以通过 CSS 选择器提取 HTML,也支持 XPath。Scrapy 的 Selector 建立在 Parsel 等组件之上,并直接和 Response 对象整合。
与 Requests 示例比较,会发现 Scrapy 没有在代码中显式写循环网络请求。Spider 只需要描述“收到这个页面以后提取什么、下一步请求什么”,请求如何进入队列和如何调度由框架负责。
五、Requests和Scrapy应该比较哪些方面
| 比较项目 | Requests | Scrapy | PySpider |
|---|---|---|---|
| 核心定位 | HTTP客户端库 | 爬虫框架 | 带WebUI和调度能力的爬虫系统 |
| 入门难度 | 低 | 需要理解项目结构和组件 | 旧教程不少,但现代环境兼容性需要额外处理 |
| 简单请求 | 非常直接 | 能做,但小任务可能显得偏重 | 没必要为简单请求部署整套系统 |
| URL调度 | 自行实现 | 内置Scheduler | 包含任务调度设计 |
| 并发抓取 | 需要自行增加线程、异步或其他方案 | 框架负责并发请求调度 | 原设计支持任务系统与分布式模式 |
| URL去重 | 自行实现 | 框架有对应请求过滤机制 | 任务系统包含相关管理能力 |
| 数据处理 | 自行组织 | Item Pipeline、Feed Export等 | 具有结果处理和存储组件 |
| 可视化后台 | 没有 | 核心框架不以WebUI为主要使用方式 | 这是其原有特色之一 |
| 现代新项目 | 适合小型和定制任务 | 适合中大型和长期维护任务 | 需要重点考虑官方项目已归档的问题 |
六、不要把“代码短”误认为“项目更简单”
Requests 经常能用十几行代码完成 Scrapy 要建立项目目录才能完成的事情,因此很容易得出“Requests 更简单,所以一直用 Requests 就行”的结论。
对于小任务,这个判断成立。
问题出现在任务不断增加以后。假设原本只有:
requests.get(url)随后增加代理、Cookie、失败重试、限速、并发、任务队列、分页发现、URL 去重、断点恢复和数据库保存。如果每项功能都继续塞到同一个脚本里,代码表面上仍然叫“Requests 爬虫”,实际上已经在自行实现一部分爬虫框架。
因此判断是否应该使用 Scrapy,一个很实用的信号是:
七、并发能力不是简单比较谁“速度更快”
有时会看到“Scrapy 比 Requests 快很多”的说法。这句话只在特定条件下才有意义。
单独请求同一个页面时,两者最终都受服务器响应时间、网络和连接条件影响。Scrapy 真正明显的优势出现在大量独立请求需要并发执行时,因为它本身就是围绕事件驱动和非阻塞网络流程构建的。
Requests 本身也不是只能一个页面一个页面顺序抓。你完全可以配合线程池、进程、队列等方案增加并发。所以不能把问题理解成:
Requests = 不能并发,Scrapy = 可以并发。
更准确的区别是,Scrapy 已经将并发下载、请求调度以及其他爬虫组件放进统一框架,而使用 Requests 时这些工程能力通常需要自己组合。
八、遇到JavaScript动态网页,换Scrapy也不一定能解决
这是选择爬虫工具时另一个容易混淆的地方。
例如浏览器打开页面能看到商品价格,但使用 Requests 下载 HTML 后找不到价格。很多人的第一反应是“Requests 不行,换 Scrapy”。实际上,如果数据是页面加载后由 JavaScript 再请求接口取得的,直接换 Scrapy 后仍可能拿不到。
更合理的排查顺序是:
- 查看浏览器开发者工具中的 Network;
- 确认目标数据是否来自单独的 XHR、Fetch 或其他接口;
- 如果可以直接请求数据接口,优先请求接口;
- 只有必须依赖浏览器执行 JavaScript 时,再考虑浏览器自动化或渲染方案。
Scrapy 官方文档处理动态页面时同样建议优先找到真实的数据来源,在无法直接取得数据时再考虑无头浏览器等方案。
因此,“动态网页应该用 Scrapy”并不准确。Requests 和 Scrapy 的主要区别是抓取工程结构,而不是一个执行 JavaScript、另一个不执行。
九、PySpider现在还能不能用
从软件功能设计上说,PySpider 并不是一个没有价值的项目。它曾经提供一些很实用的能力:
- 浏览器中的脚本编辑器;
- 任务状态监控;
- 项目管理;
- 结果查看;
- 定时和周期抓取;
- 任务优先级和失败重试;
- 多种数据库和消息队列后端;
- 分布式架构。
这些特性仍然可以帮助理解一个完整爬虫系统应该包含哪些组件。PySpider 官方项目说明也确实列出了 WebUI、任务重试、周期抓取、数据库、消息队列以及分布式架构等功能。
但用于新项目时,软件维护状态必须放到更高优先级。官方仓库已经归档,而且 PyPI 最新正式版本停留在 2018 年,这意味着在现代 Python、现代依赖库和新的操作系统环境中使用时,可能需要处理依赖和兼容问题。
因此比较这三个工具时,可以把 PySpider 分成两种情况:
- 维护已有 PySpider 项目:继续理解它的 Handler、Scheduler、Fetcher、Processor、Result Worker 等组件是有必要的。
- 从零建立新的长期项目:不应该仅因为它自带 WebUI 就忽略维护状态,通常应先评估仍在持续维护的方案。
十、三个实际场景应该怎么选
场景1:抓取20个接口,每小时保存一次结果
如果接口地址明确,没有复杂的页面发现关系,只需要依次调用接口、解析 JSON、保存数据库,Requests 通常最直接。
这种任务使用 Scrapy 当然也能完成,但框架带来的调度能力没有充分发挥。
场景2:抓取整个内容网站的几十万条页面
任务包含栏目、分页、详情页,可能还有图片、重复 URL、失败重试、并发控制和持续运行。此时 Scrapy 的项目结构通常更加合适。
这里真正重要的不是“几十万”这个数字,而是抓取过程已经形成复杂的 URL 网络和长期运行的数据处理流水线。
场景3:公司里已经有一个PySpider采集系统
这时不能简单得出“PySpider 已归档,所以立即重写”的结论。如果现有系统运行稳定,而且修改频率很低,迁移本身也有成本。
更现实的处理方法是先检查:
- 当前 Python 版本;
- 依赖是否还能安全维护;
- 系统是否需要继续增加新功能;
- 部署环境是否准备升级;
- 现有任务迁移到其他框架的工作量。
如果旧环境可以隔离,并且系统只负责稳定运行少量已有任务,可以继续维护;如果准备增加大量新任务或全面升级运行环境,再规划迁移往往更合理。
十一、最终怎么选:用需求一步一步判断
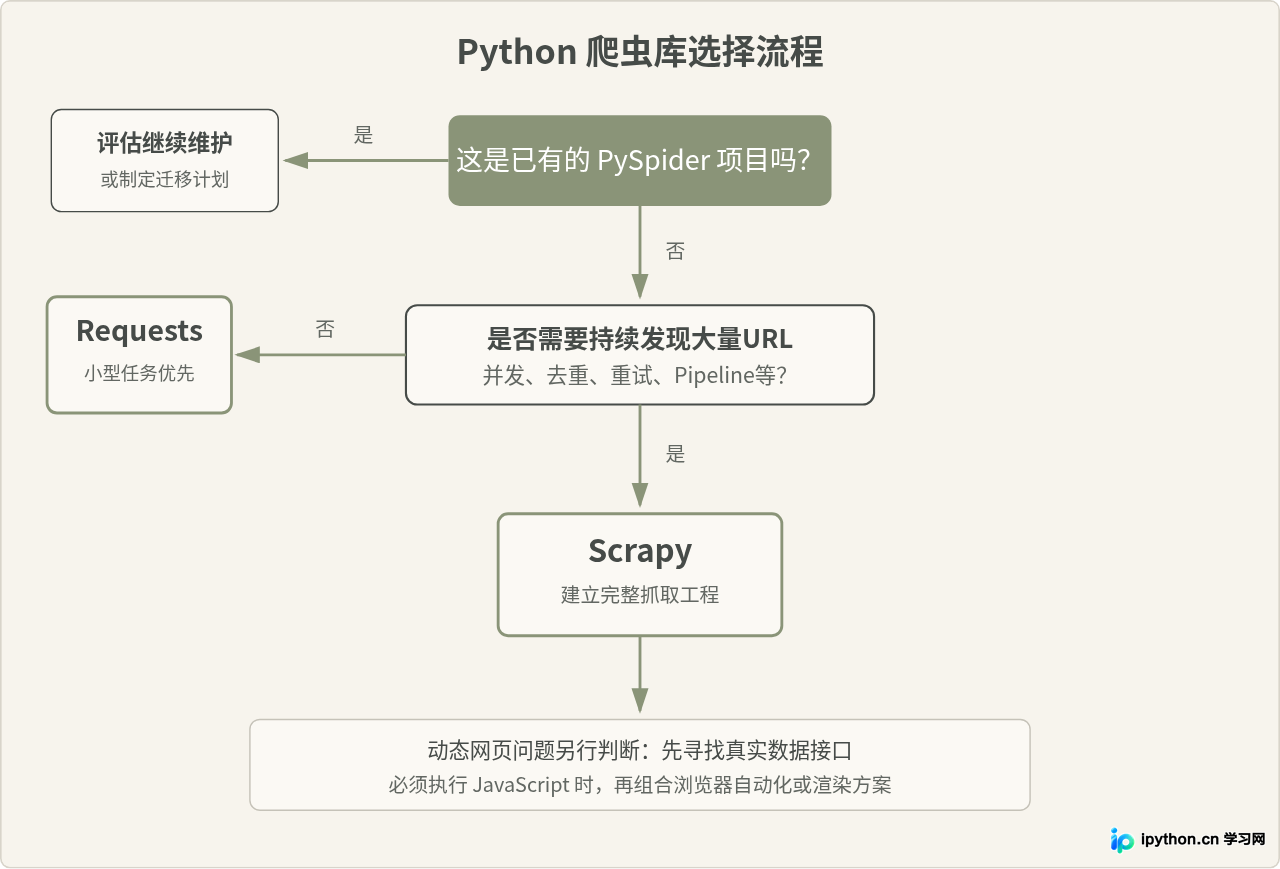
可以把最终选择压缩成下面几条:
- 学习HTTP请求、调用接口、抓少量页面:先学 Requests。
- 需要高度自由的定制脚本:Requests 很方便,解析库和存储方式可以自行组合。
- 网站级批量采集、页面关系复杂:优先考虑 Scrapy。
- 需要成熟的调度、并发、Middleware、Pipeline 等工程结构:Scrapy 更合适。
- 维护已有 PySpider 系统:根据现有环境继续维护或规划迁移。
- 从零创建长期维护的新项目:选择 PySpider 前需要充分考虑其官方仓库已经归档以及版本长期未更新的问题。
十二、学习顺序其实不需要三选一
如果是刚开始学习 Python 爬虫,不需要一开始就在 Requests 和 Scrapy 之间做永久选择。
比较自然的学习顺序是先通过 Requests 理解 HTTP 请求、请求头、Cookie、状态码和页面解析,能够独立完成一个小型爬虫;等开始遇到分页、URL 队列、并发、失败重试和数据管道之后,再进入 Scrapy。
这样学习 Scrapy 时,你会更容易理解为什么框架需要 Scheduler、Downloader、Spider 和 Pipeline,而不是只记住命令和项目目录。
PySpider 则更适合作为旧系统维护对象或架构参考。它的 WebUI、任务调度和分布式设计仍然有理解价值,但对于新项目,软件是否持续维护、能否跟随新的 Python 环境升级,往往比界面是否方便更加重要。
因此,“Python爬虫选哪个库”最终不是选出一个所有情况下都最好的工具,而是判断自己现在是在发送几个请求,还是在建设一套长期运行的抓取系统。前者用 Requests 往往足够,后者使用 Scrapy 通常更符合工程需求。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









