

Pandas groupby() 核心用法与多索引处理详解
本文详解 Pandas 中 groupby() 函数的核心用法,涵盖按字典或列分组、apply 与 agg 的区别、多函数聚合及可视化。重点解析多级索引(MultiIndex)的透视表形式、使用 xs() 选取特定索引以及通过 reset_index() 恢复常规 DataFrame 结构的完整操作流程。
2026-10-11
6

本文详解 Pandas 中 groupby() 函数的核心用法,涵盖按字典或列分组、apply 与 agg 的区别、多函数聚合及可视化。重点解析多级索引(MultiIndex)的透视表形式、使用 xs() 选取特定索引以及通过 reset_index() 恢复常规 DataFrame 结构的完整操作流程。
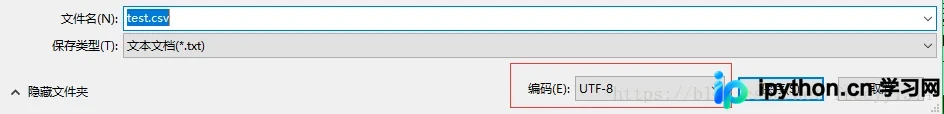
在使用Python的pandas库读取CSV文件时,常因文件编码格式(如GBK)与默认UTF-8不匹配而抛出UnicodeDecodeError。本文介绍如何通过指定encoding参数(如gbk)直接解决,以及利用文本编辑器转换文件编码的备用方案,确保数据顺利加载。
本文详细介绍Pandas库中fillna方法处理缺失数据的多种策略。涵盖使用常数或字典填充、通过inplace直接修改原数据、利用method参数进行前后向填充,以及控制limit和axis限制填充范围与方向。适合需要掌握数据预处理技能的开发者参考。
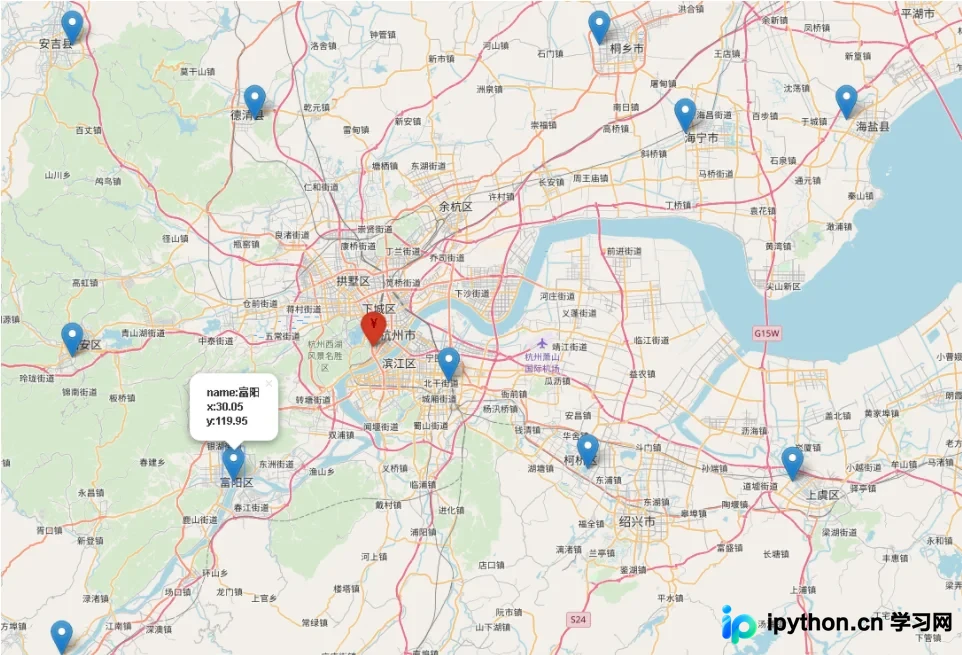
本文介绍如何使用Python的folium库结合pandas处理Excel数据,绘制气象站点地图。通过度分转换、距离计算和自定义标记,展示如何从Excel文件中读取数据并在地图上可视化站点位置。
本文详解使用pandas读取包含中文Unicode编码的CSV文件,重点解析delimiter、header及encoding参数的应用。通过names参数覆盖自动生成的列索引,实现自定义列标题,并提供具体代码示例与输出结果分析。
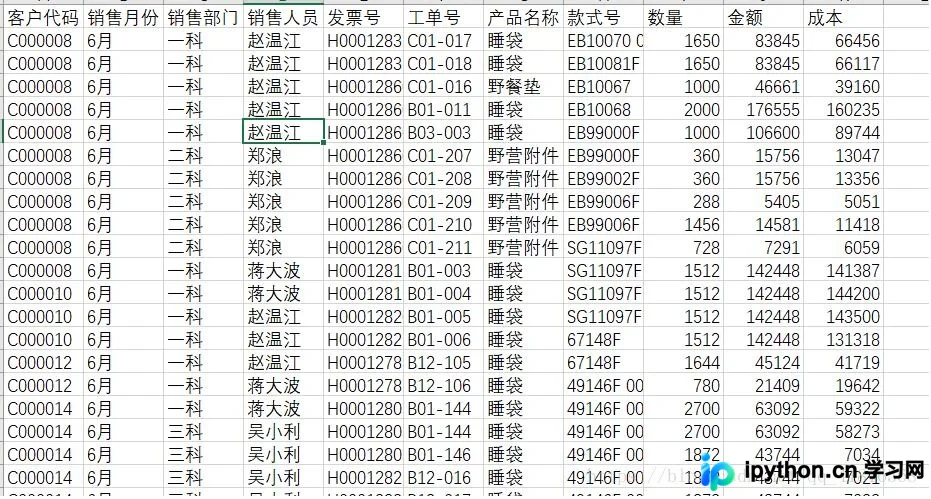
本文介绍如何使用Python的pandas库将一个Excel文件按指定列(如销售部门)拆分为多个独立的Excel文件。通过读取数据、提取分类并循环处理,将不同类别的数据分别保存为新的Excel文件,实现数据的分类管理。
本文介绍如何使用pandas的iloc方法结合列表推导式,通过行索引表达式进行等距抽样。核心步骤包括生成目标索引列表,然后利用iloc选取对应行,最终实现数据的高效分割与提取。
本文详细介绍如何利用Python的Pandas库读取本地CSV文件,处理日期格式,并通过两种方法将数据保存至MySQL数据库。文章对比了直接使用MySQLdb库与使用SQLAlchemy结合to_sql方法的优劣,重点讲解了日期格式转换及字段类型匹配问题,帮助开发者高效完成数据入库操作。
本文介绍如何利用Python的pandas库处理爬虫获取的小型非结构化数据。通过示例演示如何安装pandas及依赖库openpyxl,并将字典列表转换为DataFrame后,直接导出为Excel、HTML或CSV格式文件,实现数据的直观展示与分析。
本文总结了Python中保存文件的几种常用方法,包括使用pickle模块保存为二进制文件、使用numpy保存为npz格式以及使用pandas保存为csv格式。文章提供了具体的代码示例,帮助读者快速掌握这些技术。
在Python中使用pandas或matplotlib进行数据可视化时,常遇到图表窗口无法弹出的问题。这通常是因为缺少索引导致报错,或忘记调用显示命令。本文通过构建DataFrame的两种方法及plt.show()的使用,解决绘图不显示及ValueError错误,确保图表正常渲染。
在使用 pandas.read_csv() 读取 CSV 文件时,若遇到中文乱码,通常是因为文件编码与读取参数不匹配。本文介绍通过设置 encoding 参数(如 'gbk' 或 'utf-8')解决乱码的方法,并详细说明当直接指定编码报错时,如何利用记事本将文件另存为指定编码格式,从而确保数据正确读取。