

Python 2 中文编码处理与文件读写详解
本文详细解析 Python 2 中处理中文编码的常见陷阱与解决方案。涵盖如何正确设置文件编码声明、理解 str 与 unicode 的区别,以及在 Windows 环境下处理 ANSI 和 UTF-8 文件时的编码转换技巧。重点讲解了 BOM 头处理、print 输出机制及跨平台编码兼容性问题,帮助开发者避免中文乱码错误。
2026-10-16
4

本文详细解析 Python 2 中处理中文编码的常见陷阱与解决方案。涵盖如何正确设置文件编码声明、理解 str 与 unicode 的区别,以及在 Windows 环境下处理 ANSI 和 UTF-8 文件时的编码转换技巧。重点讲解了 BOM 头处理、print 输出机制及跨平台编码兼容性问题,帮助开发者避免中文乱码错误。
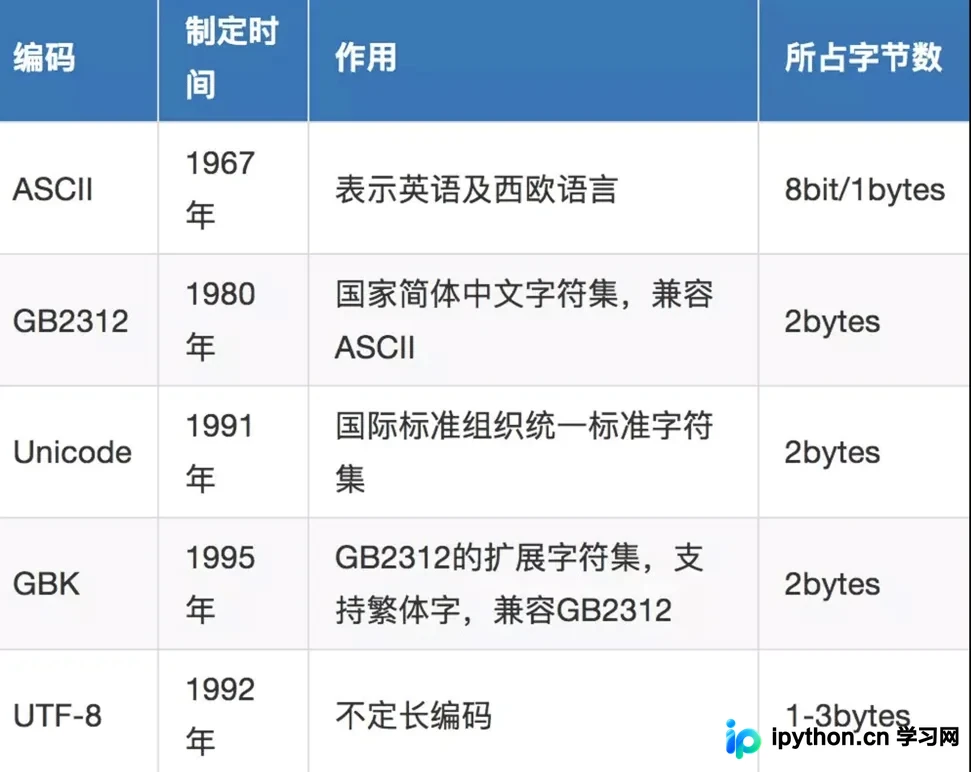
本文详细解析Python中常见的四种编码格式:ASCII、Unicode、UTF-8及GBK。从Python2默认ASCII到Python3默认UTF-8的演变出发,阐述各编码的字节占用、适用范围及存储效率差异,帮助开发者理解字符编码原理并解决乱码问题。
本文介绍Python中全角与半角字符转换的实现原理及代码。全角字符Unicode范围通常为0xFF01~0xFF5E,半角为0x21~0x7E,空格需单独处理(全角12288,半角32)。通过chr()、ord()函数结合偏移量计算,可高效完成非中文及符号的全半角互换,适用于NLP数据预处理。
本文总结了Python中常见的中文乱码问题及解决方法,涵盖SyntaxError、UnicodeDecodeError和UnicodeEncodeError等典型错误。文章详细解释了decode与encode的工作原理,分析了IDE控制台输出限制,并提供了针对特定环境(如UliPad、Windows XP)的编码转换代码示例,包括处理网页内容时的编码转换策略。
在C++开发中,宏内的#(字符串化)运算符常用于记录调试信息。但在Unicode(宽字符)环境下直接输出可能导致乱码。本文将解析这一问题,并介绍通过添加L前缀及使用双合并操作符 L## 来正确生成宽字符串字面量的具体方法,确保跨平台日志输出的准确性。
本文详解 Python 中常见的编解码问题,包括 UnicodeEncodeError、UnicodeDecodeError 及 SyntaxError 的成因与解决方案。重点介绍“Unicode 三明治”原则,强调在文件读写时显式指定 encoding 参数以避免 Windows 系统下的文件乱码问题,确保数据处理的准确性。
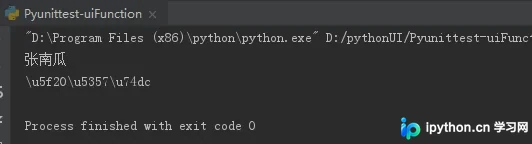
本文介绍如何利用Python的encode()和decode()函数实现ASCII码与中文字符的相互转换,以及Unicode编码字符串向UTF-8格式的转换。通过具体代码示例展示了使用unicode_escape编解码器的技巧,帮助开发者理解相关原理并解决实际的字符编码转换问题。
在SQL Server数据库设计中,合理选择字符数据类型对性能和存储至关重要。本文深入解析char、nchar、varchar和nvarchar的核心区别,包括定长与变长特性、Unicode与非Unicode编码差异以及存储空间计算方式,提供基于场景的选型策略与优化建议。
本文通过Python代码示例,演示了中文字符串在GBK与UTF-8编码间的转换过程。重点解析了Unicode字符串作为中间桥梁,实现不同编码格式(如Windows常用的gb2312与Python默认的utf-8)之间互转的核心机制,帮助开发者解决中文乱码问题。
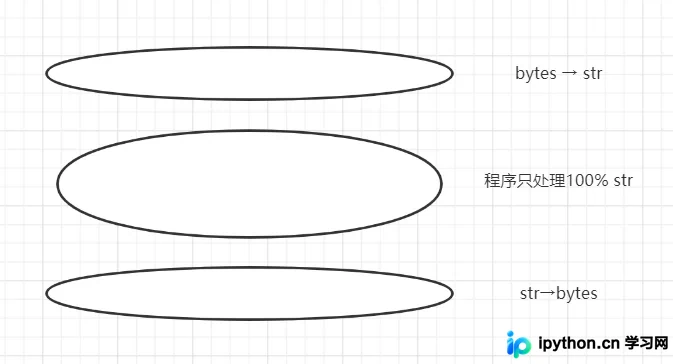
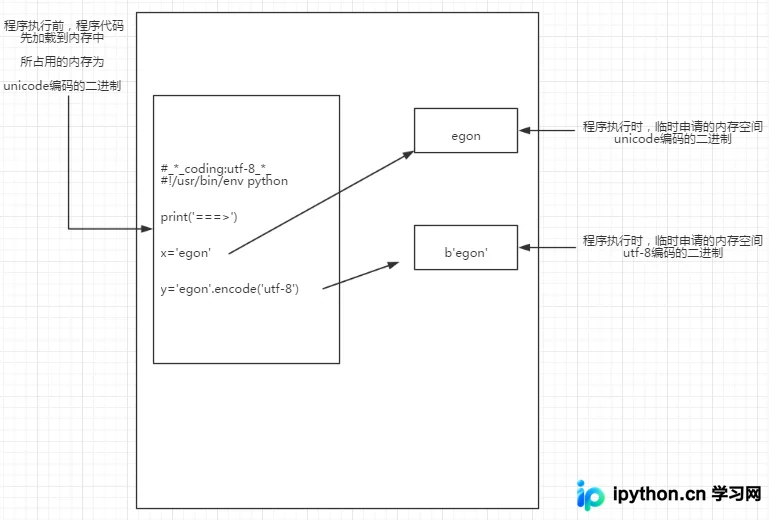
本文深入解析 Python 字符编码机制,对比 Python2 与 Python3 在默认编码及内存处理上的差异,重点阐述 .py 文件头编码声明的作用。同时详细介绍文件处理的两种模式:字符方式(t)与二进制方式(b),强调 encoding 参数的使用场景及资源释放规范,帮助开发者避免乱码并高效管理文件资源。
本文深入解析Python字符编码机制,阐述ASCII、GBK、Unicode及UTF-8的发展与区别。重点讲解Python解释器执行流程中文件读写与内存编码转换原理,对比Python2与Python3在字符串类型(str/bytes/unicode)及默认编码策略上的核心差异,帮助开发者避免编码错误。
本文介绍如何在Python中将字典内的Unicode编码字符转换为中文显示。主要方法包括使用json.dumps配合decode('unicode-escape'),以及通过ord()函数获取字符编码并以16进制格式打印。同时涵盖从UTF-8或GBK文件读取字符串并转换为Unicode字符串的操作。