

Python Pandas DataFrame 常用操作指南
本文详细介绍 Python Pandas 库中 DataFrame 的核心操作方法。涵盖基础属性获取(如 index、shape)、数据访问(loc、iloc)、多行多列切片、条件筛选、列的新增与删除,以及数据修改。通过具体代码示例,帮助开发者快速掌握 DataFrame 的高效数据处理技巧。
2026-10-12
6

本文详细介绍 Python Pandas 库中 DataFrame 的核心操作方法。涵盖基础属性获取(如 index、shape)、数据访问(loc、iloc)、多行多列切片、条件筛选、列的新增与删除,以及数据修改。通过具体代码示例,帮助开发者快速掌握 DataFrame 的高效数据处理技巧。
本文介绍在pandas中如何调整DataFrame的列顺序、添加新列以及修改列名。通过直接指定列名列表实现重排,利用直接赋值或assign方法添加单列或多列,并使用rename接口修改列名。
本文详解pandas中df.dropna()函数的使用,涵盖Series和DataFrame的缺失值删除。重点解析axis、how、thresh、subset和inplace等关键参数,通过具体代码示例展示如何灵活处理不同场景下的NaN数据,帮助开发者高效清理数据。
本文详解pandas中NaN空值的判断方法,指出pd.isnull、pd.isna及np.isnan为正确方式,而直接使用==、bool或if语句会导致误判。文章通过示例对比is与==表达式的差异,并补充了查找、填充及删除空值的完整操作指南,帮助开发者避免常见陷阱。
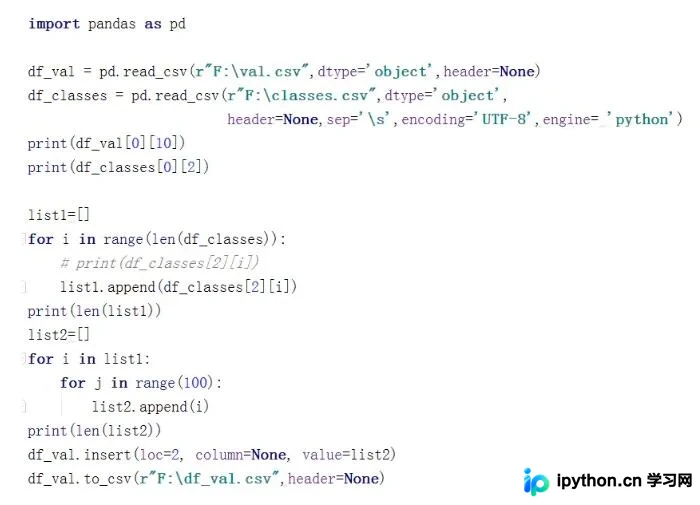
本文介绍在 pandas 中为 DataFrame 添加空列并赋空值的方法。通过 apply 函数或直接赋值实现,并解决多文件标签映射时的列扩展问题。
本文介绍如何使用Python的pandas库读取Excel表格指定列的数据,并通过循环处理将单行数据拼接为带有单引号和逗号分隔的字符串格式。文章提供了完整的Python脚本源码,包含文件校验、列号输入、数据清洗及结果写入文本文件的完整流程,适用于需要将大量代码或ID批量转换为SQL插入语句等场景。
本文介绍在pandas中统计DataFrame重复值次数的两种核心方法。通过duplicated()标记重复行,结合布尔索引筛选并统计数量;或利用drop_duplicates()计算去重前后的行数差值。文章包含完整的代码示例与结果解析,帮助快速处理数据清洗中的重复项问题。
本文详解如何利用Python的os与pandas模块,自动化合并同一文件夹下多个Excel文件中同名Sheet的数据。通过遍历文件、读取数据、提取Sheet名并拼接内容,最终生成包含所有同名Sheet数据的新Excel文件,适用于日常办公数据整理场景。
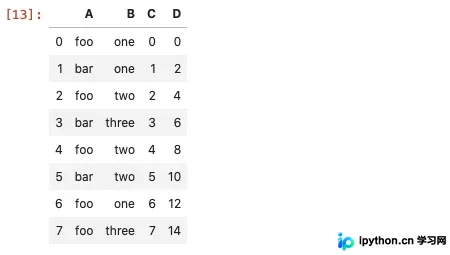
本文详解pandas中筛选指定列值对应行的多种方法。涵盖布尔索引、基于iloc的位置索引、基于loc的标签索引及高效的query API。通过具体代码示例,演示如何筛选等于标量、属于范围、多条件组合及排除特定值的行,帮助开发者高效处理数据子集。
本文详细介绍如何使用pandas库高效处理CSV文件。涵盖指定编码(如GBK)读取数据、日期字段类型转换、多列字符串拼接、基于符号的数值计算、数据分组聚合以及去重保存等核心操作步骤,帮助开发者快速完成数据清洗任务。
本文介绍在 Python Pandas 中删除指定列值或多列内容的几种方法。通过 Series 的 isin 反函数(使用 - 号)处理大批量数据,利用 != 比较运算符处理少量指定内容,以及结合 dropna() 处理 DataFrame 的多条件删除。
本文介绍在Pandas中将单列数据按分隔符拆分为多列的多种方法。通过str.split()结合expand参数、索引提取或解包赋值,可高效完成数据清洗。同时涵盖处理列表数据及生成测试数据的技巧,帮助开发者快速实现列拆分操作。