

Pandas groupby() 核心用法与多索引处理详解

本文详解 Pandas 中 groupby() 函数的核心用法,涵盖按字典或列分组、apply 与 agg 的区别、多函数聚合及可视化。重点解析多级索引(MultiIndex)的透视表形式、使用 xs() 选取特定索引以及通过 reset_index() 恢复常规 DataFrame 结构的完整操作流程。
groupby 基础分组与聚合
Pandas 的 groupby() 提供了灵活的数据分组机制,支持通过映射字典、键函数或具体的列系列进行分组。在聚合操作中,apply() 处理的是类 DataFrame 的数据表对象,而 agg() 每次仅传入一列,但支持同时传入多个聚合函数以执行复杂计算。
示例数据构建
首先,我们构建一个包含姓名(Q)、数值(A, B, C)的 DataFrame 用于演示:
import pandas as pd
df = pd.DataFrame({'Q':['LI','ZHANG','ZHANG','LI','WANG'], 'A' : [1,1,1,2,2], 'B' : [1,-1,0,1,2], 'C' : [3,4,5,6,7]})
apply 与 agg 的区别
apply() 将分组后的子 DataFrame 作为整体传入 lambda 函数。例如,打印每个分组的完整数据:
df.groupby('Q').apply(lambda x:print(x))相比之下,agg() 针对单列进行聚合计算,但允许指定多个统计函数:
df.groupby('Q').agg(['mean','std','count','max'])可视化与多级索引处理
groupby 聚合后的结果可以直接调用 plot() 进行可视化,例如绘制条形图:
%matplotlib inline
df.groupby('Q').agg(['mean','std','count','max']).plot(kind='bar')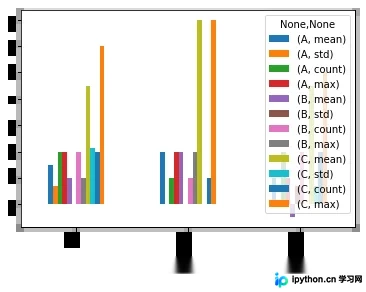
当使用两个或更多列进行分组时(如 ['Q','A']),结果将呈现为透视表形式,其本质是一个带有 MultiIndex 的 DataFrame。这种结构在数据选取时需要特殊处理。
多级索引(MultiIndex)操作
创建多级索引 DataFrame 并查看结果:
Muldf = df.groupby(['Q','A']).agg('mean')
print(Muldf)
要选取特定索引层级的数据,可使用 xs() 函数。例如,选取 'Q' 层级为 'LI' 的数据:
Muldf.xs('LI')重置索引结构
若需将 MultiIndex 恢复为常规 DataFrame 结构,可调用 reset_index()。该操作会将 MultiIndex 的元组转换为 columns,并将 index 重置为从 0 开始的整数序列:
Muldf.reset_index()以上就是 Pandas groupby() 核心用法与多级索引处理的详细内容,更多关于 Python 数据处理与 Pandas 高级技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









