

Pandas 解析 Excel 时 MemoryError 的成因与优化办法
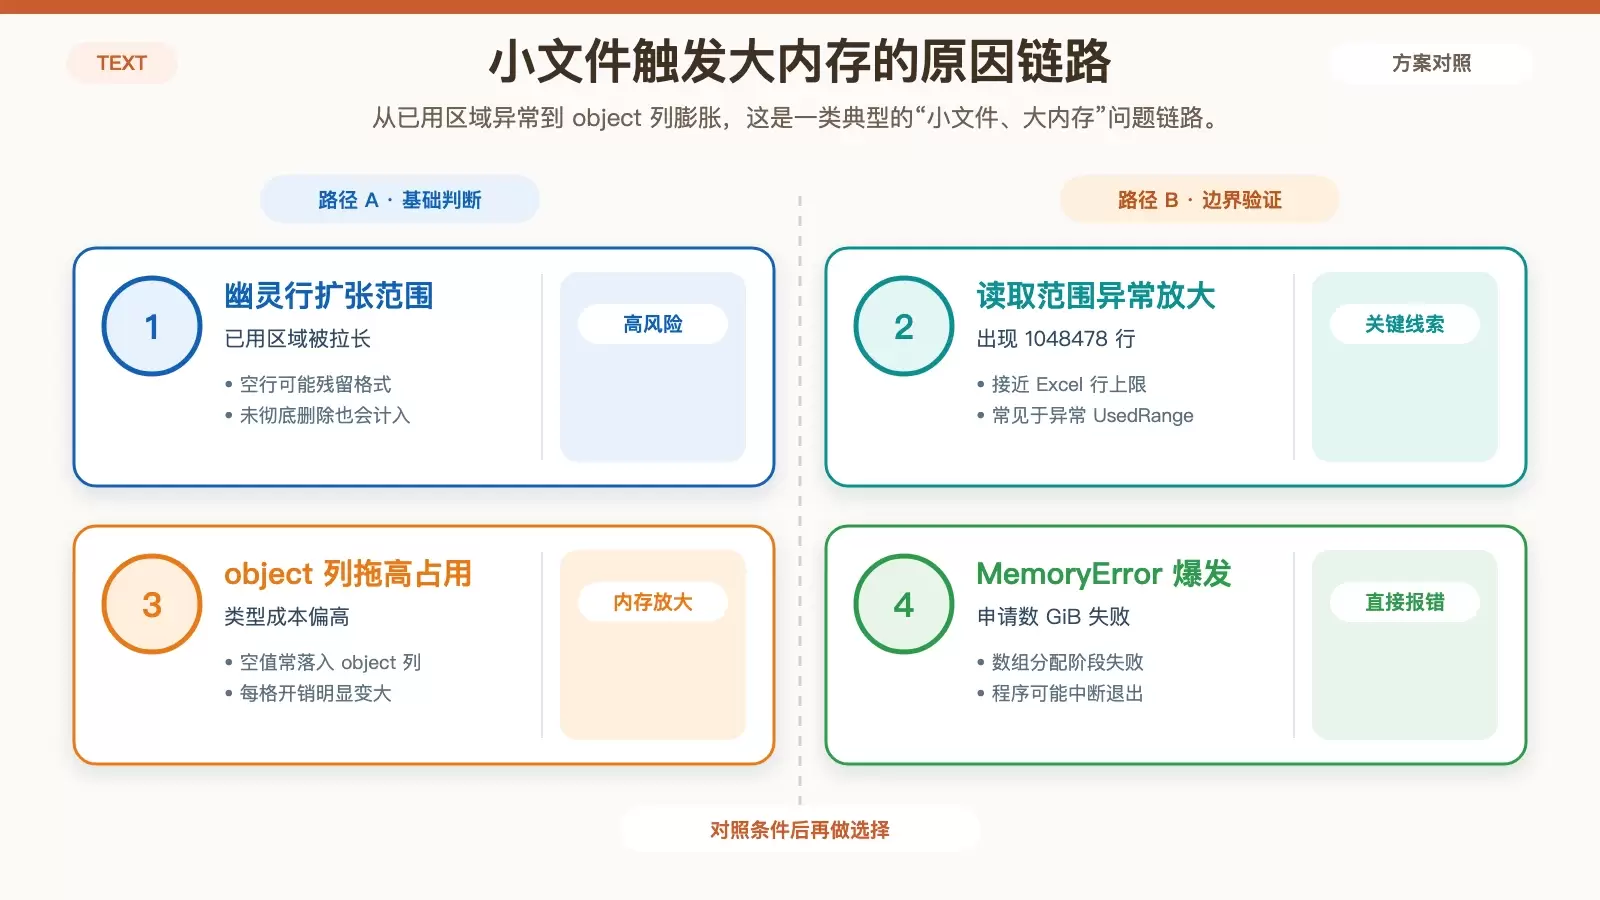
Pandas 读取 Excel 时出现 MemoryError,并不一定意味着文件真的很大。很多情况下,问题出在 Excel 的“已用区域”被异常拉长,配合 object 类型列和未及时释放对象,最终触发数 GiB 级内存申请。本文结合报错特征、成因和可直接落地的处理方式,整理出一套更稳妥的 Excel 解析思路。
2026-08-25
332

Pandas 读取 Excel 时出现 MemoryError,并不一定意味着文件真的很大。很多情况下,问题出在 Excel 的“已用区域”被异常拉长,配合 object 类型列和未及时释放对象,最终触发数 GiB 级内存申请。本文结合报错特征、成因和可直接落地的处理方式,整理出一套更稳妥的 Excel 解析思路。
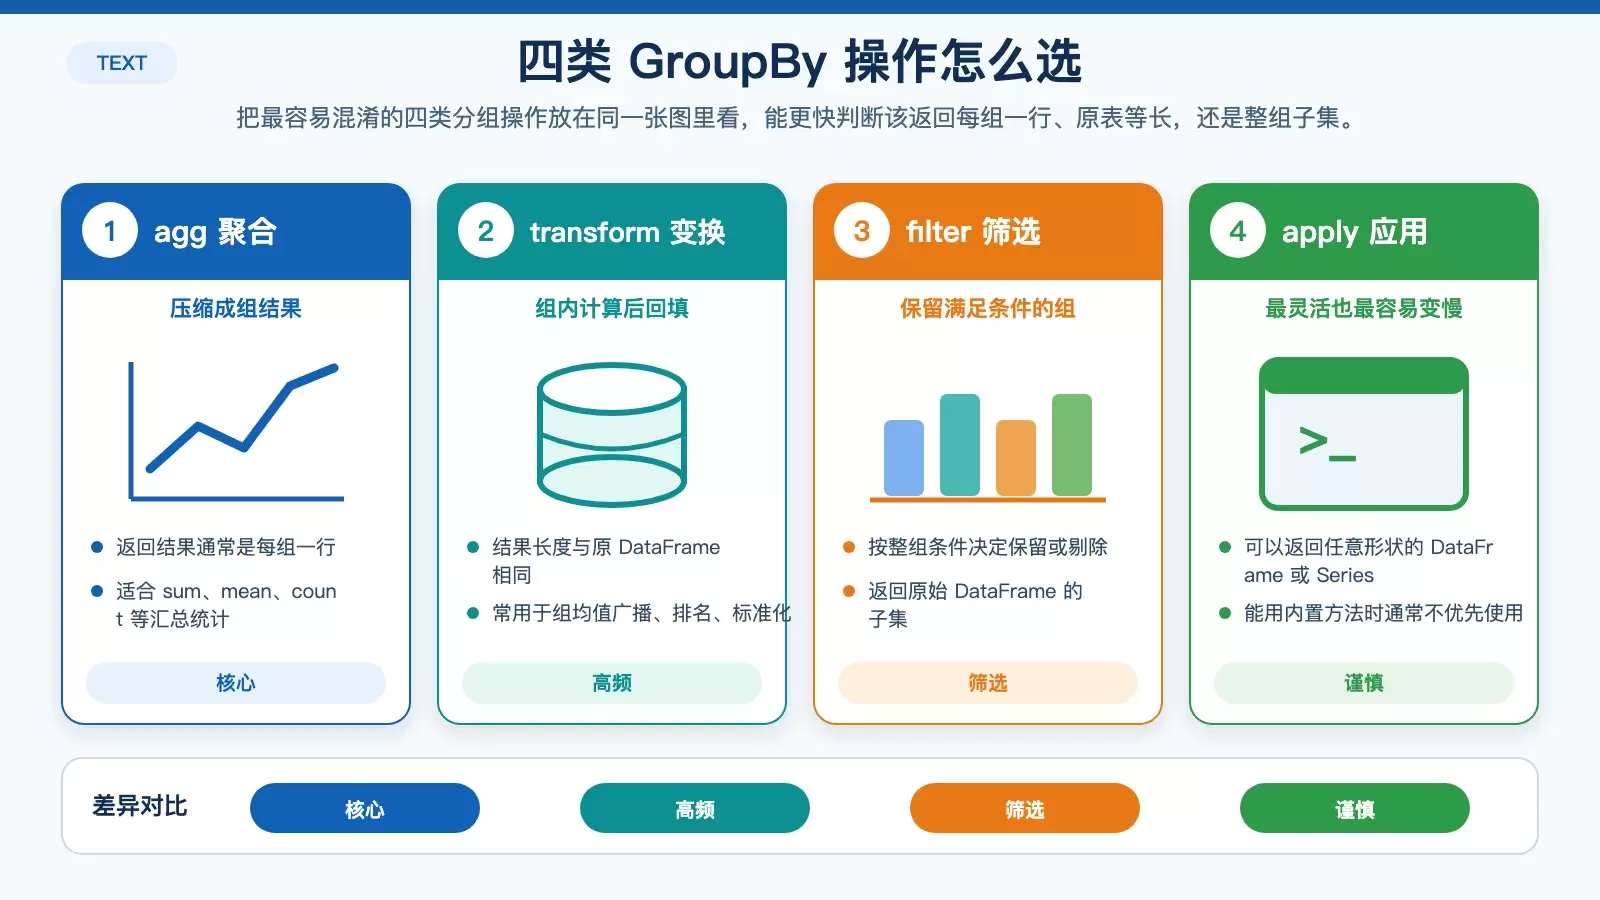
这篇文章围绕 Pandas `groupby()` 的常见使用场景,系统梳理了分组对象创建、聚合、`transform`、`filter`、`apply` 以及多种实战技巧。重点不只在语法罗列,还会说明什么时候该用哪一种方法,以及如何兼顾结果形状、可读性与性能。
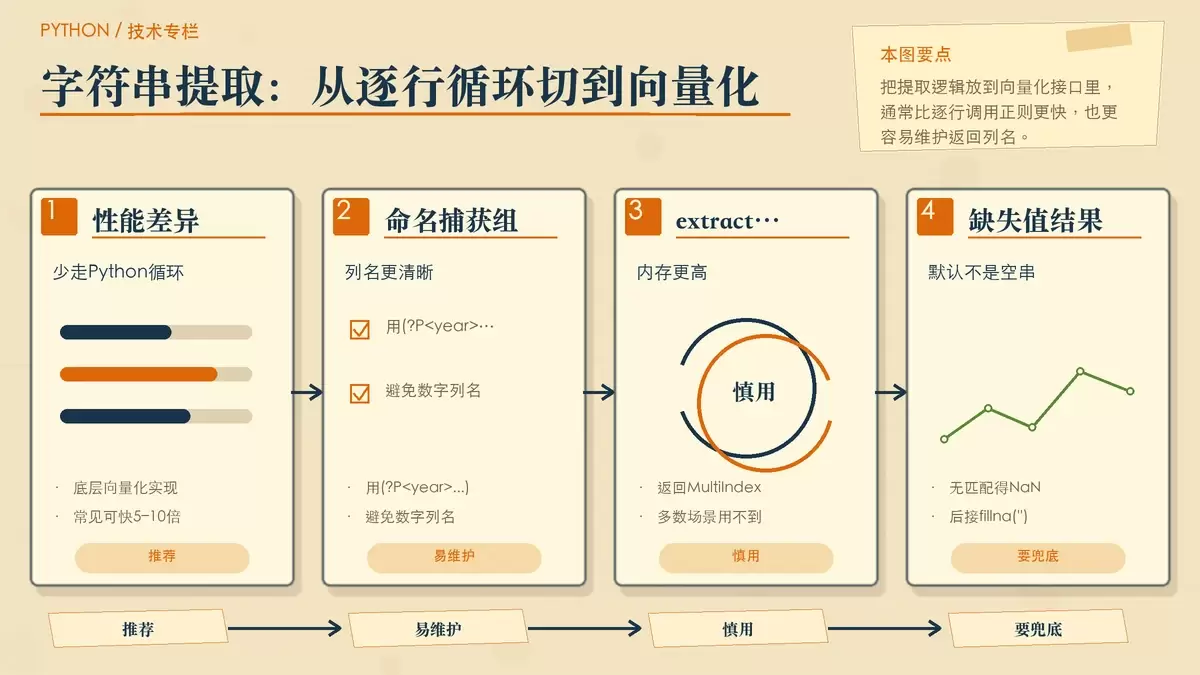
处理百万级字符串列时,性能瓶颈往往不在正则本身,而在 Python 层循环、返回结构和空值处理。本文围绕 pandas 的 `str.extract` 与 `str.replace`,梳理提取、替换、内存控制和超大规模并行处理中的关键写法与常见坑点。
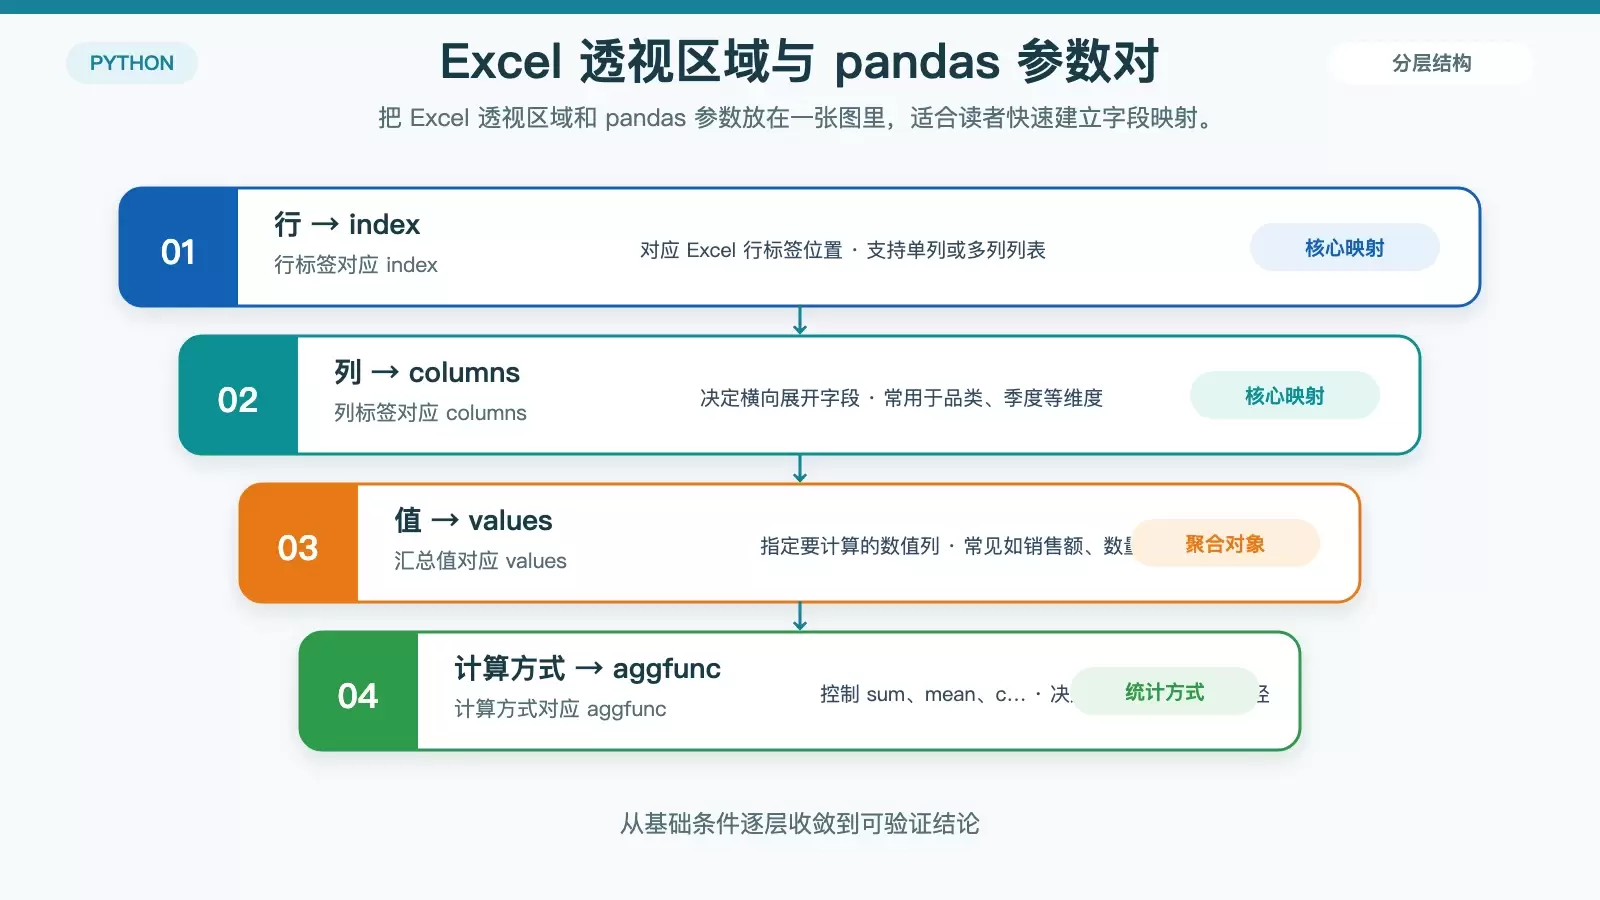
这篇文章从 Excel 用户最熟悉的数据透视表思路切入,拆解 pandas `pivot_table` 的常用参数、层级汇总和多统计值写法,再延伸到批量处理多个文件、多个 Sheet 与多报表导出的实战流程,适合拿来替代重复的手工拖拽。
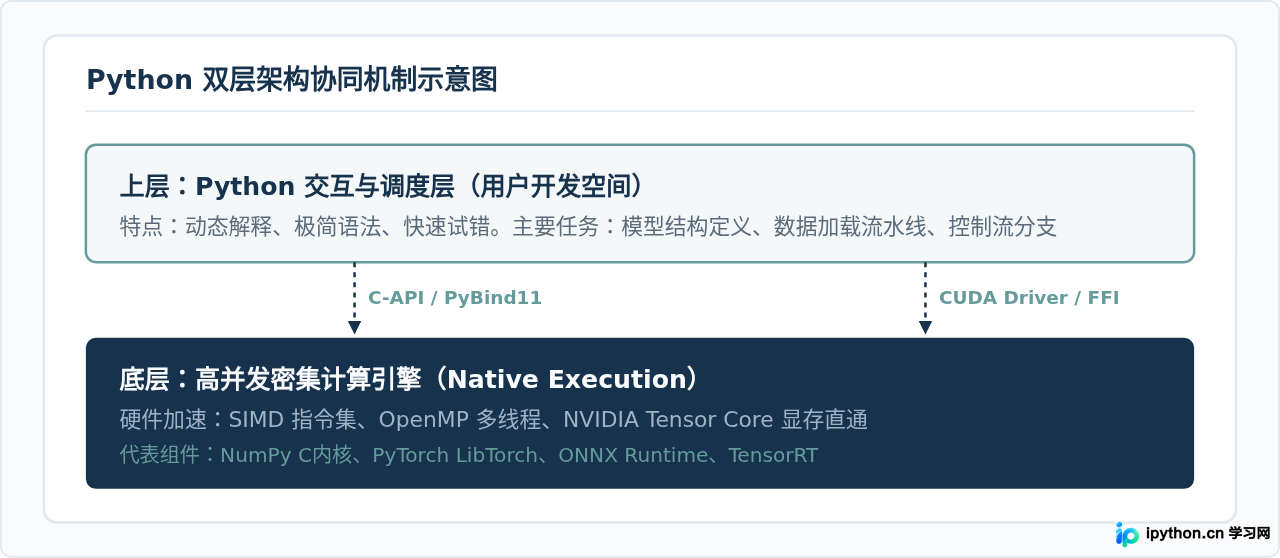
深入解析Python为何成为人工智能与数据分析领域的核心语言。从胶水语言架构、语法表达效率、生态库协同到典型应用流程与适用边界,提供详尽的技术对比与实践示例。
本文详解pandas中concatenate和combine_first的用法。concatenate用于拼接Series和DataFrame数据,支持指定轴方向;combine_first利用第二个对象填充第一个对象的缺失值。通过numpy和pandas代码示例,展示具体操作及返回结果类型。
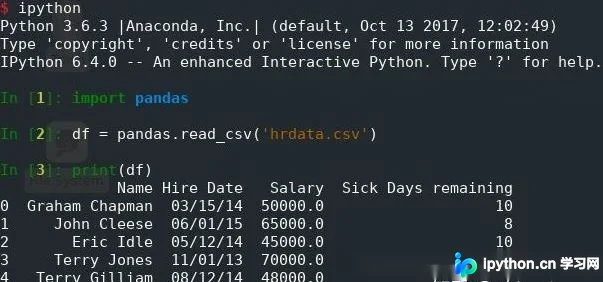
本文详细介绍如何使用 Python Pandas 库高效读取和写入 CSV 文件。涵盖基础读取方法、索引设置、日期解析、列名自定义以及数据导出等核心操作,通过具体代码示例展示 read_csv 和 to_csv 函数的关键参数用法,帮助开发者快速掌握 CSV 数据处理技巧。
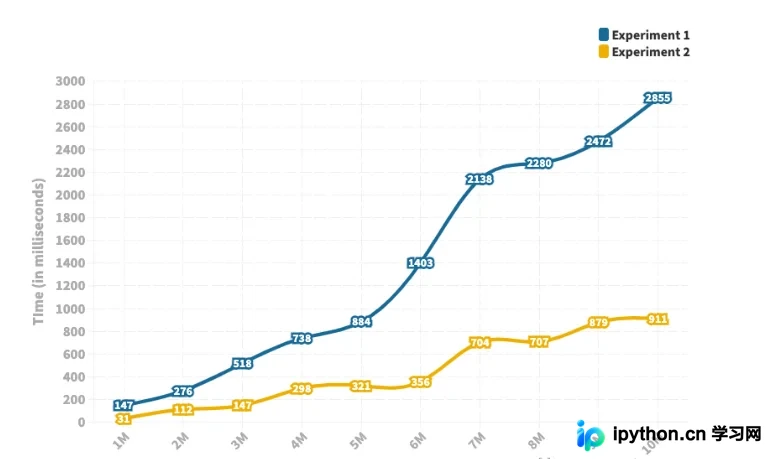
本文深入对比Pandas中Merge、Join和Concat三种数据合并方法的执行效率。通过从100万至1000万行的实验数据发现,Join操作在处理大规模数据时耗时显著低于Merge,且随数据量增长线性增加的速度更慢。建议处理海量数据时优先使用Join以提升性能。
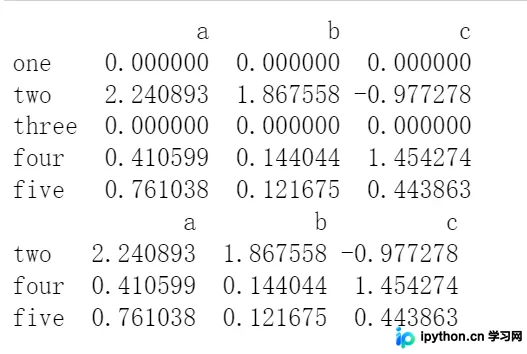
本文详细介绍在Python数据分析中删除DataFrame值为0行的多种方法。涵盖使用replace替换、loc筛选、dropna删除以及lambda函数应用,帮助开发者高效处理包含零值的数据集,提升数据预处理效率。
本文详细解析pandas中df.groupby()方法的用法。涵盖单列与多列分组、groupby对象特性,以及describe、value_counts、sum、mean、max等常用统计函数的应用。通过具体代码示例,展示如何对数值列和离散列进行组内统计,帮助读者掌握数据分组处理的核心技巧。
本文详细介绍在pandas中如何高效过滤数据集中的特定值或范围。通过isin()方法结合逻辑非操作,可精确剔除指定列的特定数值;利用逻辑与(&)运算符,能实现多列多条件的组合过滤。同时涵盖基于数值范围的筛选技巧,帮助开发者快速完成数据清洗任务。
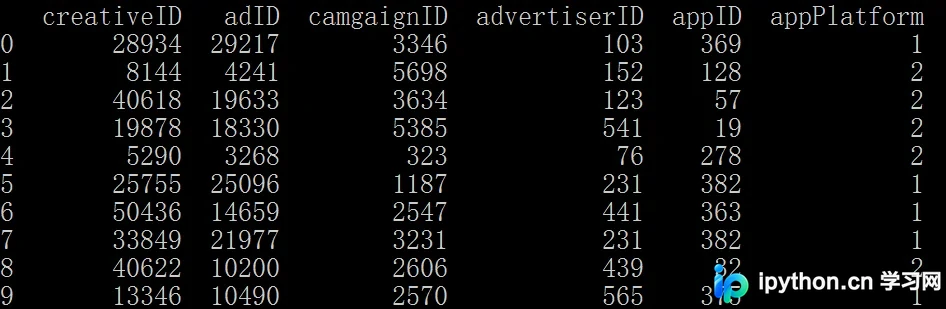
本文详细介绍 Python 中 Pandas DataFrame 的增删改查操作。涵盖按列/行添加数据、使用 loc/iloc 选取指定行列、修改标题与数值以及删除行/列的常用方法,并解析 inplace 参数对数据修改的影响,帮助开发者高效处理结构化数据。