

Python使用pandas将Excel按列拆分为多个文件

发布时间:2026-10-11| 2人浏览过
本文介绍如何使用Python的pandas库将一个Excel文件按指定列(如销售部门)拆分为多个独立的Excel文件。通过读取数据、提取分类并循环处理,将不同类别的数据分别保存为新的Excel文件,实现数据的分类管理。
Python将一个Excel拆分为多个Excel
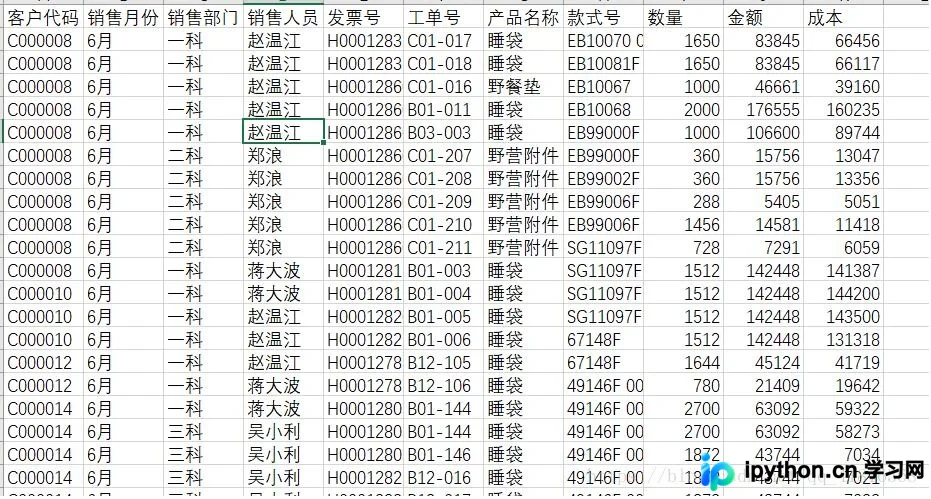
利用Python处理Excel数据时,经常需要将一个大文件按照某一列的值拆分成多个小文件。例如,将包含多个销售部门数据的Excel文件,按“销售部门”列拆分为三个独立的Excel文件,分别对应一科、二科和三科。
实现这一功能的核心在于使用 pandas 库读取数据,提取目标列的唯一值,然后遍历这些值,筛选出对应的数据行并保存为新的Excel文件。
# -*- coding: utf-8 -*-
"""
Created on Mon Jul 9 20:25:31 2018
@author: Lenovo
"""

import pandas as pd
data = pd.read_excel("E:\data1.xls")
rows = data.shape[0] #获取行数 shape[1]获取列数
department_list = []

for i in range(rows):
  temp = data["销售部门"][i]
  if temp not in department_list:
    department_list.append(temp)  #将销售部门的分类存在一个列表中

for department in department_list:
  new_df = pd.DataFrame()

  for i in range (0, rows):
    if data["销售部门"][i] == department:
      new_df = pd.concat([new_df, data.iloc[[i],:]], axis = 0, ignore_index = True)

  new_df.to_excel(str(department)+".xls", sheet_name=department, index = False)  #将每个销售部门存成一个新excel
上述代码首先读取名为 data1.xls 的Excel文件,获取其行数。接着,遍历每一行,提取“销售部门”列的值,并将其存入 department_list 列表中,确保列表中包含所有不重复的部门名称。随后,遍历 department_list 中的每个部门,创建一个空的DataFrame new_df。再次遍历原始数据,将属于当前部门的行追加到 new_df 中。最后,使用 to_excel 方法将 new_df 保存为以部门名称命名的Excel文件。
通过这种方式,可以灵活地将一个Excel文件拆分为多个Excel文件,方便后续的数据处理和分析。
以上就是Python将一个Excel拆分为多个Excel的详细内容,更多关于Python Excel拆分的数据处理资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









