pandas读取csv文件提示不存在的解决方法及原因分析
在使用pandas读取CSV文件时,常遇到“文件不存在”或编码报错。本文分析路径未指定、中文路径及编码格式三大原因,提供绝对路径调用、路径切换及指定encoding参数的具体解决代码。
2026-10-12
6

在使用pandas读取CSV文件时,常遇到“文件不存在”或编码报错。本文分析路径未指定、中文路径及编码格式三大原因,提供绝对路径调用、路径切换及指定encoding参数的具体解决代码。
本文介绍如何利用Python pandas库中的fillna方法处理数据缺失值。通过value参数指定具体填充数值,利用method参数(ffill/bfill)控制前后向自动填充方向,并结合limit参数限制最大填充行数。文章包含读取Excel、字典映射填充及限制填充行数的完整代码示例,帮助开发者高效完成数据清洗任务。
本文详细讲解pandas中ix的用法及其在0.20.0版本后的弃用原因。ix曾尝试结合loc和iloc的功能,但因其行为复杂且易引发歧义,官方建议使用iloc(基于位置)和loc(基于标签)替代。文章通过具体代码示例,展示了ix在不同索引类型下的行为,并提供了使用iloc和get_loc实现复杂切片的替代方案。
本文介绍如何使用Python的pandas库实现Excel中的数据透视表和Vlookup匹配功能。通过读取Excel文件、过滤数据、计算汇总指标,并将结果保存为新的Excel文件,展示了数据处理的基本流程。
本文介绍如何使用 Pandas 库对 DataFrame 进行按行计算百分比(比例)的操作。通过结合 `sum()` 与 `div()` 方法,并正确指定 `axis` 参数,可以快速实现数据在行维度上的归一化处理,适用于不同月份或类别数据的比例分析。
本文介绍在Python中使用pandas和sklearn将非数值数据转换为数值的方法。通过自定义函数处理类别列,并对比LabelEncoder的使用。文中指出直接操作DataFrame时的常见陷阱,如列顺序重置和字典映射逻辑,并提供基于LabelEncoder的更简洁实现方案,适用于机器学习前的数据预处理阶段。
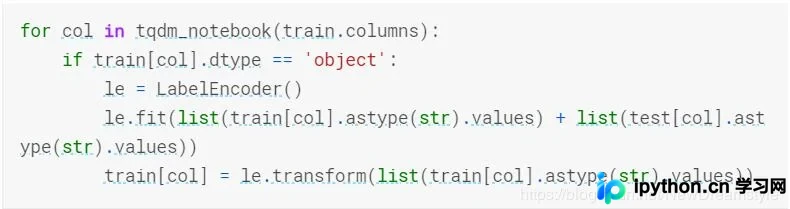
本文深入解析Pandas中的聚合与分组运算。通过groupby实现数据分组,利用内置函数(如sum、mean)进行快速统计,并掌握使用agg()执行自定义聚合逻辑。文章还演示了多函数应用、列级指定运算、结果前缀添加,以及merge与transform在数据对齐与合并中的具体操作。
本文介绍如何使用 Python 的 Camelot 库从 PDF 文件中高效提取表格数据。通过简单的几行代码,即可将 PDF 表格转换为 Pandas DataFrame,并支持导出为 CSV、Excel 等多种格式。文章涵盖安装方法及核心 API 使用示例,帮助开发者快速处理文档数据。
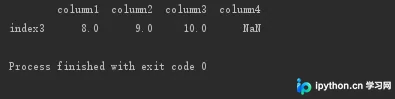
在Python数据分析中,快速定位包含空值(NaN)的行是数据清洗的关键步骤。本文介绍利用pandas库的.isnull()结合.any()方法,通过转置操作高效筛选出含有缺失值的DataFrame行,并附带完整的代码示例与结果解析。
本文介绍如何利用Pandas的skiprows和nrows参数高效读取CSV文件中特定范围的行,避免全量加载导致内存溢出。同时提供根据列值筛选并获取对应索引的方法,适用于大规模数据处理场景。
本文介绍如何使用 Python Pandas 处理数据集中的时间信息。通过 pd.to_datetime 将字符串转换为标准日期格式,利用 datetime 对象计算时间差,并提取具体的天数信息。文章涵盖日期格式解析、时间差计算及属性访问方法,帮助开发者高效处理时间序列数据。
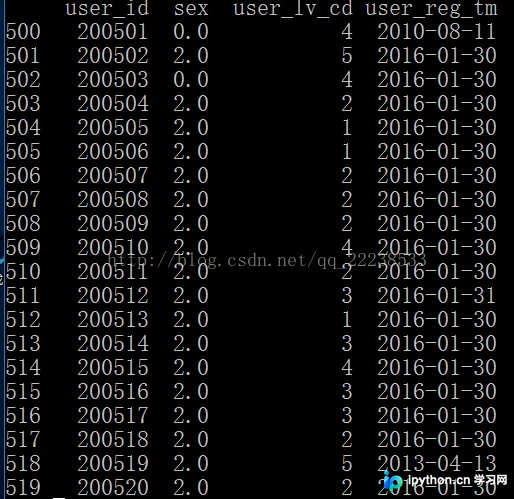
本文介绍如何使用Python Pandas库对数据集进行随机抽样。通过DataFrame.sample()方法,可以指定抽取行数(n)、比例(frac)、是否放回(replace)及权重(weights)。此外,还探讨了利用Numpy进行索引抽样的替代方案,适用于不同场景下的数据采样需求。