pandas中concatenate和combine_first的用法详解
本文详解pandas中concatenate和combine_first的用法。concatenate用于拼接Series和DataFrame数据,支持指定轴方向;combine_first利用第二个对象填充第一个对象的缺失值。通过numpy和pandas代码示例,展示具体操作及返回结果类型。
2026-10-16
19

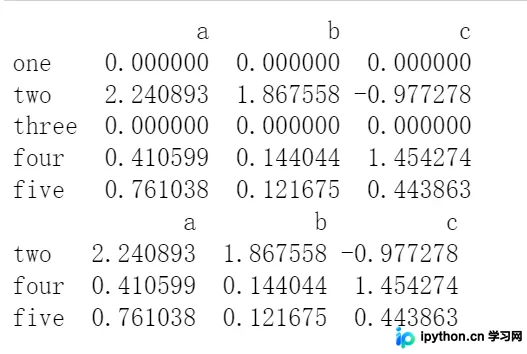
本文详解pandas中concatenate和combine_first的用法。concatenate用于拼接Series和DataFrame数据,支持指定轴方向;combine_first利用第二个对象填充第一个对象的缺失值。通过numpy和pandas代码示例,展示具体操作及返回结果类型。
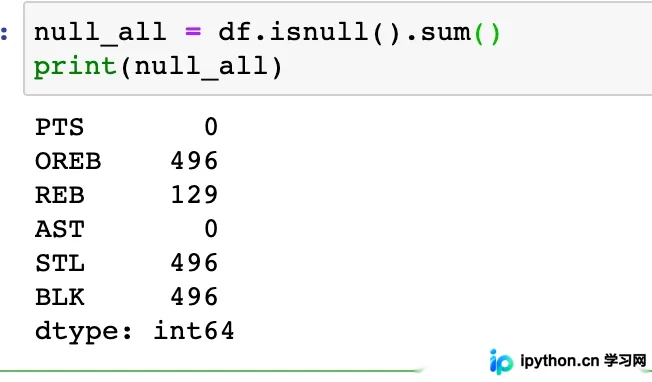
本文详解Python中处理缺失值的完整流程。从导入数据、替换异常符号为NaN开始,利用isnull()统计缺失数量。重点讲解dropna()直接删除策略(含axis、how、thresh参数)与fillna()填充策略(均值/中位数/前后向填充),并引入sklearn的KNNImputer进行基于邻居的插补,提供完整代码示例。
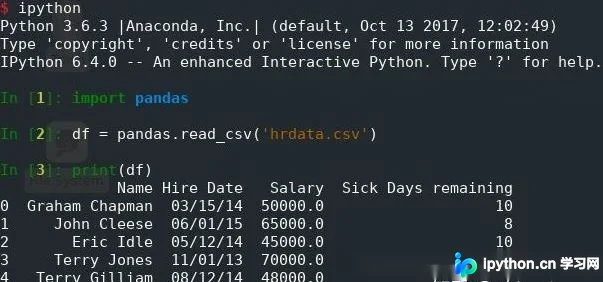
本文详细介绍如何使用 Python Pandas 库高效读取和写入 CSV 文件。涵盖基础读取方法、索引设置、日期解析、列名自定义以及数据导出等核心操作,通过具体代码示例展示 read_csv 和 to_csv 函数的关键参数用法,帮助开发者快速掌握 CSV 数据处理技巧。
本文详细解析pandas中df.groupby()方法的用法。涵盖单列与多列分组、groupby对象特性,以及describe、value_counts、sum、mean、max等常用统计函数的应用。通过具体代码示例,展示如何对数值列和离散列进行组内统计,帮助读者掌握数据分组处理的核心技巧。
本文详细介绍在Python数据分析中删除DataFrame值为0行的多种方法。涵盖使用replace替换、loc筛选、dropna删除以及lambda函数应用,帮助开发者高效处理包含零值的数据集,提升数据预处理效率。
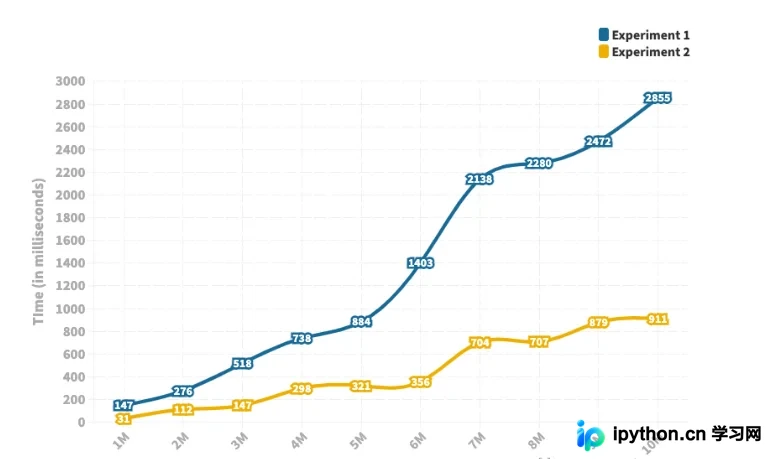
本文深入对比Pandas中Merge、Join和Concat三种数据合并方法的执行效率。通过从100万至1000万行的实验数据发现,Join操作在处理大规模数据时耗时显著低于Merge,且随数据量增长线性增加的速度更慢。建议处理海量数据时优先使用Join以提升性能。
本文详细介绍在Python中按天生成时间范围序列的三种常用方法。首先利用标准库datetime结合timedelta手动计算;其次介绍使用第三方库Arrow简化日期遍历;最后展示Pandas库中date_range和truncate函数在生成不同间隔及截断时间段序列中的高级应用,帮助开发者灵活处理日期数据。
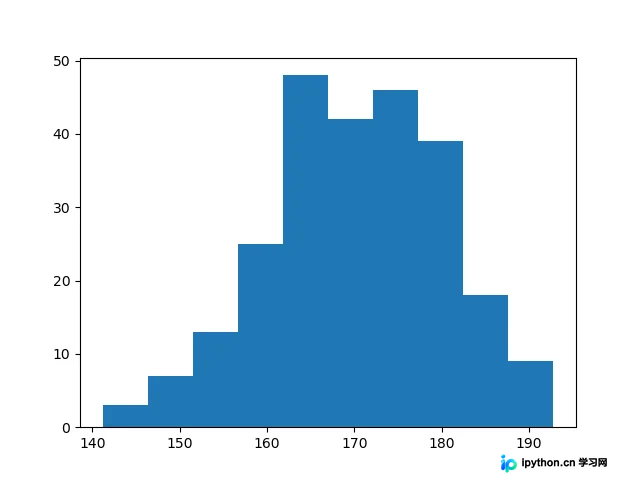
本文详细介绍在Python中生成直方图的两种主要方法。通过NumPy生成正态分布数据,分别使用Matplotlib和Pandas库绘制基础及定制直方图,展示参数设置与可视化效果,帮助读者掌握数据分布的可视化技巧。
本文介绍pandas处理Excel中超过14位数字自动转换为科学计数法的问题。提供两种解决方案:数据量小时使用to_csv替代to_excel;通用方法是在read_excel时指定dtype=str将所有数据读为字符串。此外,还讨论了将特定字段转为int类型时需先处理空值的注意事项,以避免转换错误。
本文详细介绍 Python 中 Pandas DataFrame 的增删改查操作。涵盖按列/行添加数据、使用 loc/iloc 选取指定行列、修改标题与数值以及删除行/列的常用方法,并解析 inplace 参数对数据修改的影响,帮助开发者高效处理结构化数据。
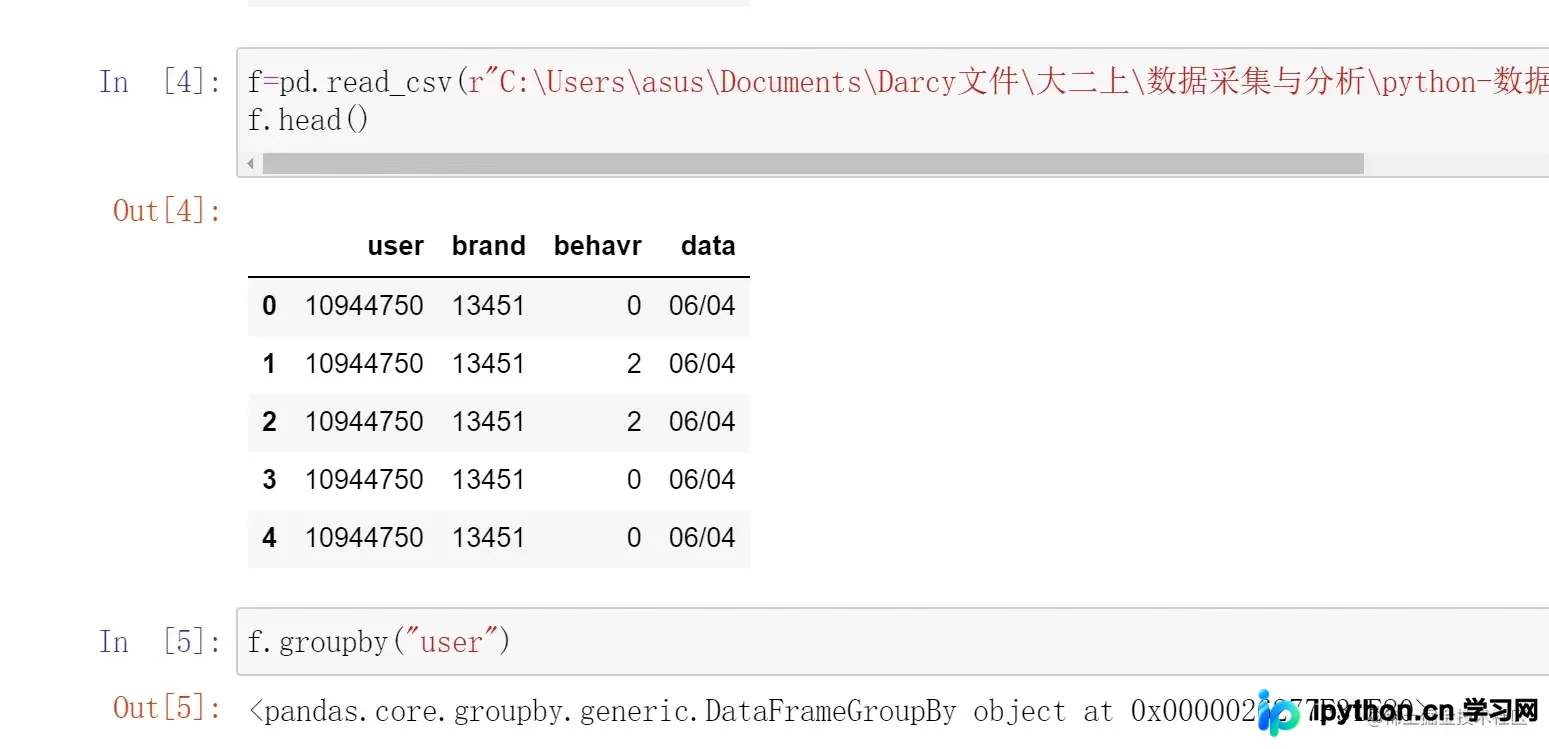
本文详解Pandas中groupby函数的核心用法,通过电商行为数据实例,演示如何按用户或商品分组统计浏览量与购买量。重点讲解利用Series除法计算商品转化率、处理缺失值(NaN)及排序提取Top N商品的方法,帮助读者快速掌握分组聚合技巧。
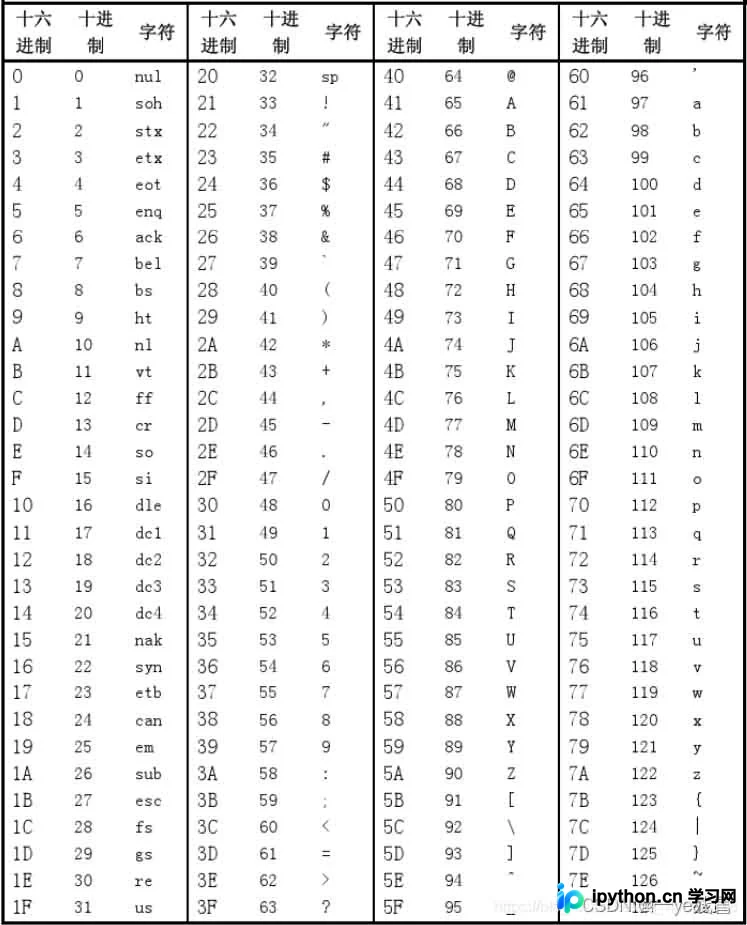
本文介绍Python中查看数据类型的常用方法,涵盖Numpy数组与Pandas数据框的类型判断。重点解析bytes、bytearray与string的区别,演示数字、ASCII及汉字在bytes类型下的创建、转换、切片与迭代操作,帮助开发者准确处理二进制数据。