

pandas中df.groupby()方法深入讲解
本文详细解析pandas中df.groupby()方法的用法。涵盖单列与多列分组、groupby对象特性,以及describe、value_counts、sum、mean、max等常用统计函数的应用。通过具体代码示例,展示如何对数值列和离散列进行组内统计,帮助读者掌握数据分组处理的核心技巧。
2026-10-16
10

本文详细解析pandas中df.groupby()方法的用法。涵盖单列与多列分组、groupby对象特性,以及describe、value_counts、sum、mean、max等常用统计函数的应用。通过具体代码示例,展示如何对数值列和离散列进行组内统计,帮助读者掌握数据分组处理的核心技巧。
本文详解Pandas中groupby函数的核心用法,通过电商行为数据实例,演示如何按用户或商品分组统计浏览量与购买量。重点讲解利用Series除法计算商品转化率、处理缺失值(NaN)及排序提取Top N商品的方法,帮助读者快速掌握分组聚合技巧。
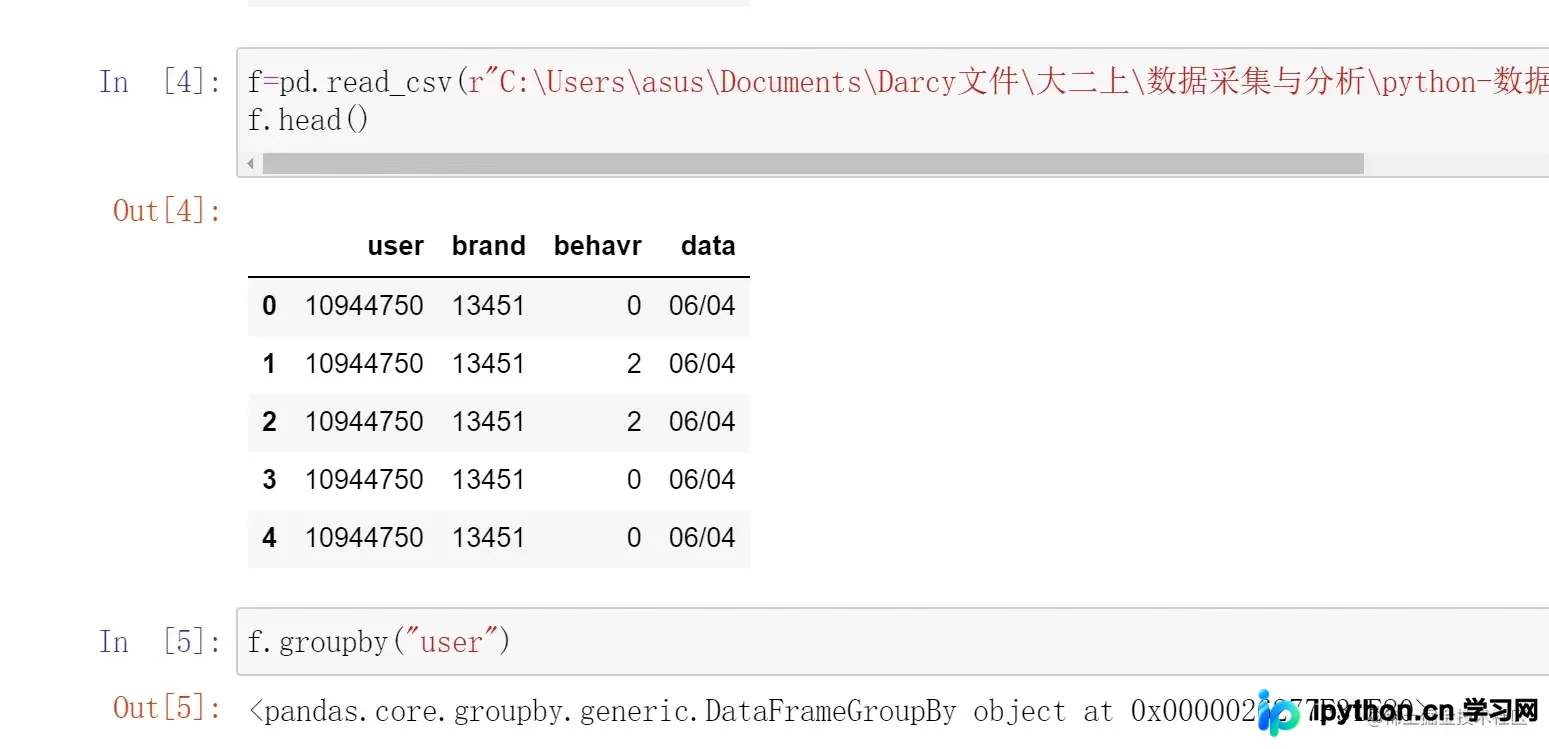
本文详解Pandas中groupby的核心用法,涵盖单列与多列分组、多种聚合函数应用及自定义聚合。通过遍历groupby对象深入理解执行流程,并结合北京天气数据实例,演示如何计算月度最高温、均质指数等统计指标,帮助开发者掌握高效的数据分组处理技巧。
本文深入解析Python Pandas库中groupby函数的核心原理与使用方法。涵盖分组键类型、axis参数设置,详细演示mean、count、size等聚合函数的应用,以及通过agg和apply实现复杂自定义聚合。结合代码实例,讲解多列聚合、字典映射操作及实际数据处理场景,帮助开发者高效掌握数据分组与统计技巧。
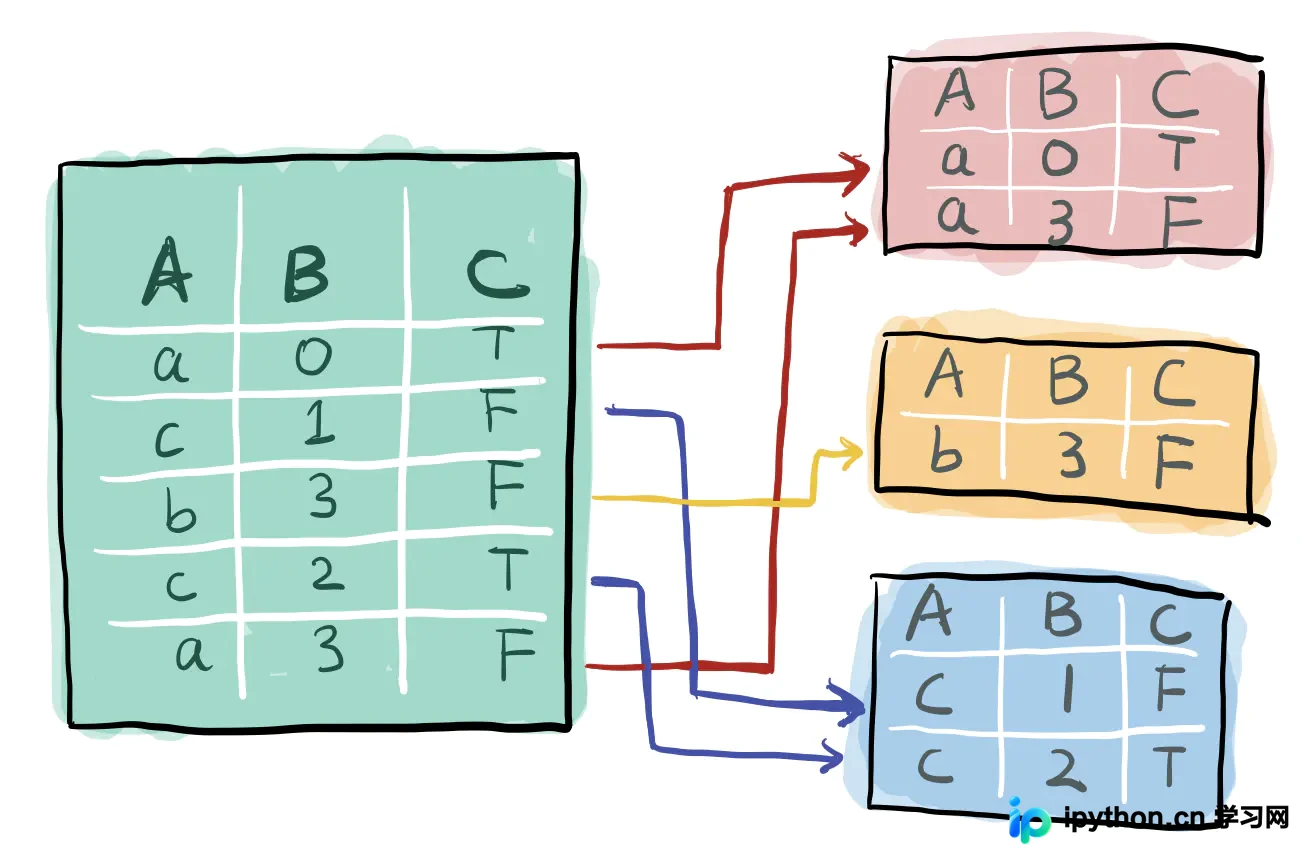
本文详细介绍Pandas中DataFrame的核心用法,涵盖从创建、索引选取、行列删除到数学运算与Groupby聚合的完整流程。通过具体代码示例,解析如何处理多维数据、执行映射与聚合操作,并演示导出CSV文件的注意事项,助力高效进行Python数据分析。
本文介绍如何在Python中使用pandas的groupby函数结合apply和lambda提取每组数据的最大值与最小值。通过异或逻辑筛选极值,并演示如何重置索引及导出Excel,解决直接groupby无法保留完整行的问题。
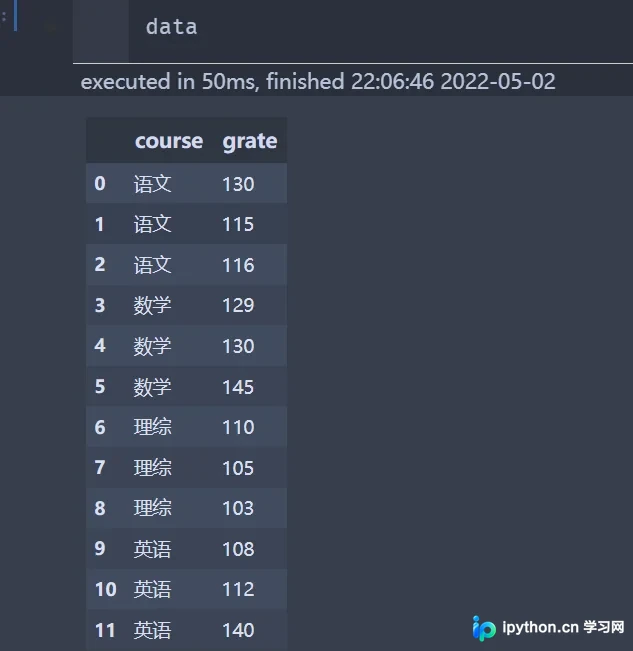
本文详解pandas库中pd.groupby()函数的用法。通过与SQL groupby对比,阐述其核心逻辑,并结合城市天气数据示例,展示如何按城市分组统计温度与风速,帮助读者掌握数据聚合技巧。
本文详细介绍Python Pandas库中agg函数的使用方法。通过groupby进行分组后,利用agg执行sum、min、max等聚合运算,支持单列或多列多函数聚合,并可自定义聚合函数。文章涵盖列名修改、reset_index重置索引等关键步骤,帮助开发者高效完成数据分析中的聚合任务。
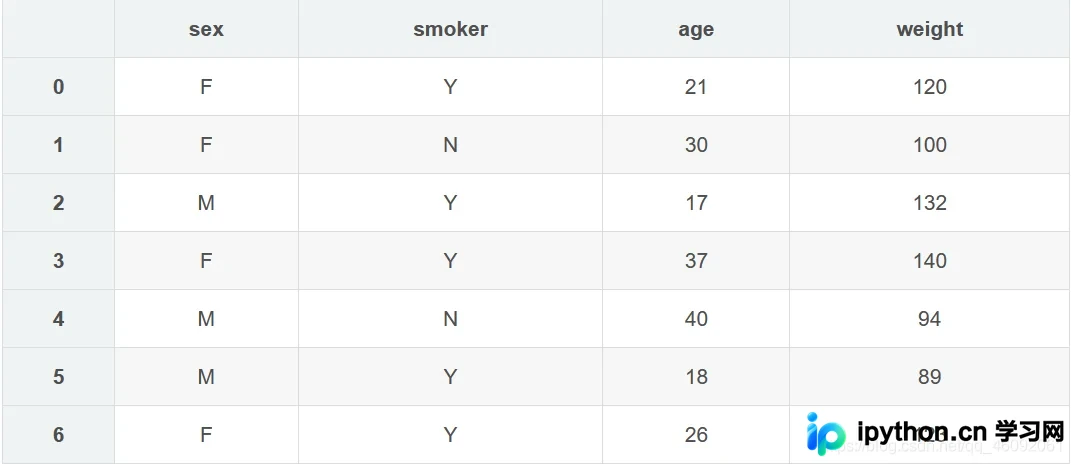
本文详细介绍Python中Pandas库DataFrame数据分组统计的核心函数groupby()。内容涵盖基础的一级与多级分类求和、指定列索引统计、分组数据迭代遍历,以及结合agg()函数实现多列不同聚合计算和自定义函数应用。此外,还演示了如何利用字典和Series对象进行灵活分组,帮助开发者高效处理复杂数据分析任务。
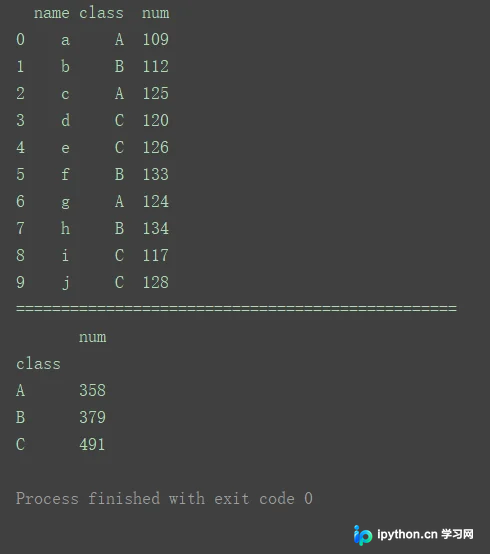
本文介绍如何在pandas中实现类似SQL row_number()的组内排序与排名功能。通过groupby结合rank或apply排序方法,可为DataFrame指定列按分组添加序号。示例涵盖薪资与班级得分场景,提供多种实现代码及注意事项,帮助开发者高效处理分组数据。
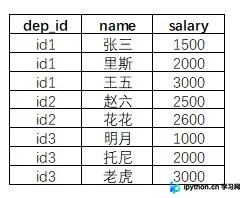
本文详细介绍在Python中使用Pandas库创建数据透视表的三种核心方法:groupby结合agg、crosstab函数以及pivot_table函数。通过对比各方法的参数设置与适用场景,结合贷款违约率分析的实际案例,展示如何高效进行多维数据交叉统计与汇总。
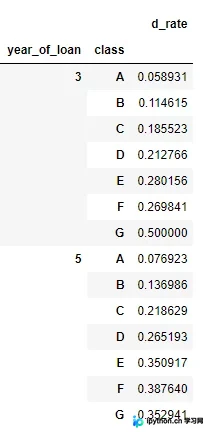
本文详细介绍Python Pandas库中groupby分组函数与agg聚合函数的使用方法。通过具体代码示例,演示如何按单列或多列进行分组统计,包括计算均值、标准差及自定义聚合。同时讲解如何利用transform保持原始索引结构,以及如何利用cut进行数据分箱分组,帮助开发者高效处理复杂数据分析任务。