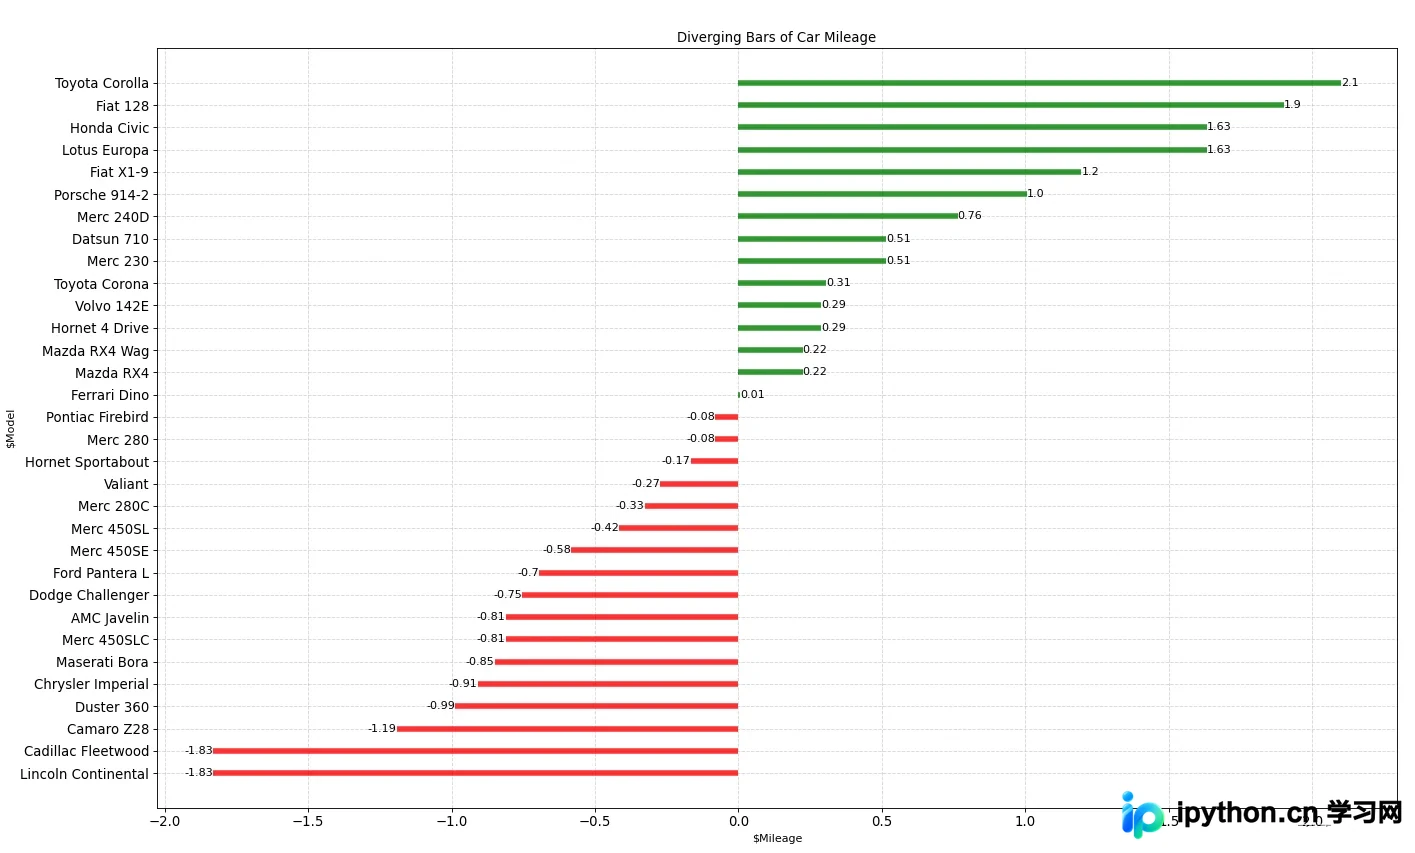
Python数据可视化实战:发散柱状图、误差阴影时序、双轴时序与金字塔图详解
本文详细介绍四种Python数据可视化图表的实现方法。首先展示如何绘制发散型柱状图以对比指标差异;其次演示带误差阴影的时间序列图,用于展示数据波动范围;接着讲解双坐标系时间序列图的绘制技巧,实现双变量同图展示;最后介绍金字塔图的构建,适用于漏斗模型或分组差异分析。
2026-10-12
6

本文详细介绍四种Python数据可视化图表的实现方法。首先展示如何绘制发散型柱状图以对比指标差异;其次演示带误差阴影的时间序列图,用于展示数据波动范围;接着讲解双坐标系时间序列图的绘制技巧,实现双变量同图展示;最后介绍金字塔图的构建,适用于漏斗模型或分组差异分析。
本文演示如何利用 Python 的 Pandas 库快速对 Excel 数据表中的手机号进行中间四位隐藏处理。通过指定读取类型并运用字符串切片技术,可一行代码完成批量脱敏,兼顾执行效率与数据隐私安全,适用于跨系统对接前的合规数据清洗。
在数据处理中常需将多个字段整合为单列。本文演示利用Pandas结合NumPy进行条件标记,并通过字符串转换与加号运算符实现多列值合并为新列的具体流程,涵盖数据准备、核心操作与结果核对步骤,适用于日常清洗与报表输出。
本文详细介绍Pandas库中df.fillna()函数的使用方法,涵盖固定值填充、前后向填充(ffill/bfill)及基于统计量的填充策略。通过具体代码示例解析value、method、inplace等关键参数的应用,并对比df.replace()替代方案,帮助开发者高效处理数据中的缺失值。
在处理结构化数据时,常需将pandas的datetime64格式或Timestamp对象与Unix时间戳互换。本文演示如何通过pd.to_datetime与整型转换完成单条及整列数据的秒级互转,包含UTC时区处理、纳秒剥离及年月日时分秒的独立提取,附带标准库辅助方案。
本文详解如何使用Python实现邮件自动下载功能。通过对比SMTP、POP3和IMAP协议,重点讲解基于IMAP协议的邮件登录与解析。代码示例展示了如何提取邮件主题、下载附件至指定路径,并解析HTML正文保存为文本文件,同时提及利用Pandas处理表格附件,提供完整的类封装与运行逻辑。
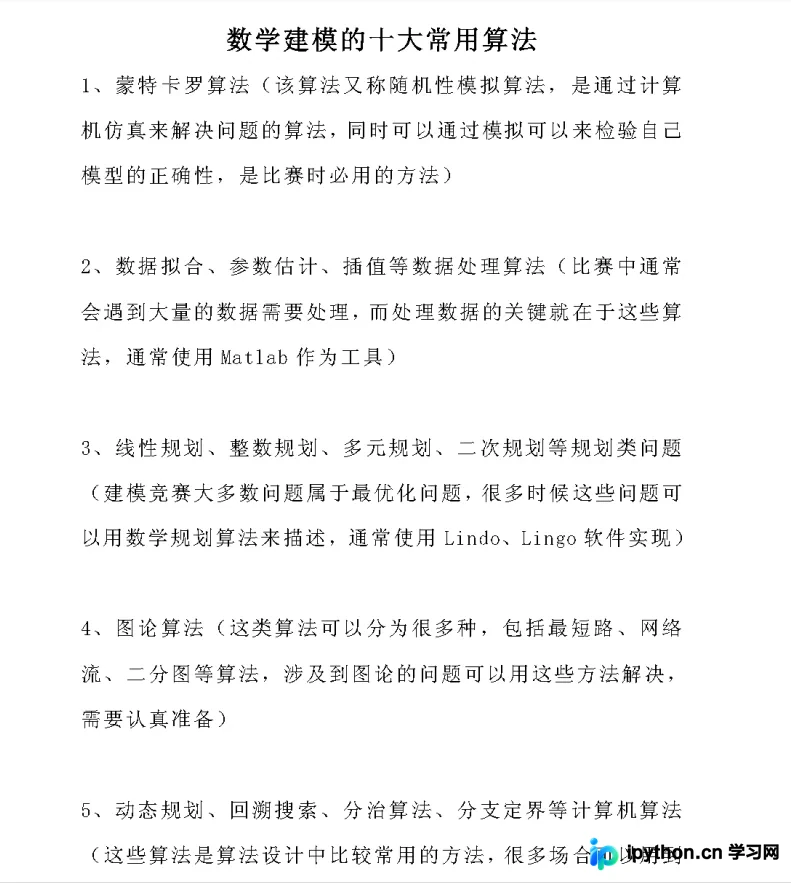
本文系统梳理Python数学建模核心知识,详解预测、优化、评价三大模型及十大常用算法。结合Pandas库实战,演示CSV/Excel读取、Series与DataFrame数据结构操作,涵盖单值、批量、区间及条件查询技巧,并解决数据类型转换等常见报错,助力掌握建模与数据处理全流程。
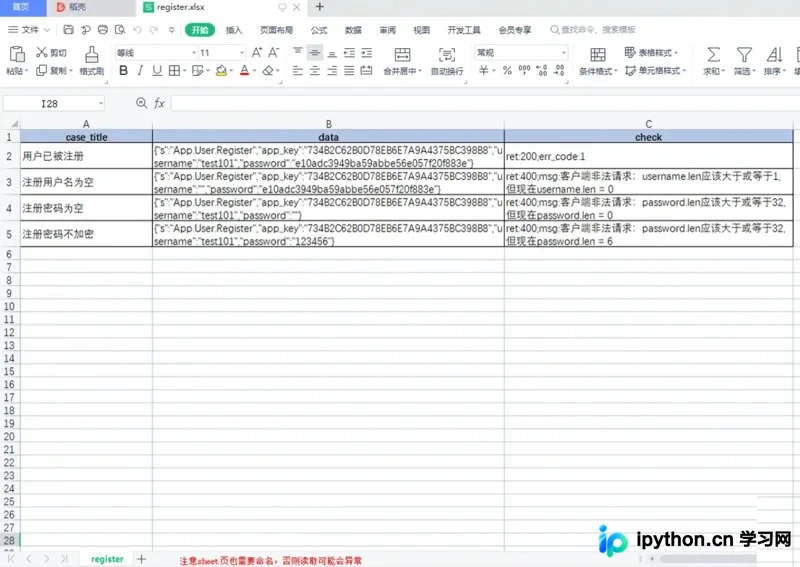
本文总结Python接口自动化测试中三种主流用例数据读取方法:xlrd、pandas和yaml。通过注册接口示例,详细解析各库的代码实现与优缺点。xlrd适合小规模数据,pandas擅长处理大型表格,而yaml凭借高可读性和模块隔离性成为复杂场景优选。文章提供完整代码片段及注意事项,帮助测试人员根据项目规模选择最佳方案。
本文详解pandas库中用于时间序列解析的核心函数pd.to_datetime()。通过具体案例展示如何灵活处理字符串、字典及混合类型数据,深入解析format格式化参数、errors容错机制、unit单位转换及origin基准点设置,帮助开发者高效完成各类复杂时间数据的标准化转换。
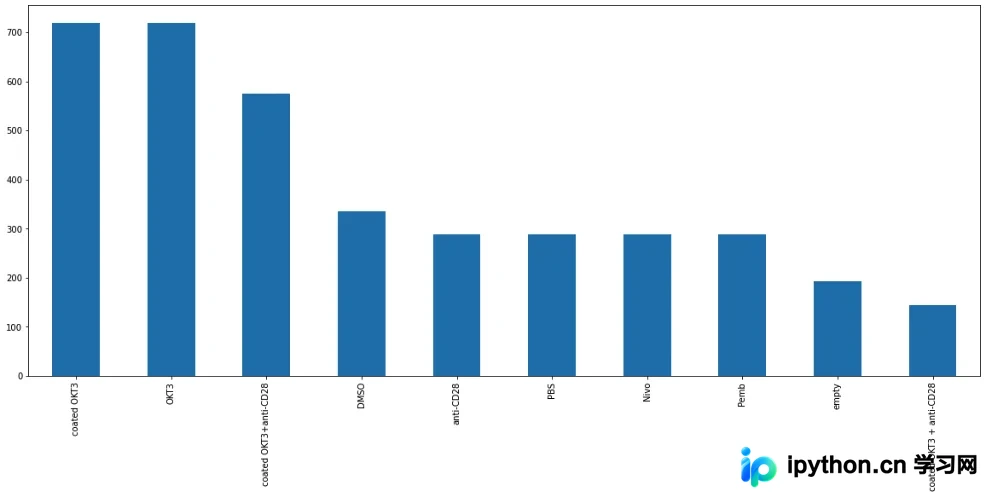
本文详细介绍使用Python Pandas处理CSV文件的标准工作流。针对中文编码导致的读取报错提供解决方案,演示如何利用value_counts统计频次、loc进行精确筛选、iterrows逐行遍历,并结合Matplotlib完成柱状图与直方图绘制,助力快速实现结构化数据的清洗与可视化分析。
在无法提前知晓CSV文件结构或存取规则的情况下,按需提取特定行或列的数据是常见的数据处理需求。本文演示了两种Python实现方式:通过内置文件操作逐行分割获取原始行与首列内容,以及借助pandas库结合索引位置与列名精准定位数值。掌握这两种方法可快速应对各类CSV数据的结构化提取场景。
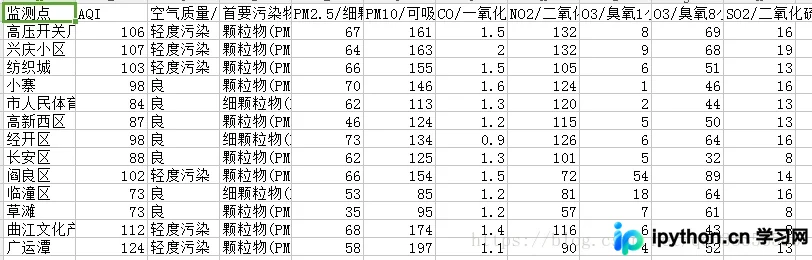
Pandas中count()与value_counts()常用于数据统计,但前者返回非空值总数,后者返回各唯一值的出现频次并默认降序排列。本文详解两者的参数配置、代码示例及核心区别,帮助开发者快速匹配数据清洗与分析场景。