scikit-learn 1.9.1 Windows 官方下载
常用 Python 机器学习算法与模型评估工具库。
2026-10-19
12


本文详细解析Python中numpy.argmax()函数的用法。通过一维、二维及三维数组的示例,深入讲解axis参数(0和1)如何影响最大值索引的返回结果。该函数在机器学习分类结果获取及精确度计算中应用广泛,帮助开发者准确理解数组维度的变化与索引对应关系。
本文深入解析Python中scipy.optimize模块的核心函数minimize。详细列举BFGS、Nelder-Mead等常用算法,并逐一说明fun、x0、jac、args等关键参数的含义与用法。通过逻辑回归损失函数优化的完整代码示例,展示如何获取最优权值及收敛状态,帮助开发者高效进行多元函数无约束最小化计算。
本文详细解析基于Python sklearn库的决策树分类方法。内容涵盖决策树的基本结构、ID3/C4.5/CART算法原理及特征选择准则,并通过完整代码示例演示如何利用Scikit-learn构建、训练及可视化决策树模型,适用于数据分类任务。
本文介绍了五个使用Python进行数据清理的实用脚本,涵盖从PDF提取表格、合并多个CSV文件、删除重复行、拆分列以及合并不同数据集等常见场景。通过Pandas库实现自动化处理,显著提升机器学习前的数据准备效率,适用于Tableau等可视化工具及各类模型训练前的数据预处理环节。
本文详细介绍Python中层次聚类算法的原理与实现。涵盖自下而上与自上而下两种策略,解析完全链接、单链接、平均链接及质心链接等距离度量方法。结合SciPy库代码示例,演示如何使用Ward法生成树状图,并指导通过树状图确定最优聚类数量。
本文深入解析Python numpy库中np.random.seed()函数的核心机制与使用场景。通过对比实验,验证随机数种子对后续随机数生成的持续性影响,并探讨不同参数值如何确定随机序列的起始位置。文章指出种子参数仅作用于其定义后的下一次随机数生成,帮助开发者在机器学习和深度学习实验中实现结果的可复现性。
本文基于Python展示传统机器学习在行人检测中的应用流程。通过skimage库提取HOG特征向量,分别训练决策树、随机森林和SVM模型。文章详细记录了数据预处理、特征提取、模型训练及性能对比(精确率、召回率、F1值)的全过程,并展示了SVM在测试中的最佳表现,旨在提供完整的机器学习检测实践参考。
本文介绍在Pandas DataFrame计算中产生inf(无穷大)值的原因及处理方法。通过Numpy库提供的isinf、isposinf等函数定位inf位置,并演示如何将Series或整个DataFrame中的正负无穷大替换为指定数值或NaN,以适配机器学习算法对数据完整性的要求。
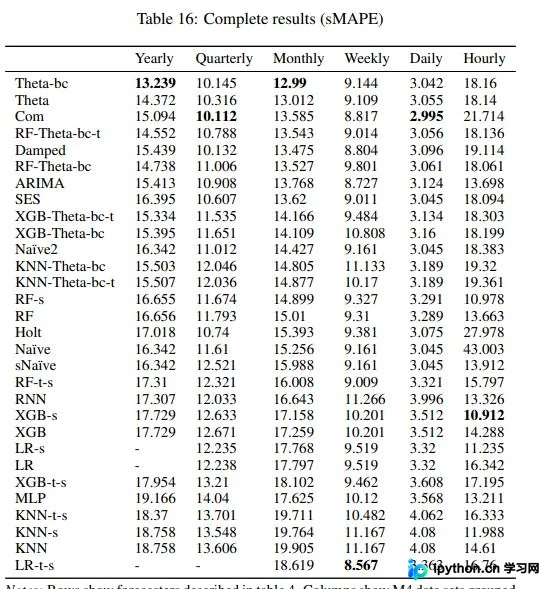
本文介绍如何使用Python中的LazyProphet库结合LightGBM进行高效的时间序列预测。通过特征工程如傅里叶基函数和滞后值,该模型在M4数据集上超越了传统树模型基准,且无需复杂调参即可实现快速建模与预测,适合高频大数据场景。
本文介绍如何使用Python实现多元线性回归,重点讲解梯度下降算法。通过定义代价函数与偏导数计算,迭代更新参数theta0、theta1和theta2。示例展示从数据读取、模型训练到可视化拟合平面的完整流程,1000次迭代后损失值显著降低,适用于机器学习入门与模型部署参考。
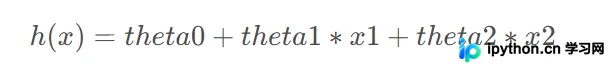
本文详解Python中遍历读取目录的两种常用方法:os.listdir与os.walk。os.listdir仅获取当前层级文件列表,而os.walk可递归遍历所有子目录。文章通过具体代码示例对比两者返回值差异,并提供了支持多后缀过滤、递归/非递归选项的完整封装函数,帮助开发者高效处理机器学习或深度学习中的文件读取需求。