

Pandas中多列数据合并为一列的实现方法

在数据处理中常需将多个字段整合为单列。本文演示利用Pandas结合NumPy进行条件标记,并通过字符串转换与加号运算符实现多列值合并为新列的具体流程,涵盖数据准备、核心操作与结果核对步骤,适用于日常清洗与报表输出。
多列合并的核心思路
当需要将DataFrame中的多个列(如不同科目的成绩评级)聚合为单一文本字段时,直接相加会导致类型冲突。解决该问题的标准做法是先统一转换为字符串类型,再使用+进行逐元素拼接。以下将展示从原始数据构建到最终合并的完整操作链。
第1步:构造示例数据并生成条件字段
目的:建立包含多列数值的基础表格,并依据阈值划分等级标记。
入口与动作:导入基础库,初始化DataFrame,调用np.where按学科设定达标标记。
参数与配置:定义语数英三科成绩列表,索引命名为姓名序列;阈值统一设定为60分。
import pandas as pd
import numpy as np

df = pd.DataFrame(data={'语文':[50,90,70,78,60],
                        '数学':[59,80,60,75,69],
                        '英语':[61,95,65,80,59]},
                  index=['Harry','Andy','Rita','Lee','Jack'])

# 添加各科是否达标标记,大于60分显示√,否则显示×
df['语文评级'] = np.where(df['语文'] > 60,'√','×')
df['数学评级'] = np.where(df['数学'] > 60,'√','×')
df['英语评级'] = np.where(df['英语'] > 60,'√','×')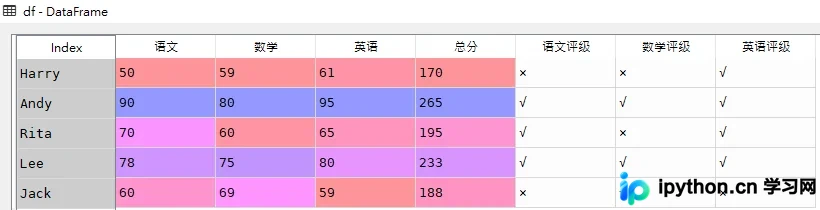
第2步:将多列评级合并为单列文本
目的:消除重复的评级列,将所有科目评价集中至同一字段以便导出或进一步分析。
入口与动作:选取目标评级列,执行类型映射转字符串后叠加。
参数与完成状态:使用.map(str)确保参与运算的对象强制转为字符型,通过连续加号连接,新列命名'评级合并'。执行后表结构将多出该独立字符串列。
# 将多列合并为一列,生成'评级合并'字段
df['评级合并'] = df['语文评级'].map(str) + df['数学评级'].map(str) + df['英语评级'].map(str)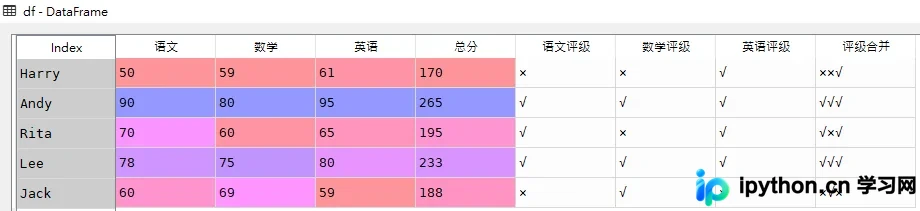
完成判断与常见异常排查
执行合并后,建议直接打印表头或调用print(df.head())确认字段是否成功追加。若控制台抛出TypeError,通常是因为源列仍保留为数值或类别型数据类型,此时需先用.astype(str)或.map(str)进行全局强转。另外需注意,该加法拼接仅针对同行内的横向逐列合并有效,若需跨行聚合或去除空值分隔符,应改用apply(lambda x: "|".join(x.dropna()), axis=1)等方案。
简要总结
以上就是Pandas多列值合并成一列的详细实现流程,核心在于统一字符类型后利用基础运算符完成横向拼接。掌握此模式可显著提升多维度标签的整理效率。以上就是关于Pandas多列合并操作的详细内容,更多关于Python DataFrame数据清洗的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









