

Python 3.x读取CSV数据提取任意行与列的完整方法

发布时间:2026-10-12| 2人浏览过
在无法提前知晓CSV文件结构或存取规则的情况下,按需提取特定行或列的数据是常见的数据处理需求。本文演示了两种Python实现方式:通过内置文件操作逐行分割获取原始行与首列内容,以及借助pandas库结合索引位置与列名精准定位数值。掌握这两种方法可快速应对各类CSV数据的结构化提取场景。
利用原生文件操作提取首行与首列
当依赖环境受限或仅需轻量级读取时,Python内置的open与readlines足以完成基础行列分离。核心逻辑是将文件内容按行切分后,使用逗号进行二次拆分。
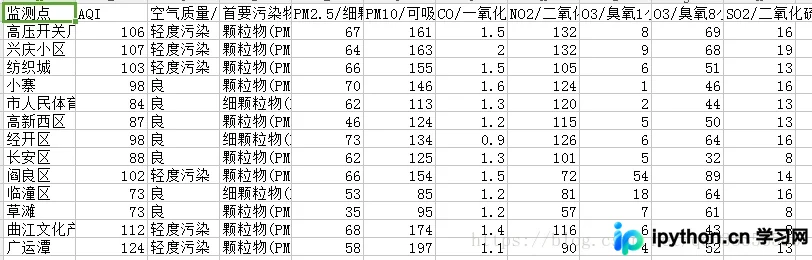
实现代码与参数说明
file = open('data.csv', 'r')
lines = file.readlines()
file.close()

rows = []  # 存储所有行列表
columns = []  # 存储提取的首列数据

for line in lines:
    rows.append(line.strip().split(','))  # 去除末尾换行符并按逗号分割

print(rows[0])  # 输出第一行(通常为表头)
for col_row in rows:
    if len(col_row) > 0:
        columns.append(col_row[0])  # 收集每行的第一个字段

print(columns)  # 输出所有行的第一列数据
预期输出结果
执行上述脚本后,控制台将依次打印表头列表与指定列数据集合:
- 首行数据:
['监测点', 'AQI', '空气质量/指数类别', '首要污染物', 'PM2.5/细颗粒物', 'PM10/可吸入颗粒物', 'CO/一氧化碳', 'NO2/二氧化氮', 'O3/臭氧1小时平均', 'O3/臭氧8小时平均', 'SO2/二氧化硫'] - 首列数据:
['监测点', '高压开关厂', '兴庆小区', '纺织城', '小寨', '市人民体育场', '高新西区', '经开区', '长安区', '阎良区', '临潼区', '草滩', '曲江文化产业集团', '广运潭']
使用Pandas库进行精准行列定位
对于规模较大或结构复杂的CSV文件,推荐直接使用pandas模块。该库内置了高效的内存布局与向量化操作,支持通过整数位置索引(.iloc)或列名称([])直接访问目标数据。
import pandas as pd

# 1. 加载CSV文件为DataFrame对象
df = pd.read_csv("filename.csv")
print(df.head())

# 2. 基于位置索引提取单行
print("指定行数据:", df.iloc[1])

# 3. 基于列名提取整列
print("指定列数据:", df["item_id"])

# 4. 交叉定位某行某列的具体值
print("行列交叉值:", df.iloc[1]["item_id"])在实际业务中,pd.read_csv会自动处理编码识别与缺失值标记。若文件存在非标准编码或自定义分隔符,可在初始化时传入encoding='utf-8-sig'或sep='\t'等参数以避免解析错位。完成读取后,结合切片逻辑即可满足任意维度数据的抽取需求。
以上就是Python读取并提取CSV文件任意行与列内容的详细内容,更多关于Python数据处理与自动化分析的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









