如何在Python中使用openpyxl库读写.xlsx文件
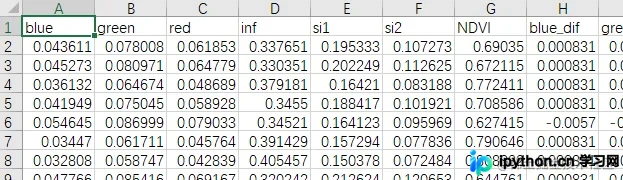
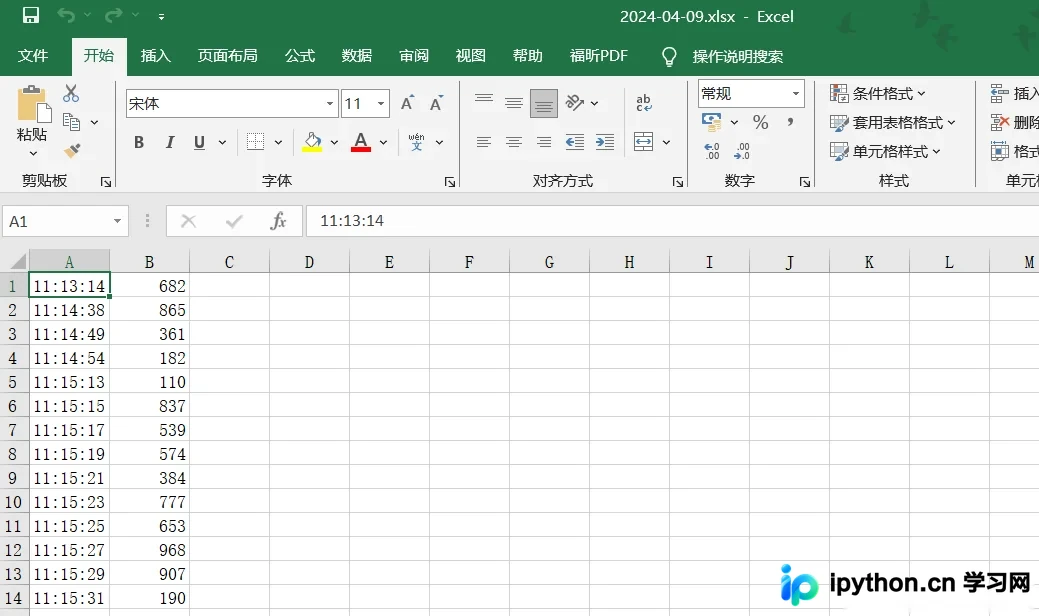
本文详解如何使用Python的openpyxl库高效读写.xlsx格式文件。涵盖环境安装、工作簿加载、单单元格读写、整行遍历、增量数据写入及避免覆盖原文件的保存技巧,并提供实时记录数据的实战代码示例,助你快速掌握Python表格数据处理流程。
2026-10-11
6

本文详解如何使用Python的openpyxl库高效读写.xlsx格式文件。涵盖环境安装、工作簿加载、单单元格读写、整行遍历、增量数据写入及避免覆盖原文件的保存技巧,并提供实时记录数据的实战代码示例,助你快速掌握Python表格数据处理流程。
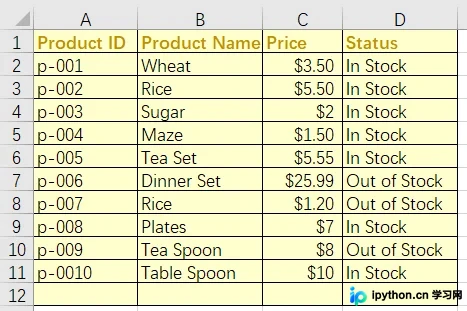
本文详细介绍在Python中将老旧的.xls文件格式转换为现代.xlsx格式的4种常用方法。通过pandas、win32com、xls2xlsx及pyexcel模块,分别演示安装步骤、核心代码与适用场景。读者可根据是否依赖Windows系统、是否需要保留单元格格式等实际需求,选择最合适的脚本方案快速完成批量转换。
本文详解在Python中利用Pandas、Numpy和Sklearn库实现数据随机打乱、抽样及分割的方法。通过plotly内置数据集演示,涵盖DataFrame的sample函数按行/列抽样、sklearn.utils.shuffle与random模块打乱索引、np.random.permutation生成随机索引,以及train_test_split进行80/20数据划分的具体代码与参数设置。
在数据处理中快速定位目标记录的具体位置是分析的前置步骤。本文介绍如何通过已知列名、未知列名及全表搜索三种场景,结合布尔索引与 .index 属性精准提取行号,并演示将标签索引转换为实际物理行号的完整代码流程,帮助开发者高效完成数据筛选与定位。
本文介绍使用Python pandas库处理包含重复行和空列的Excel文件。通过设置header=None读取数据,利用notna()生成布尔列表,并对比三种获取False索引的方法:list.index()配合count、遍历判断及enumerate。最终演示如何删除空列、提取首行作为新列名并保存结果,解决数据清洗中的常见难题。
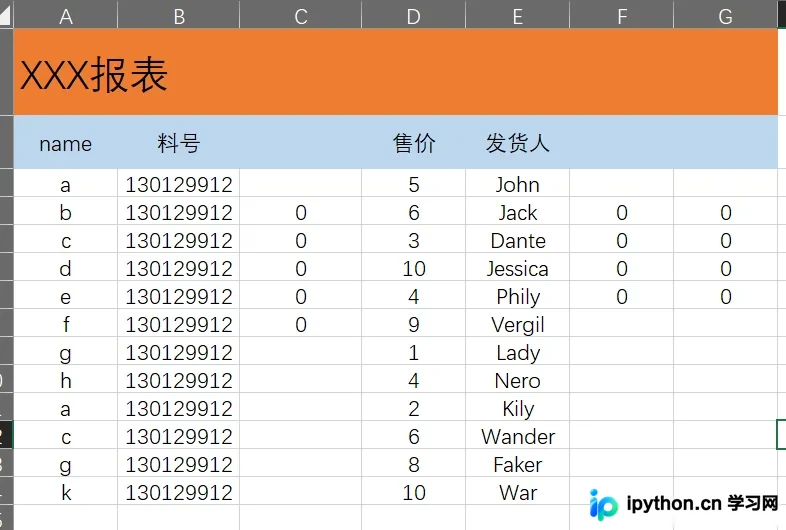
本文详解Pandas修改特定值的四种核心方法。通过对比Series的map与DataFrame的apply映射机制,演示带参函数与多列运算;结合loc按条件精准替换,以及fillna智能填充缺失值。附带完整代码示例与参数说明,助您高效完成表格数据清洗与字段转换。
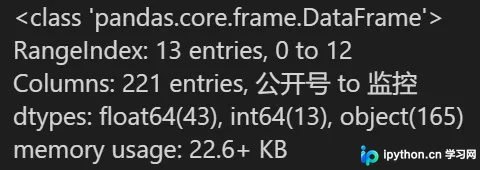
在使用Pandas进行数据探索时,常规调用info()仅显示基础摘要。通过配置verbose与null_counts参数可快速预览列数据类型与缺失数量;结合io模块的StringIO对象重定向buf参数,能将其直接转为字符串变量存储,避免控制台重复打印,大幅提升数据探查与日志记录的效率。
在使用Python进行数据分析时,经常需要从网页或配置文件中提取结构化内容。本文详细演示如何利用pandas库直接读取HTML网页表格与JSON文件数据,涵盖基础导入、数据清洗(去空值/类型转换)、统计分析方法,以及处理读取JSON时常见的“Trailing data”报错修复方案,助你快速完成数据获取与预处理工作。
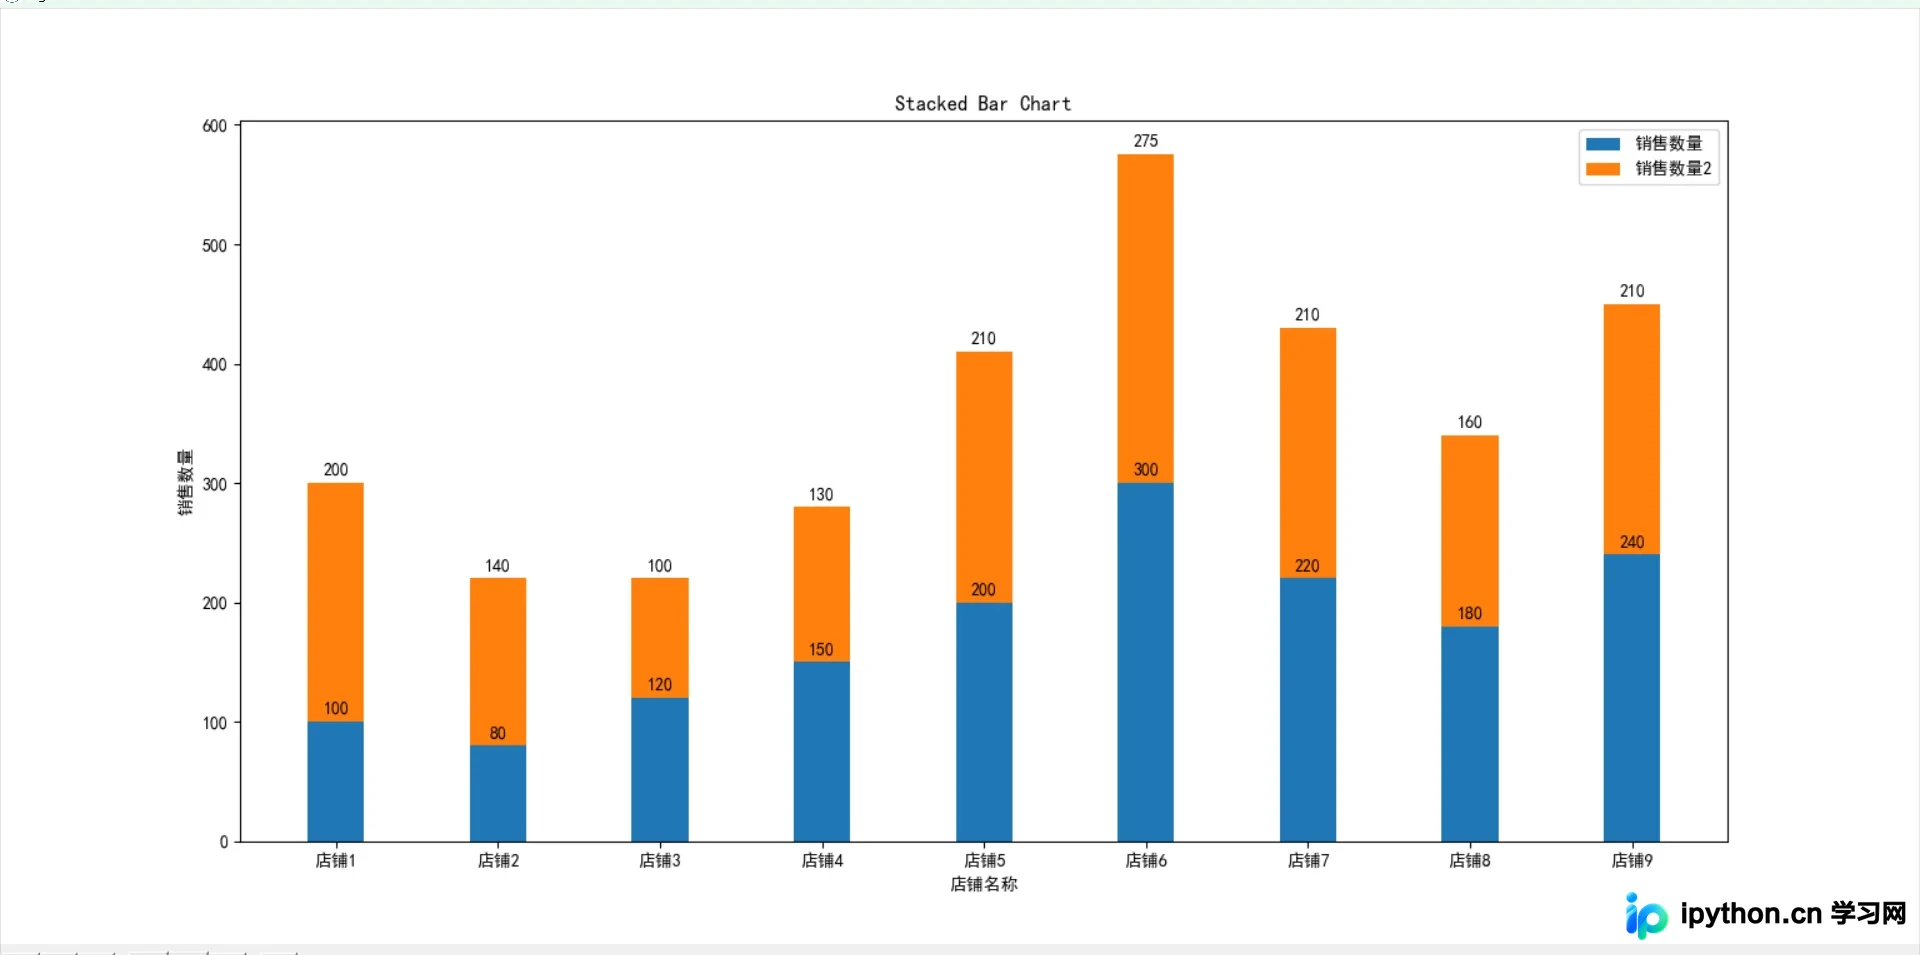
本文演示如何使用Python的pandas和matplotlib库,通过读取Excel数据绘制堆叠柱状图,直观展示各店铺的销售数量及其组成部分,适用于日常数据分析与报告制作。
本文针对Excel数据批量处理效率低的问题,提供基于Python Pandas库的标准操作流程。通过读取指定工作表与表头、过滤筛选特定行列、填补缺失值及转换日期数值类型完成数据清洗;结合分组聚合多维透视与排序排名进行核心分析;最后输出处理后的DataFrame至新文件中。掌握这些方法可显著提升数据分析自动化水平。
使用 Python 批量合并多个 Excel 工作表或按固定行数拆分大型表格是日常数据处理的常见需求。本文通过 pandas 与 xlrd/xlwt 库提供两段可直接运行的核心代码,演示如何实现多文件纵向拼接生成新 xlsx 文件,以及如何将超长 xls 表格按指定行数切割并保留原表头。
本文详细介绍如何使用Python的Pandas库读取Excel或CSV表格,通过设定各列数据的数值区间进行条件过滤。演示多条件独立筛选与批量合并筛选的代码实现,快速剔除不符合范围的异常样本行,保留核心数据并导出为新文件。