

Pandas count()与value_counts()用法及区别详解

Pandas中count()与value_counts()常用于数据统计,但前者返回非空值总数,后者返回各唯一值的出现频次并默认降序排列。本文详解两者的参数配置、代码示例及核心区别,帮助开发者快速匹配数据清洗与分析场景。
Pandas count() 与 value_counts() 功能定位
在数据处理流程中,统计行数与频次是基础操作。Series.count() 用于快速核算指定列或Series中的有效(非空)数据总量,而 Series.value_counts() 则专注于分类统计,自动计算每个唯一值的出现次数并输出频率分布。两者虽然名称相似,但返回值结构与业务含义完全不同。
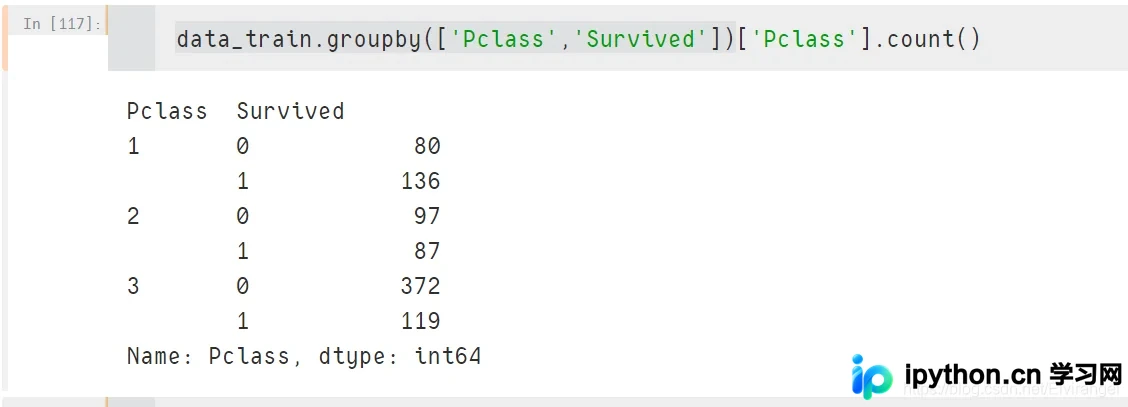
操作步骤与参数配置
第1步:调用 count() 获取非空记录数
目的:统计目标列或Series中剔除缺失值后的实际数据量,适用于快速校验数据集完整性或按列统计行数。
入口与动作:在编辑器中新建Python脚本并导入Pandas库,通过 df['列名'].count() 或直接对Series实例调用该方法。该方法仅支持 level 参数,当数据为MultiIndex层级索引时,可按指定层级聚合计数。默认行为严格忽略 NaN 值。
import pandas as pd
import numpy as np

s = pd.Series([0.0, 1.0, np.nan])
print(s.count())
# 输出:2重要参数:level(可选,层级索引深度或名称)。
可观察的完成状态:控制台输出单个整型数值,代表有效条目总数。若结合DataFrame使用,可直接读取列属性:`df['A'].count()`,等价于行数据的非空统计。
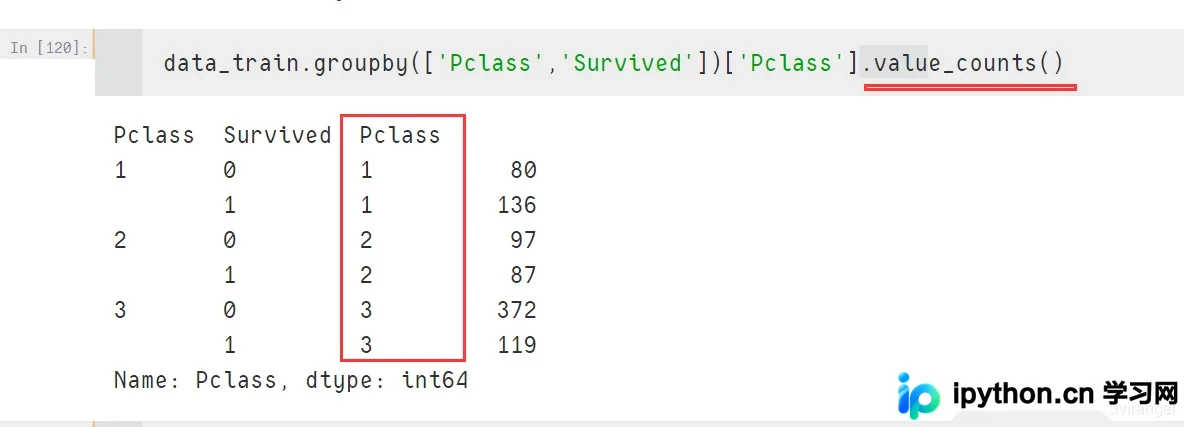
第2步:调用 value_counts() 分析类别分布
目的:查看数据集中各类别的具体占比或绝对数量,用于特征工程探索或数据质量检查。
入口与动作:在已加载的数据对象上直接链式调用 .value_counts()。注意:原草稿误写为 values_count(),正确方法名为 value_counts()。
import pandas as pd
import numpy as np

s = pd.Series([3, 1, 2, 3, 4, np.nan])
print(s.value_counts())
"""
输出为:
3.0    2
4.0    1
2.0    1
1.0    1
dtype: int64
"""重要参数:normalize(布尔值,决定是否返回相对频率)、sort(是否按频次排序)、ascending(升降序控制)及 dropna(是否排除NaN)。开启归一化统计时,各分类比例之和严格等于 1:
s.value_counts(normalize=True)
"""
输出为:
3.0    0.4
4.0    0.2
2.0    0.2
1.0    0.2
dtype: float64
"""可观察的完成状态:返回一个新的Series对象,左列为原始数据唯一值,右列为对应出现次数或占比,索引顺序按频次从高到低排列。
核心差异对比与应用场景
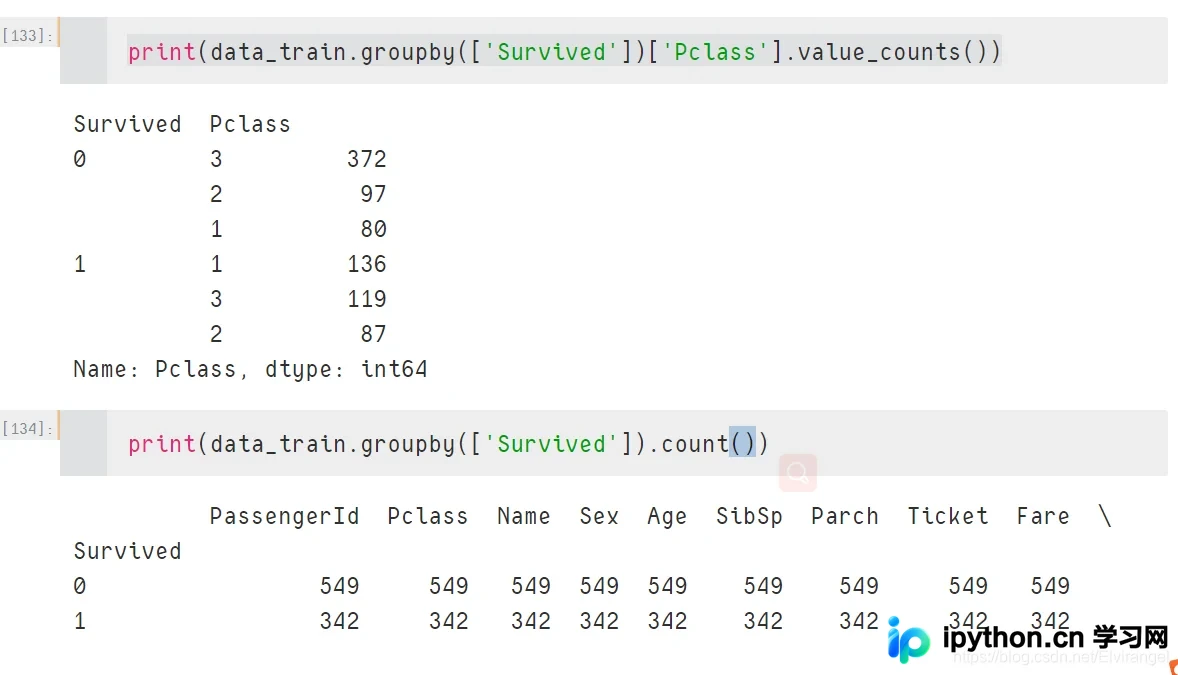
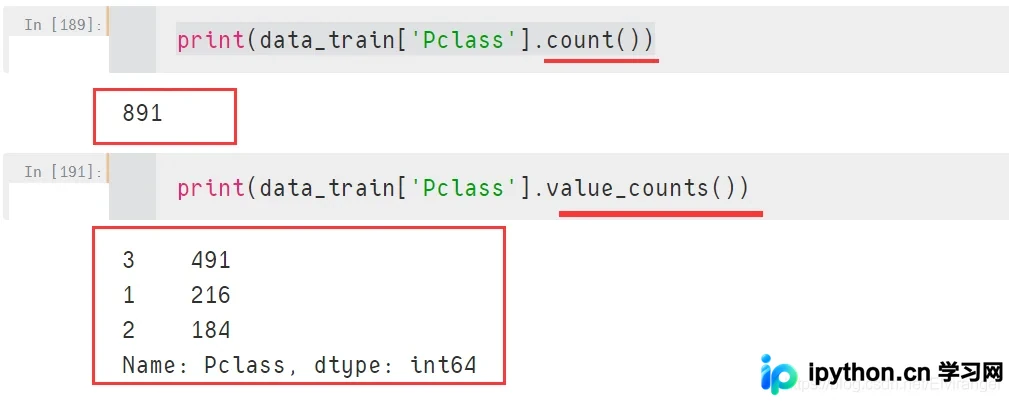
两者在底层逻辑与输出结构上存在显著差异,选择时需明确分析目标:
- 返回类型不同:
count()返回int(标量或单值);value_counts()返回Series(多维键值对),包含所有唯一值及其对应频次。 - 处理缺失值策略:两者默认均忽略
NaN,但value_counts()可通过dropna=False强制将缺失值作为独立类别统计。 - 排序特性:
value_counts()默认按频次降序排列(sort=True, ascending=False),便于快速定位高频项;count()无排序概念。
典型问题排查
Q:为什么 value_counts() 没有显示某个分类?
A:默认情况下 dropna=True 会隐藏空值。若需统计缺失情况,请显式传入 dropna=False。另外,浮点数精度差异或隐式类型转换可能导致相同视觉数值被拆分为不同类别,建议在调用前先统一数据类型或使用 bins 参数进行分箱处理。
总结
count() 适合宏观核对数据规模与有效性,value_counts() 适合微观洞察特征分布与偏态。在实际Pipeline中,常将二者组合使用,例如先用 len(df) 或 count() 把控体量,再跑 value_counts() 定位异常类标。以上就是 Pandas count() 与 value_counts() 用法及区别的详细内容,更多关于 Python 数据分析技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









