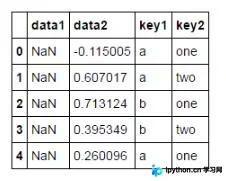
Jupyter Notebook 完整显示行列与解决输出截断问题
本文介绍如何在 Jupyter Notebook 中通过 pd.set_option 配置最大显示行数和列数,以及浮点数精度,确保数据预览完整。同时提供解决更换主题后输出区域字符截断的 CSS 修改方案,包括调整 div.output_area 的 padding 值,帮助开发者优化数据查看体验。
2026-10-13
6

本文介绍如何在 Jupyter Notebook 中通过 pd.set_option 配置最大显示行数和列数,以及浮点数精度,确保数据预览完整。同时提供解决更换主题后输出区域字符截断的 CSS 修改方案,包括调整 div.output_area 的 padding 值,帮助开发者优化数据查看体验。
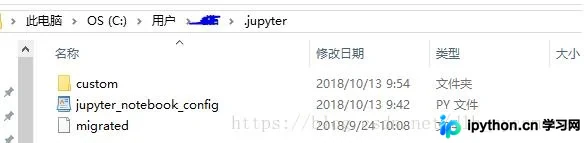
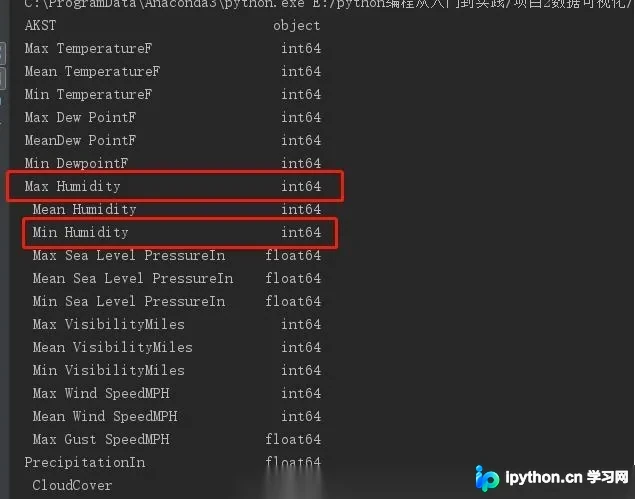
本文详细解析Python中type()、dtype()和astype()三个函数的区别。type()返回数据结构类型,dtype()获取元素数据类型,astype()用于类型转换。通过代码示例说明list、dict不可调用后两者,仅np.array支持。同时展示使用astype(float)解决Pandas DataError的实际案例,帮助开发者避免类型转换错误。
本文介绍 pandas 中使用 astype 进行强制类型转换时,直接转换含小数的字符串为 int 会引发 ValueError。通过先转为 float 再转 int 的两步法,可正确实现从字符串到整数的转换,避免特殊字符报错。
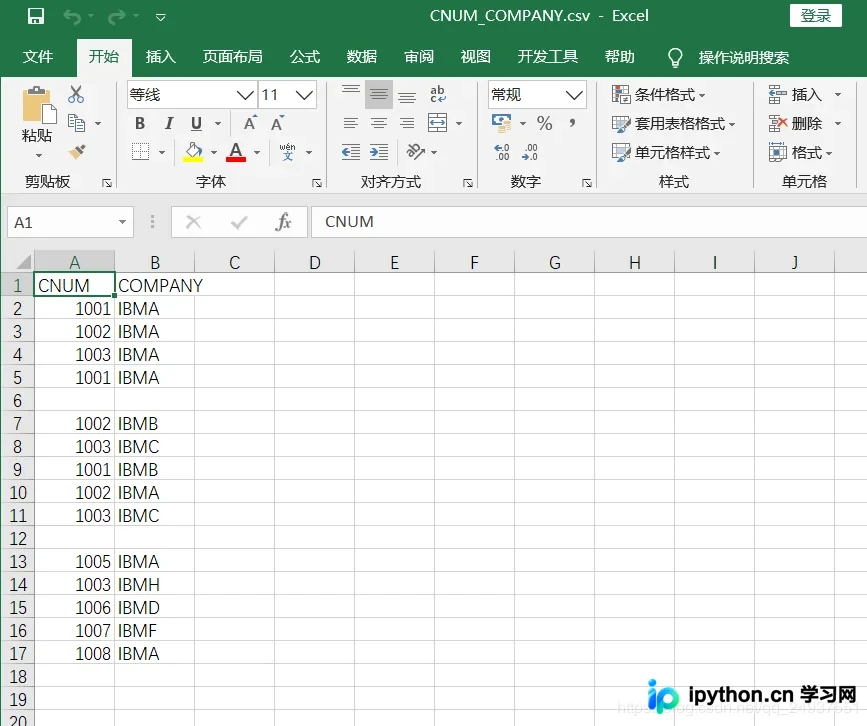
本文通过具体案例对比Python Pandas与VBA处理CSV数据的效率与代码复杂度。针对包含空行和重复数据的CSV文件,演示了如何去除空行、保留唯一记录、重命名列并动态扩展新列。结果显示两者结果一致,但Pandas代码更简洁,VBA需借助数组和字典,调试相对复杂。
本文介绍如何使用Python客户端通过impyla库连接Impala数据库。内容涵盖环境配置、HS2服务端口设置、SQL执行、结果遍历及利用Pandas进行数据分析的方法。针对大数据集,建议通过CTAS写入HDFS,并解决了pandas安装中常见的Visual C++依赖问题。
本文通过Python代码实例,对北京积分落户数据进行了多维度深入分析。利用Pandas库进行数据清洗与处理,重点从公司规模、申请人年龄分布及百家姓三个维度统计落户人数与分数指标。同时,结合Matplotlib对分数段占比进行可视化展示,并总结了groupby与cut在离散与连续数据分析中的核心应用技巧。
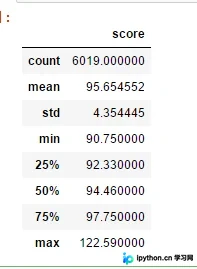
本文介绍如何使用 Python 对 Excel 表格进行自由定制处理。通过具体示例,演示如何删除重复行与空行、去除字符串中间空格、统一日期时间格式以及规范数字与货币符号。文章涵盖 dict.fromkeys 去重、字符串 split/join 处理、datetime 格式化及 Decimal 精度控制等关键技术点,帮助开发者快速掌握表格自动化处理技巧。
本文解决PyCharm中导入pandas时程序无响应或报错ModuleNotFoundError的问题。主要方案包括在设置中重新安装pandas并尝试不同版本号,以及切换至已配置好pandas的项目解释器。通过暴力卸载重装或更改Project Interpreter路径,可有效恢复环境正常运行。
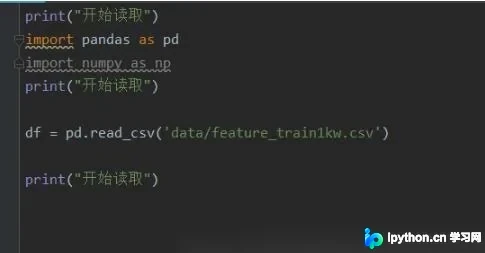
本文介绍使用pandas读取txt文件指定列的方法,重点区分带有标题和无标题文件的处理差异。详细解析read_table函数的filepath_or_buffer、sep、names、engine及encoding等关键参数,解决中文路径及编码问题,并提供完整代码示例与常见错误排查指南。
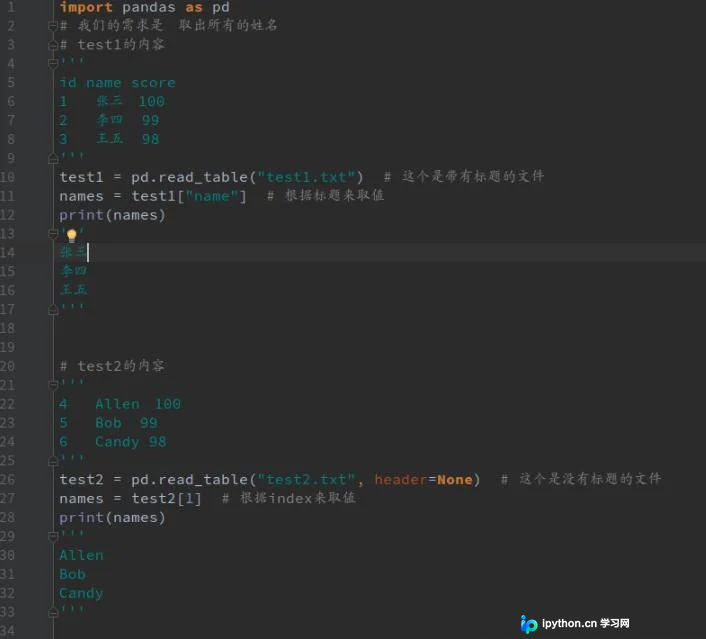
本文深入讲解Python pandas库在统计分析中的核心应用。涵盖describe()生成描述性统计指标、自定义统计函数、数据排序与多表连接(内/左连接)。重点演示缺失值的三大处理策略:删除法、填补法(均值/中位数/众数)及插补法,并介绍数据打乱技巧,助力高效数据预处理。
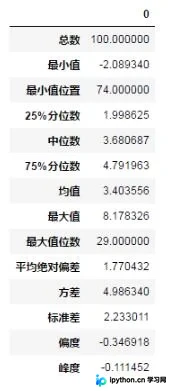
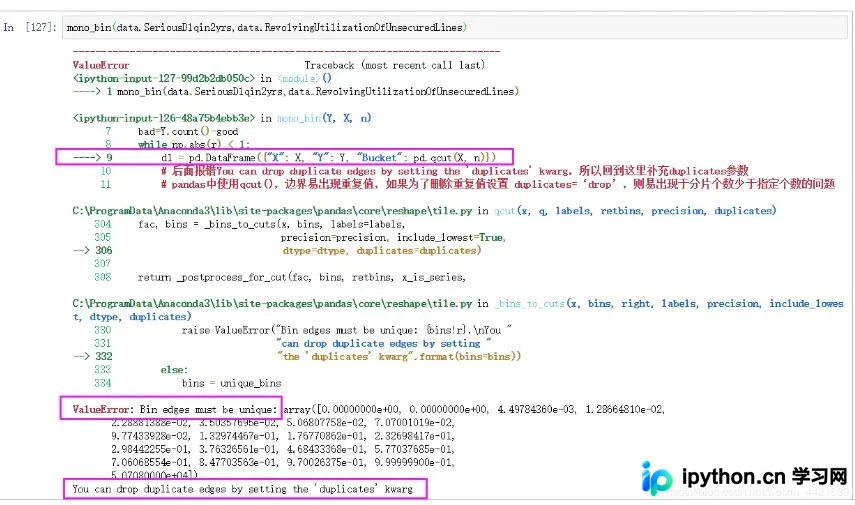
本文详细解析pandas.cut与pandas.qcut两个函数的参数与区别,涵盖等宽与等深分箱原理。针对信用风控建模中常见的qcut边界重复报错,提供设置duplicates='drop'的解决方案,并展示变量离散化及WOE计算的实际代码示例。
本文系统介绍Python Pandas库中基于rolling的移动窗口函数系列。涵盖rolling_count、rolling_sum、rolling_mean等核心统计函数,以及指数加权移动平均ewma系列。详细解析各函数的参数设置、适用场景及代码示例,帮助开发者高效处理时间序列数据与滑动统计计算。