

Python pandas读取txt指定列:有标题与无标题的处理方法

发布时间:2026-10-13| 2人浏览过
本文介绍使用pandas读取txt文件指定列的方法,重点区分带有标题和无标题文件的处理差异。详细解析read_table函数的filepath_or_buffer、sep、names、engine及encoding等关键参数,解决中文路径及编码问题,并提供完整代码示例与常见错误排查指南。
pandas读取txt文件指定列的方法与参数详解
在处理大型txt文件时,通常会将其分割为多个小文件。值得注意的是,只有第一个分割文件保留有标题行,后续文件则不再包含标题信息。
针对从这些文件中提取指定列数据的需求,经过实践验证,可以成功解决相关技术难点。
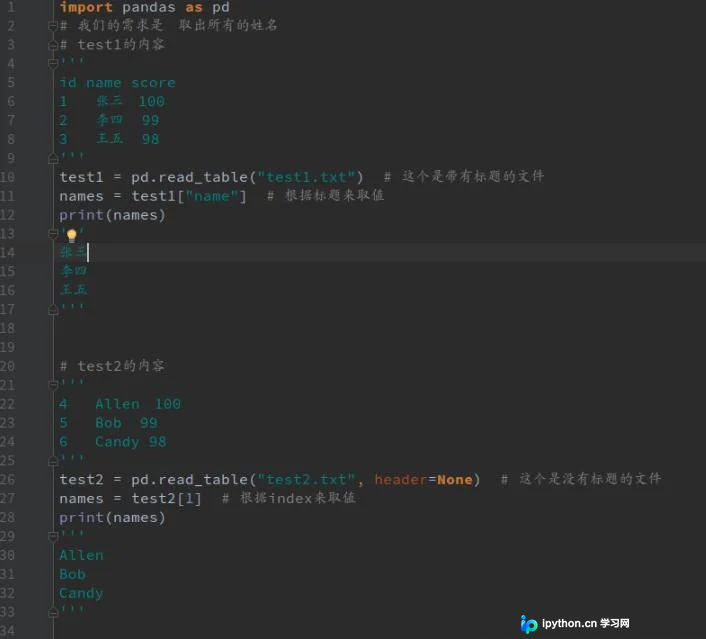
import pandas as pd
# 我们的需求是 取出所有的姓名
# test1的内容
'''
id name score
1  张三 100
2  李四 99
3  王五 98
'''
test1 = pd.read_table("test1.txt") # 这个是带有标题的文件
names = test1["name"] # 根据标题来取值
print(names)
'''
张三
李四
王五
'''

# test2的内容
'''
4  Allen 100
5  Bob 99
6  Candy 98
'''
test2 = pd.read_table("test2.txt", header=None) # 这个是没有标题的文件
names = test2[1] # 根据index来取值
print(names)
'''
Allen
Bob
Candy
'''
在使用pandas读取txt文件时,需要特别注意相关配置细节,以确保数据准确读取。
核心语法为pandas.read_table(),该函数专门用于处理分隔符分隔的文本文件。
该函数支持多个关键参数配置,具体如下:
filepath_or_buffer:指定文件路径或输入对象;sep:指定分隔符,默认值为制表符(\t);names:定义读取的列名及顺序,默认按顺序读取所有列;engine:当文件路径包含中文字符时,需设置engine='python'以兼容解析;encoding:指定文件编码格式,默认跟随操作系统文字编码;na_values:用于指定被视为空值的字符串,如null、NULL、NA、None等。
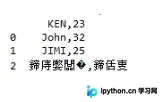
常见的错误在于参数设置不完整,导致读取失败或数据格式异常。
import pandas
data = pandas.read_table(‘D/anaconda/数据分析/文本.txt',
engine=‘python')
print(data)
通过正确配置参数,可以获得预期的输出结果。
以下是完整的代码实现示例:
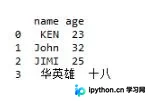
import pandas
data = pandas.read_table(‘D/anadondas/数据分析/文本.txt',
sep = ‘,' ,#指定分隔符‘,',默认为制表符
names = [‘names',‘age'],#设置列名,默认将第一行数据作为列名
engine = ‘python',
encoding = ‘utf8'#指定编码格式)
print(data)
执行上述代码后,将得到正确的数据输出结果。
以上即为使用pandas读取txt文件指定列(无论是否有标题)的完整指南,希望能为读者提供有价值的参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









