

pandas.cut与qcut详解:参数、用法及分箱报错处理

本文详细解析pandas.cut与pandas.qcut两个函数的参数与区别,涵盖等宽与等深分箱原理。针对信用风控建模中常见的qcut边界重复报错,提供设置duplicates='drop'的解决方案,并展示变量离散化及WOE计算的实际代码示例。
pandas.cut函数详解
在Python数据处理中,pandas库提供了两种常用的分箱方法:pandas.cut和pandas.qcut。理解它们的参数设置及适用场景,对于数据预处理至关重要。
pandas.cut(x, bins, right=True, labels=None, retbins=False, precision=3, include_lowest=False)
pandas.cut函数的参数说明如下:
1. x:类array对象,必须为一维数组,表示待切割的原始数据。
2. bins:可以是整数、序列尺度或间隔索引。若bins为整数,则定义x宽度范围内的等宽面元数量;此时x的范围会在两端各延长1%,以确保包含最小值或最大值。若bins为序列,则定义允许非均匀宽度的分箱边缘,此时不扩展x的范围。
3. right:布尔值,指定区间是否为左开右闭。
4. labels:用作结果箱的标签,长度必须与结果箱相同。若设为False,则仅返回整数标识的面元数组。
5. retbins:布尔值,指定是否返回分箱边缘。
6. precision:整数,指定返回面元的小数精度位数。
7. include_lowest:布尔值,指定第一个区间的左端点是否包含在内。
pandas.cut的返回值说明如下:
若labels设为False,则返回由整数填充的Categorical对象、数组或Series。
若retbins设为True,则额外返回由浮点数填充的N维数组,包含分箱边缘。
以下是pandas.cut的示例代码:
>>> pd.cut(np.array([.2, 1.4, 2.5, 6.2, 9.7, 2.1]), 3, retbins=True)
...
([(0.19, 3.367], (0.19, 3.367], (0.19, 3.367], (3.367, 6.533], ...
Categories (3, interval[float64]): [(0.19, 3.367] < (3.367, 6.533] ...
~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~
>>> pd.cut(np.array([.2, 1.4, 2.5, 6.2, 9.7, 2.1]),
... 3, labels=["good", "medium", "bad"])
...
[good, good, good, medium, bad, good]
Categories (3, object): [good < medium < bad]
~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~
>>> pd.cut(np.ones(5), 4, labels=False)
array([1, 1, 1, 1, 1])
pandas.qcut函数详解
与cut不同,pandas.qcut主要用于基于分位数的等深分箱。
pandas.qcut(x, q, labels=None, retbins=False, precision=3, duplicates='raise')
pandas.qcut函数的参数说明如下:
1. x:输入数据。2. q:整数或分位数组成的数组,定义分箱数量或分位点。3. labels:结果箱的标签。4. retbins:是否返回分箱边缘。5. precision:小数精度。6. duplicates:处理重复边缘的策略。
需要注意的是,结果中超出分箱边界的值将被转换为NA。
以下是pandas.qcut的示例代码:
>>> pd.qcut(range(5), 4)
...
[(-0.001, 1.0], (-0.001, 1.0], (1.0, 2.0], (2.0, 3.0], (3.0, 4.0]]
Categories (4, interval[float64]): [(-0.001, 1.0] < (1.0, 2.0] ...
~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~
>>> pd.qcut(range(5), 3, labels=["good", "medium", "bad"])
...
[good, good, medium, bad, bad]
Categories (3, object): [good < medium < bad]
~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~
pd.qcut(range(5), 4, labels=False)
array([0, 0, 1, 2, 3])
qcut报错处理与风控应用
在Python中使用qcut()时,常遇到“Bin edges must be unique”或“You can drop duplicate edges by setting 'duplicates' kwarg”的报错。
该问题的背景通常出现在互金领域的信用风控建模中,涉及变量分箱处理。
解决Python中qcut()函数运行报错“Bin edges must be unique”和“You can drop duplicate edges by setting the 'duplicates' kwarg”的方法如下:
首先,报错信息通常提示边界值不唯一。
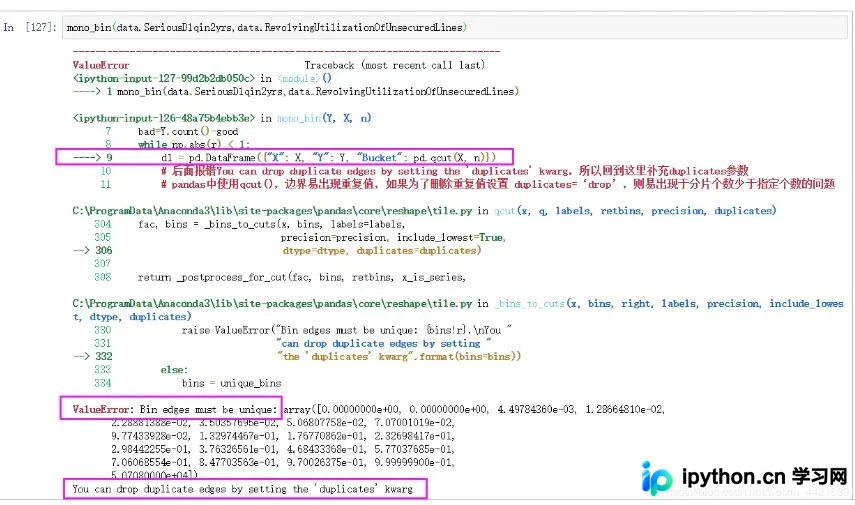
解决方法是在qcut()函数中设置duplicates参数为“drop”(注意不能设为“raise”),从而允许删除重复的边界值以继续运行。
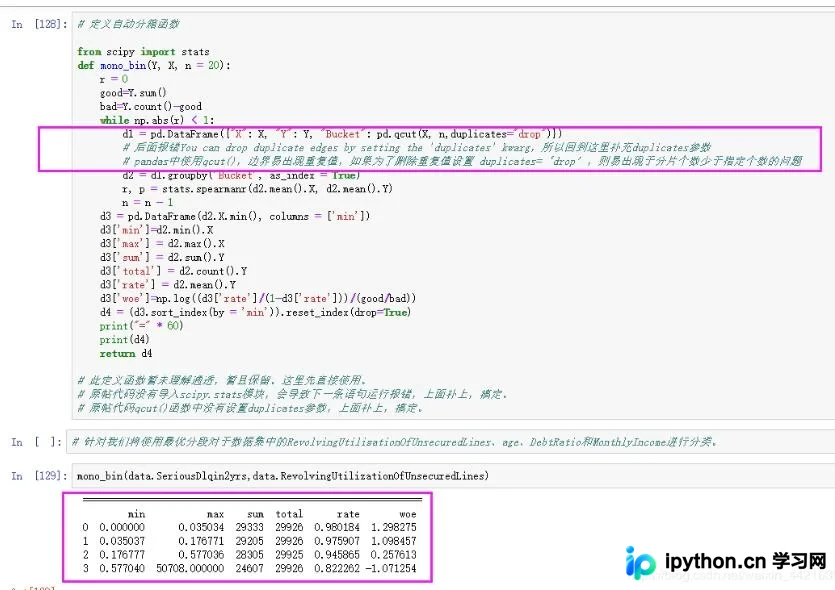
该纠错背景源于互金领域信用风控建模中的变量分箱处理。
# 五、变量选择
# 特征变量选择(排序)对于数据分析、机器学习从业者来说非常重要。
# 好的特征选择能够提升模型的性能,更能帮助我们理解数据的特点、底层结构,这对进一步改善模型、算法都有着重要作用。
# 至于Python的变量选择代码实现可以参考结合Scikit-learn介绍几种常用的特征选择方法。

# 在本文中,我们采用信用评分模型的变量选择方法,通过WOE分析方法,即是通过比较指标分箱和对应分箱的违约概率来确定指标是否符合经济意义。
# 首先我们对变量进行离散化(分箱)处理。
# 5.1 分箱处理
# 变量分箱(binning)是对连续变量离散化(discretization)的一种称呼。
# 信用评分卡开发中一般有常用的等距分段、等深分段、最优分段。
# 其中等距分段(Equval length intervals)是指分段的区间是一致的,比如年龄以十年作为一个分段;
# 等深分段(Equal frequency intervals)是先确定分段数量,然后令每个分段中数据数量大致相等;
# 最优分段(Optimal Binning)又叫监督离散化(supervised discretizaion),使用递归划分(Recursive Partitioning)将连续变量分为分段,背后是一种基于条件推断查找较佳分组的算法。
我们首先选择对连续变量进行最优分段;当连续变量的分布不满足最优分段要求时,再考虑对连续变量进行等距分段。最优分箱的代码如下:
# 定义自动分箱函数

from scipy import stats
def mono_bin(Y, X, n = 20):
 r = 0
 good=Y.sum()
 bad=Y.count()-good
 while np.abs(r) < 1:
 d1 = pd.DataFrame({"X": X, "Y": Y, "Bucket": pd.qcut(X, n,duplicates="drop")})
 # 后面报错You can drop duplicate edges by setting the 'duplicates' kwarg,所以回到这里补充duplicates参数
 # pandas中使用qcut(),边界易出现重复值,如果为了删除重复值设置 duplicates=‘drop',则易出现于分片个数少于指定个数的问题
 d2 = d1.groupby('Bucket', as_index = True)
 r, p = stats.spearmanr(d2.mean().X, d2.mean().Y)
 n = n - 1
 d3 = pd.DataFrame(d2.X.min(), columns = ['min'])
 d3['min']=d2.min().X
 d3['max'] = d2.max().X
 d3['sum'] = d2.sum().Y
 d3['total'] = d2.count().Y
 d3['rate'] = d2.mean().Y
 d3['woe']=np.log((d3['rate']/(1-d3['rate']))/(good/bad))
 d4 = (d3.sort_index(by = 'min')).reset_index(drop=True)
 print("=" * 60)
 print(d4)
 return d4

# 此定义函数暂未理解通透,暂且保留。这里先直接使用。
# 原帖代码没有导入scipy.stats模块,会导致下一条语句运行报错,上面补上,搞定。
# 原帖代码qcut()函数中没有设置duplicates参数,上面补上,搞定。
# 自定义函数分箱RevolvingUtilizationOfUnsecuredLines时报错You can drop duplicate edges by setting the 'duplicates' kwarg
# 所以先回来删除重复值。删除后发现没有解决问题,真正解决问题是在qcut()函数中没有设置duplicates参数为“drop”(不能设置为“raise”)
data=data.drop_duplicates(subset=None,keep='first',inplace=False)
data.shape
数据形状为(119703, 11)。
针对数据集中的RevolmingUtilizationOfUnsecuredLines、age、DebtRatio和MonthlyIncome变量,我们将使用最优分段进行分类。
调用mono_bin(data.SeriousDlqin2yrs, data.RevolmingUtilizationOfUnsecuredLines)进行分箱。
============================================================
 min  max sum total rate woe
0 0.000000 0.035034 29333 29926 0.980184 1.298275
1 0.035037 0.176771 29205 29926 0.975907 1.098457
2 0.176777 0.577036 28305 29925 0.945865 0.257613
3 0.577040 50708.000000 24607 29926 0.822262 -1.071254| min | max | sum | total | rate | woe | |
|---|---|---|---|---|---|---|
| 0 | 0.000000 | 0.035034 | 29333 | 29926 | 0.980184 | 1.298275 |
| 1 | 0.035037 | 0.176771 | 29205 | 29926 | 0.975907 | 1.098457 |
| 2 | 0.176777 | 0.577036 | 28305 | 29925 | 0.945865 | 0.257613 |
| 3 | 0.577040 | 50708.000000 | 24607 | 29926 | 0.822262 | -1.071254 |
调用mono_bin(data.SeriousDlqin2yrs, data.age)进行分箱。
============================================================
 min max sum total rate woe
0 21 30 7913 8885 0.890602 -0.506093
1 31 34 6640 7383 0.899363 -0.412828
2 35 38 7594 8386 0.905557 -0.342447
3 39 41 7131 7849 0.908523 -0.307262
4 42 43 4890 5362 0.911973 -0.265031
5 44 46 8163 8868 0.920501 -0.153830
6 47 48 5776 6274 0.920625 -0.152133
7 49 51 8545 9280 0.920797 -0.149768
8 52 53 5454 5901 0.924250 -0.101453
9 54 56 7922 8463 0.936075 0.080980
10 57 59 7517 7946 0.946011 0.260466
11 60 61 4942 5200 0.950385 0.349567
12 62 64 7464 7776 0.959877 0.571844
13 65 68 6968 7212 0.966167 0.748916
14 69 75 7911 8141 0.971748 0.934931
15 76 103 6620 6777 0.976833 1.138606
| min | max | sum | total | rate | woe | |
|---|---|---|---|---|---|---|
| 0 | 21 | 30 | 7913 | 8885 | 0.890602 | -0.506093 |
| 1 | 31 | 34 | 6640 | 7383 | 0.899363 | -0.412828 |
| 2 | 35 | 38 | 7594 | 8386 | 0.905557 | -0.342447 |
| 3 | 39 | 41 | 7131 | 7849 | 0.908523 | -0.307262 |
| 4 | 42 | 43 | 4890 | 5362 | 0.911973 | -0.265031 |
| 5 | 44 | 46 | 8163 | 8868 | 0.920501 | -0.153830 |
| 6 | 47 | 48 | 5776 | 6274 | 0.920625 | -0.152133 |
| 7 | 49 | 51 | 8545 | 9280 | 0.920797 | -0.149768 |
| 8 | 52 | 53 | 5454 | 5901 | 0.924250 | -0.101453 |
| 9 | 54 | 56 | 7922 | 8463 | 0.936075 | 0.080980 |
| 10 | 57 | 59 | 7517 | 7946 | 0.946011 | 0.260466 |
| 11 | 60 | 61 | 4942 | 5200 | 0.950385 | 0.349567 |
| 12 | 62 | 64 | 7464 | 7776 | 0.959877 | 0.571844 |
| 13 | 65 | 68 | 6968 | 7212 | 0.966167 | 0.748916 |
| 14 | 69 | 75 | 7911 | 8141 | 0.971748 | 0.934931 |
| 15 | 76 | 103 | 6620 | 6777 | 0.976833 | 1.138606 |
调用mono_bin(data.SeriousDlqin2yrs, data.MonthlyIncome)进行分箱。
============================================================
 min max sum total rate woe
0 0.0 3400.0 27355 30073 0.909620 -0.293996
1 3401.0 5400.0 27655 30008 0.921588 -0.138884
2 5401.0 8200.0 27925 29725 0.939445 0.138736
3 8201.0 49750.0 28515 29897 0.953775 0.423899
| min | max | sum | total | rate | woe | |
|---|---|---|---|---|---|---|
| 0 | 0.0 | 3400.0 | 27355 | 30073 | 0.909620 | -0.293996 |
| 1 | 3401.0 | 5400.0 | 27655 | 30008 | 0.921588 | -0.138884 |
| 2 | 5401.0 | 8200.0 | 27925 | 29725 | 0.939445 | 0.138736 |
| 3 | 8201.0 | 49750.0 | 28515 | 29897 | 0.953775 | 0.423899 |
以上介绍了pandas.cut与pandas.qcut的使用方法及区别,希望能为读者提供参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









