

Python pandas统计分析实战:描述性统计、数据清洗与多表连接

本文深入讲解Python pandas库在统计分析中的核心应用。涵盖describe()生成描述性统计指标、自定义统计函数、数据排序与多表连接(内/左连接)。重点演示缺失值的三大处理策略:删除法、填补法(均值/中位数/众数)及插补法,并介绍数据打乱技巧,助力高效数据预处理。
pandas描述性统计基础与自定义函数
pandas模块提供了丰富的描述性统计分析函数,包括总和、均值、最小值、最大值等常用指标。接下来我们将具体探讨这些函数的使用方法。
首先,随机生成三组测试数据用于后续分析。
import numpy as np
import pandas as pd

np.random.seed(1234)
d1 = pd.Series(2*np.random.normal(size = 100)+3)
d2 = np.random.f(2,4,size = 100)
d3 = np.random.randint(1,100,size = 100)
其次,列出统计分析中常用的核心函数列表。
d1.count()  #非空元素计算
d1.min()  #最小值
d1.max()  #最大值
d1.idxmin()  #最小值的位置,类似于R中的which.min函数
d1.idxmax()  #最大值的位置,类似于R中的which.max函数
d1.quantile(0.1) #10%分位数
d1.sum()  #求和
d1.mean()  #均值
d1.median()  #中位数
d1.mode()  #众数
d1.var()  #方差
d1.std()  #标准差
d1.mad()  #平均绝对偏差
d1.skew()  #偏度
d1.kurt()  #峰度
d1.describe() #一次性输出多个描述性统计指标
需要特别注意,describe方法仅适用于Series序列或DataFrame数据框,一维数组不具备此方法。我们可以自定义一个函数,将各类统计指标汇总输出:
def status(x) :
 return pd.Series([x.count(),x.min(),x.idxmin(),x.quantile(.25),x.median(),
   x.quantile(.75),x.mean(),x.max(),x.idxmax(),x.mad(),x.var(),
   x.std(),x.skew(),x.kurt()],index=['总数','最小值','最小值位置','25%分位数',
   '中位数','75%分位数','均值','最大值','最大值位数','平均绝对偏差','方差','标准差','偏度','峰度'])
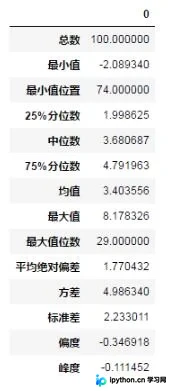
执行该自定义函数,查看d1数据集的各项统计值结果:
df = pd.DataFrame(status(d1)) df
运行上述代码后的输出结果如下。
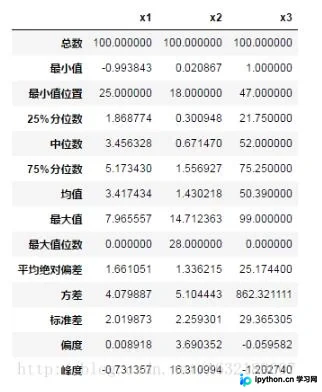
在实际工作场景中,我们常需处理包含多列数值型数据的DataFrame。如何将上述统计函数应用于数据框的每一列?可以使用apply函数,其用法与R语言中的apply类似。我们将之前创建的d1、d2、d3数据构建为DataFrame:
df = pd.DataFrame(np.array([d1,d2,d3]).T, columns=['x1','x2','x3'])
df.head()

df.apply(status)
应用apply函数后的结果展示。
数据加载与基本统计指标解析
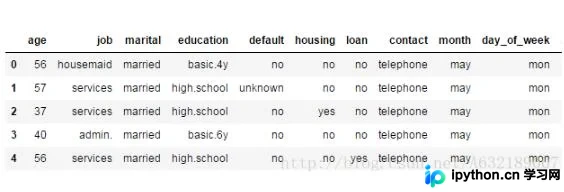
接下来,演示如何加载CSV格式的数据文件。
import numpy as np
import pandas as pd

bank = pd.read_csv("D://bank/bank-additional-train.csv")
bank.head() #查看前5行
描述性统计方法一:使用describe()函数。
result = bank['age'].describe() pd.DataFrame(result ) #格式化成DataFrame
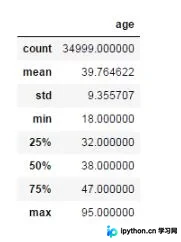
描述性统计方法二:使用describe(include=['number'])指定数据类型。
include参数用于指定数据类型。若需查看包含字符串等所有数据的统计信息,可填写object,即include=['object'];若需查看浮点型数据,则填写include=['float']。
result = bank.describe(include=['object'])
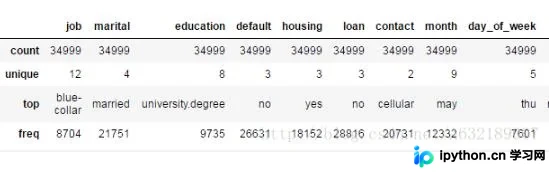
上述代码中各统计指标的具体含义如下。
count:指定字段的非空观测总数。 unique:该字段中不同值的数量,例如性别列包含“男”和“女”两种值,则unique值为2。 top:出现频率最高的值。 freq:出现频率最高的值的计数。 执行bank.describe(include=['number'])可查看数值型列的统计信息。
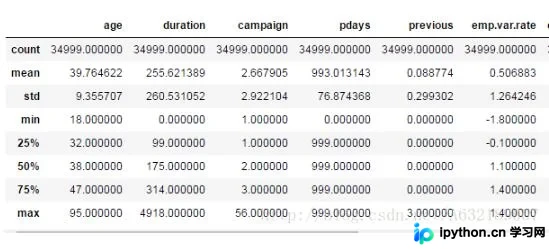
相关系数、协方差与数据排序
计算连续变量之间的相关系数,使用corr()方法。
bank.corr()
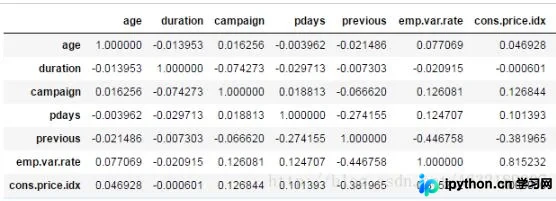
计算协方差矩阵,使用cov()方法。
bank.cov()
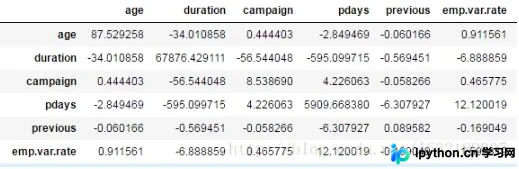
演示如何删除DataFrame中的指定列。
bank.drop('job', axis=1) #删除指定列,axis=1参数必不可少
演示对数据进行排序操作。
bank.sort_values(by=['job','age']) #根据工作、年龄升序排序 bank.sort_values(by=['job','age'], ascending=False) #根据工作、年龄降序排序
多表连接:内连接与左连接
演示多表连接(Merge)操作。
首先准备用于连接的两个数据源数据。
import numpy as np
import pandas as pd

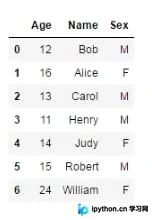
student = {'Name':['Bob','Alice','Carol','Henry','Judy','Robert','William'],
  'Age':[12,16,13,11,14,15,24],
  'Sex':['M','F','M','M','F','M','F']}

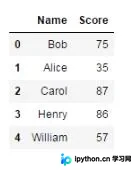
score = {'Name':['Bob','Alice','Carol','Henry','William'],
  'Score':[75,35,87,86,57]}

df_student = pd.DataFrame(student)
df_student

df_score = pd.DataFrame(score)
df_score
学生信息表(student)数据示例。
成绩信息表(score)数据示例。
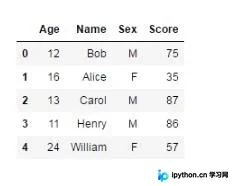
执行内连接(Inner Join)操作。
stu_score1 = pd.merge(df_student, df_score, on='Name') stu_score1
需注意,merge函数默认执行内连接,即仅返回两张表中共同键匹配的数据。可通过how参数指定连接方式:left为左连接,right为右连接,outer为外连接。
执行左连接(Left Join)操作。
stu_score2 = pd.merge(df_student, df_score, on='Name',how='left') stu_score2
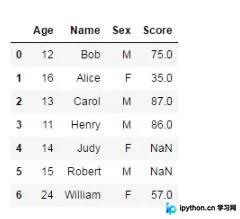
在左连接结果中,没有对应成绩记录的学生,其Score字段值为NaN。
缺失值处理:删除、填补与插补
处理数据中的缺失值问题。
现实数据往往杂乱且常见缺失值,这可能影响后续分析或挖掘。处理缺失值主要有三类方法:删除法、填补法和插值法。
缺失值处理策略一:删除法。
若某变量大部分值为缺失,可考虑删除该变量;若缺失值随机分布且数量不多,也可直接删除这些缺失观测。
缺失值处理策略二:填补法。
对于连续型变量,若分布近似或服从正态分布,可用均值填补缺失值;若分布有偏,则使用中位数填补;对于离散型变量,通常用众数填补缺失观测。
缺失值处理策略三:插补法。
插补法基于蒙特卡洛模拟,结合线性模型、广义线性模型或决策树等方法计算预测值,以此替换缺失值。
此处使用前述学生成绩数据进行测试处理。
查询某一字段中数据为空的数量。
sum(pd.isnull(stu_score2['Score'])) 结果:2
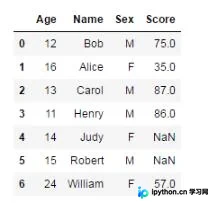
直接删除包含缺失值的行。
stu_score2.dropna()
删除缺失值前的数据状态。
删除缺失值后的数据状态。
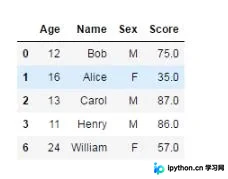
默认情况下,dropna会删除任何含有缺失值的行。
仅删除所有列均为缺失值的行数据。
import numpy as np
import pandas as pd

df = pd.DataFrame([[1,2,3],[3,4,np.nan],
   [12,23,43],[55,np.nan,10],
   [np.nan,np.nan,np.nan],[np.nan,1,2]],
   columns=['a1','a2','a3'])
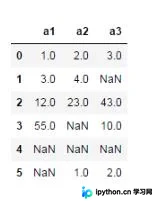
df.dropna() #该操作会删除所有有缺失值的行数据
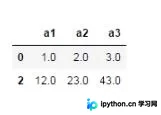
df.dropna(how='all') #该操作仅会删除所有列均为缺失值的行数据
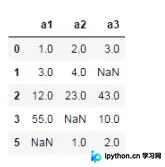
使用填充法处理缺失数据。
使用常量填补缺失值,可通过fillna函数实现简单填补。
示例1:用0填补所有缺失值。
df.fillna(0)
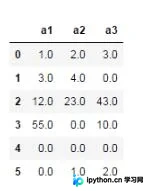
示例2:采用前向填充或后向填充。
df.fillna(method='ffill') #用前一个值填充
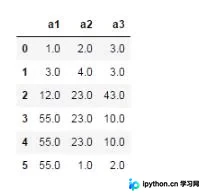
df.fillna(method='bfill') #用后一个值填充
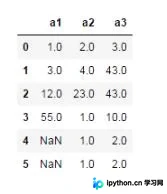
示例3:使用不同常量填充不同列。
df.fillna({'a1':100,'a2':200,'a3':300})
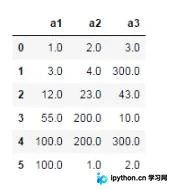
示例4:用均值或中位数填充各自列。
a1_median = df['a1'].median() #计算a1列的中位数
a1_median=7.5

a2_mean = df['a2'].mean() #计算a2列的均值
a2_mean = 7.5

a3_mean = df['a3'].mean() #计算a3列的均值
a3_mean = 14.5

df.fillna({'a1':a1_median,'a2':a2_mean,'a3':a3_mean}) #填充值
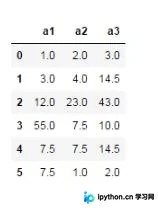
显然,使用各列的众数、均值或中位数填充比常数或前后项填充更合理,这也是工作中常用的快捷手段。
数据打乱与索引重置
数据打乱(Shuffle)操作。
实际工作中,多个DataFrame合并后常需打乱数据顺序。pandas中的sample函数可实现此操作。
df = df.sample(frac=1)
上述代码可对df进行shuffle。参数frac指定返回数据的比例,例如df有10行数据,仅返回30%则设置frac=0.3。若需打乱后索引仍保持正常排序,可进行如下操作。
df = df.sample(frac=1).reset_index(drop=True)
以上即为基于Python pandas进行统计分析的完整内容,希望能对读者有所帮助,欢迎支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









