

Python实现北京积分落户数据分析:公司、年龄与姓氏维度解析

发布时间:2026-10-13| 3人浏览过
本文通过Python代码实例,对北京积分落户数据进行了多维度深入分析。利用Pandas库进行数据清洗与处理,重点从公司规模、申请人年龄分布及百家姓三个维度统计落户人数与分数指标。同时,结合Matplotlib对分数段占比进行可视化展示,并总结了groupby与cut在离散与连续数据分析中的核心应用技巧。
北京积分落户数据分析概述
本文通过具体的Python代码示例,详细演示了北京积分落户数据的分析流程。内容涵盖数据获取、多维度指标分析及可视化展示,旨在为相关技术参考提供实践案例。
北京积分落户数据分析流程主要包含两个阶段:首先通过爬虫或文件下载方式获取原始数据,随后进行多维度的指标分析。
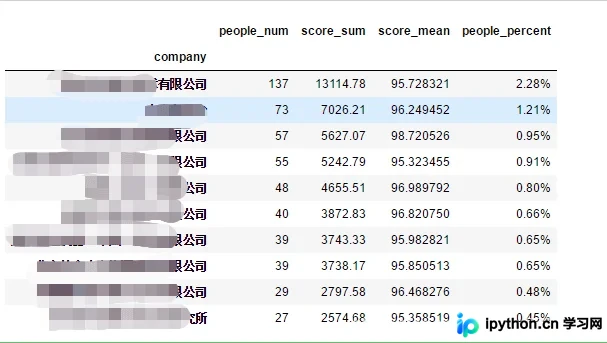
- 从公司维度出发,分析不同企业对落户人数的具体影响,旨在识别哪些公司不仅落户人数最多,且其员工更容易获得落户资格。
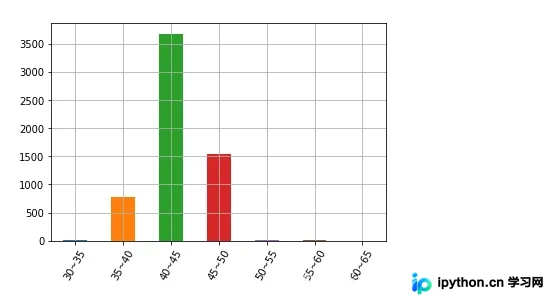
- 从年龄维度切入,探讨不同年龄段对落户指标的影响,重点分析哪个年龄段的落户人数最多以及该群体是否具备更高的落户成功率。
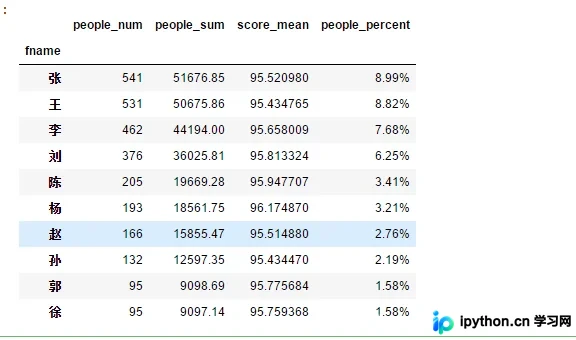
- 从百家姓维度进行统计,分析不同姓氏对落户人数的影响,旨在找出落户人数最多且相对更容易成功的姓氏分布情况。
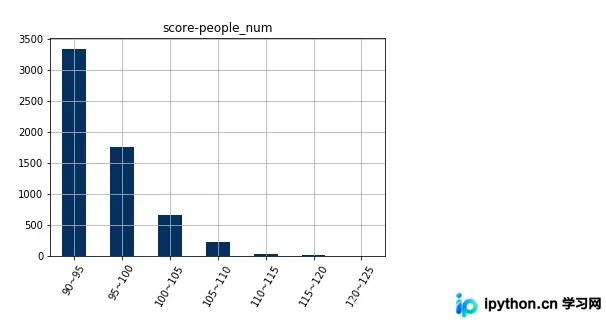
- 统计并展示不同分数段在总落户人数中的占比情况,以直观反映分数分布特征。
数据准备与环境配置
# 导入库
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib import font_manager
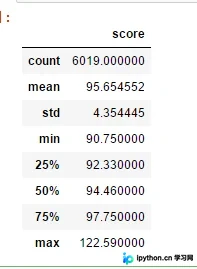
#读取数据(文件) , 并查看数据相应结构和格式
lh_data = pd.read_csv('./bj_luohu.csv',index_col='id',usecols=(0,1,2,3,4))
lh_data.describe()
公司维度落户指标分析
# 1. 公司维度---人数指标
# 对公司进行分组聚合 , 并查看分数的相关数据 (个数 , 总分数 , 平均分 , 人数占比)
group_company = lh_data.groupby('company',as_index=False)['score'].agg(['count','sum','mean']).sort_values('count',ascending=False)
#更改列名称
group_company.rename(columns={'count':'people_num','sum':'score_sum','mean':'score_mean'},inplace=True)
#定一个函数 , 得到占比
def num_percent(people_num=1,people_sum=1):
  return str('%.2f'%(people_num / people_sum * 100))+'%'
#增加一个占比列
group_company['people_percent'] = group_company['people_num'].apply(num_percent,people_sum=lh_data['name'].count())
#查看只有一个人落户的公司 布尔索引
group_company[group_company['people_num'] == 1]
group_company.head(10)
年龄维度分布与分桶处理
# 2.年龄维度----人数指标
#将出生年月转为年龄
lh_data['age'] = (pd.to_datetime('2019-09') - pd.to_datetime(lh_data['birthday'])) / pd.Timedelta('365 days')
# 分桶
lh_data.describe()
bins_age = pd.cut(lh_data['age'],bins=np.arange(30,70,5))
bins_age_group = lh_data['age'].groupby(bins_age).count()
bins_age_group.index = [str(i.left) + '~' + str(i.right) for i in bins_age_group.index]
bins_age_group.plot(kind='bar',alpha=1,rot=60,grid=0.2)
百家姓维度统计与占比计算
# 3. 姓维度----人数指标
# 增加姓列
#定义一个函数 得到姓名的姓
def get_fname(name):
  if len(str(name)) <= 3:
    return str(name[0])
  else:
    return str(name[0:2])
lh_data['fname'] = lh_data['name'].apply(get_fname)
# 对姓进行分组
group_fname = lh_data.groupby('fname')['score'].agg(['count','sum','mean']).sort_values('count',ascending=False)
# 更改列名称
group_fname.rename(columns={'count':'people_num','sum':'people_sum','mean':'score_mean'},inplace=True)
# 增加占比列
group_fname['people_percent'] = group_fname['people_num'].apply(num_percent,people_sum=lh_data['name'].count())
group_fname.head(10)
分数段占比可视化分析
# 4. 查看分数段占比
# 分桶 将分数划分为一个个的区间
bins_score = pd.cut(lh_data['score'],np.arange(90,130,5))
# 将分数装入对应的桶里
bins_score_group = lh_data['score'].groupby(bins_score).count()
# 更改索引显示格式
bins_score_group.index = [str(i.left)+'~'+str(i.right) for i in bins_score_group.index]
bins_score_group.plot(kind='bar',alpha=1,rot=60,grid=0.2,title='score-people_num',colormap='RdBu_r')
技术总结与建议
总结与分析要点如下: 1. Pandas内置的绘图功能在灵活性和强大程度上有限,建议在实际复杂绘图场景中优先使用Matplotlib库。 2. 数据分析中两个核心方法需重点掌握:分组操作groupby()通常适用于离散型数据(如公司、姓氏);分桶操作cut()则适用于连续型数据(如年龄区间、分数区间)。
如需了解更多Python相关技巧,可参考本站专题:《Python数学运算技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》及《Python入门与进阶经典教程》。
希望上述关于Python程序设计的分析内容能对大家有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









