Python Pandas resample函数详解:降采样与重采样实战
本文详细介绍Python Pandas中resample函数的用法,涵盖降采样与重采样两种场景。通过示例解析rule、closed、label等关键参数对区间划分的影响,并对比asfreq、ffill、bfill三种重采样填充策略,帮助开发者掌握时间序列数据的聚合与插值技巧。
2026-10-13
6

本文详细介绍Python Pandas中resample函数的用法,涵盖降采样与重采样两种场景。通过示例解析rule、closed、label等关键参数对区间划分的影响,并对比asfreq、ffill、bfill三种重采样填充策略,帮助开发者掌握时间序列数据的聚合与插值技巧。
本文介绍如何使用Python的Pandas库将CSV文件高效导入SQLite3数据库。通过示例代码展示利用read_csv读取数据,并借助to_sql方法将数据写入指定表,相比传统Shell模式操作更为便捷,适合初学者参考。
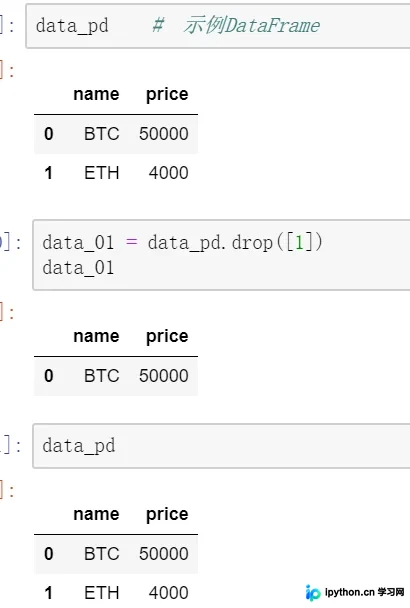
本文深入解析Python中Pandas库在处理数据结构时的内存复制机制。通过具体示例说明,当对DataFrame进行删除行等操作时,默认会在新的内存区域生成副本以保护原始数据。文章探讨了如何通过设置参数直接修改原数据,并引出Python中赋值与深浅复制的广泛概念,帮助开发者理解数据安全性与内存优化的平衡。
本文介绍了在TensorFlow项目中从TXT文件读取数据的两种主流方法:使用numpy的loadtxt函数和pandas的read_csv函数。文章详细展示了两种方法的代码实现,并重点强调了读取后的数据形状必须与模型定义的placeholder保持一致,以确保后续训练流程的顺利进行。
本文详解pandas中计算相关系数与协方差的核心方法。通过实例演示如何使用pct_change计算百分比变化,利用corr和cov计算列间相关性与协方差矩阵,并讲解DataFrame与Series间的对齐计算规则及axis参数的应用,帮助开发者掌握数据统计分析基础。
本文介绍pandas中DataFrameGroupBy对象的agg方法,演示如何对分组数据执行聚合操作。涵盖对每一行使用agg、多列应用多个聚合函数以及单列指定聚合函数的具体代码示例,帮助开发者掌握灵活的数据聚合技巧。
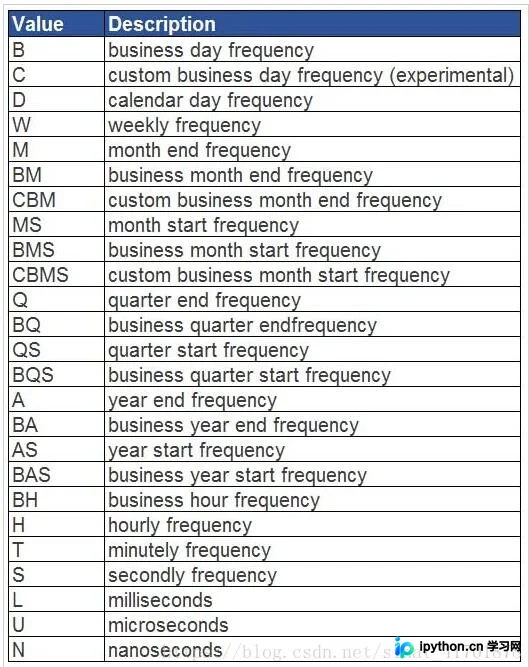
本文介绍如何利用 pandas 的 resample 方法对时间序列数据进行聚合处理。通过设置 datetime 索引,演示按年、月、日及自定义频率(如周、季度)提取数据,并结合 sum 与 fillna 实现具体列的汇总与缺失值填充,提供完整的代码示例供参考。
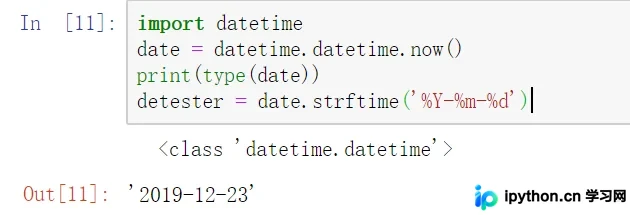
本文详解Python中Pandas处理日期格式的常用方法。涵盖字符串转日期的strptime与to_datetime函数,以及利用apply处理DataFrame列的技巧。同时介绍dateutil.parser.parse的高级解析能力,并演示日期转字符串的strftime用法,帮助开发者高效解决时间格式转换问题。
本文介绍了在Python Pandas中处理数据时遇到的inf和nan值问题。通过示例展示了如何使用replace方法将inf和-inf转换为nan,以避免对后续数据处理产生影响。
本文介绍Pandas库中DataFrame.rename函数的使用方法,用于重命名数据框的行索引或列名。详细解析了mapper、index、columns、axis等关键参数,对比了两种调用约定,并通过代码示例演示了字典映射与函数转换的实际效果,帮助开发者高效进行数据预处理。
本文详解pandas中str.split方法的expand参数。当expand=True时,分割结果转换为DataFrame,每列对应一个子串;expand=False时保持Series。结合n参数可控制分割次数,示例展示不同组合下的输出差异及类型变化。
本文详解如何使用Python读取.mat文件并提取所需信息。通过scipy.io.loadmat加载文件,解析返回的字典结构,获取指定Key对应的numpy数组。随后利用pandas将多维数组转换为DataFrame格式,便于后续的数据展示与分析处理。