

VBA与Python Pandas数据处理对比:去重、清洗与列扩展实战

发布时间:2026-10-13| 4人浏览过
本文通过具体案例对比Python Pandas与VBA处理CSV数据的效率与代码复杂度。针对包含空行和重复数据的CSV文件,演示了如何去除空行、保留唯一记录、重命名列并动态扩展新列。结果显示两者结果一致,但Pandas代码更简洁,VBA需借助数组和字典,调试相对复杂。
数据处理需求与目标
需求背景:
当前存在一个CSV文件,该文件包含'CNUM'和'COMPANY'两个字段。数据中既存在空行,也包含内容重复的记录。
处理要求:
1)剔除所有空行; 2)对于重复数据,仅保留一条有效记录; 3)将'COMPANY'列名修改为'Company_New'; 4)在该列之后新增六列,名称依次为'C_col', 'D_col', 'E_col', 'F_col', 'G_col', 'H_col'。
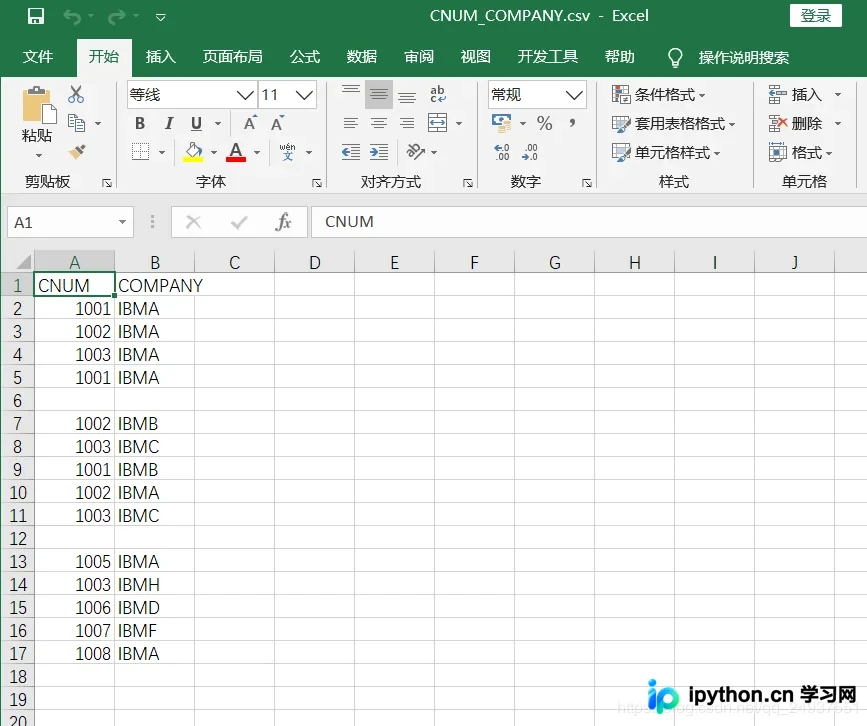
Python Pandas 实现方案
一、使用 Python Pandas 方案:
import pandas as pd
import numpy as np
from pandas import DataFrame,Series

def deal_with_data(filepath,newpath):
  file_obj=open(filepath)
  df=pd.read_csv(file_obj)  # 读取csv文件,创建 DataFrame
  df=df.reindex(columns=['CNUM','COMPANY','C_col','D_col','E_col','F_col','G_col','H_col'],fill_value=None)  # 重新指定列索引
  df.rename(columns={'COMPANY':'Company_New'}, inplace = True) # 修改列名
  df=df.dropna(axis=0,how='all')         # 去除 NAN 即文件中的空行
  df['CNUM'] = df['CNUM'].astype('int32')    # 将 CNUM 列的数据类型指定为 int32
  df = df.drop_duplicates(subset=['CNUM', 'Company_New'], keep='first') # 去除重复行
  df.to_csv(newpath,index=False,encoding='GBK')
  file_obj.close()

if __name__=='__main__':
  file_path=r'C:\Users\12078\Desktop\python\CNUM_COMPANY.csv'
  file_save_path=r'C:\Users\12078\Desktop\python\CNUM_COMPANY_OUTPUT.csv'
  deal_with_data(file_path,file_save_path)
VBA 实现方案
二、使用 VBA 方案:
Option Base 1
Option Explicit

Sub main()
 On Error GoTo error_handling
 Dim wb         As Workbook
 Dim wb_out       As Workbook
 Dim sht         As Worksheet
 Dim sht_out       As Worksheet
 Dim rng         As Range
 Dim usedrows      As Byte
 Dim usedrows_out    As Byte
 Dim dict_cnum_company  As Object
 Dim str_file_path    As String
    Dim str_new_file_path  As String
    'assign values to variables:
    str_file_path = "C:\Users\12078\Desktop\Python\CNUM_COMPANY.csv"
    str_new_file_path = "C:\Users\12078\Desktop\Python\CNUM_COMPANY_OUTPUT.csv"

 Set wb = checkAndAttachWorkbook(str_file_path)
 Set sht = wb.Worksheets("CNUM_COMPANY")
 Set wb_out = Workbooks.Add
 wb_out.SaveAs str_new_file_path, xlCSV 'create a csv file
 Set sht_out = wb_out.Worksheets("CNUM_COMPANY_OUTPUT")

 Set dict_cnum_company = CreateObject("Scripting.Dictionary")
 usedrows = WorksheetFunction.Max(getLastValidRow(sht, "A"), getLastValidRow(sht, "B"))

 'rename the header 'COMPANY' to 'Company_New',remove blank & duplicate lines/rows.
 Dim cnum_company As String
 cnum_company = ""
 For Each rng In sht.Range("A1", "A" & usedrows)
   If VBA.Trim(rng.Offset(0, 1).Value) = "COMPANY" Then
     rng.Offset(0, 1).Value = "Company_New"
   End If
   cnum_company = rng.Value & "-" & rng.Offset(0, 1).Value
   If VBA.Trim(cnum_company) <> "-" And Not dict_cnum_company.Exists(rng.Value & "-" & rng.Offset(0, 1).Value) Then
     dict_cnum_company.Add rng.Value & "-" & rng.Offset(0, 1).Value, ""
   End If
 Next rng

 'loop the keys of dict split the keyes by '-' into cnum array and company array.
 Dim index_dict As Byte
 Dim arr_cnum()
 Dim arr_Company()
 For index_dict = 0 To UBound(dict_cnum_company.keys)
   ReDim Preserve arr_cnum(1 To UBound(dict_cnum_company.keys) + 1)
   ReDim Preserve arr_Company(1 To UBound(dict_cnum_company.keys) + 1)
   arr_cnum(index_dict + 1) = Split(dict_cnum_company.keys()(index_dict), "-")(0)
   arr_Company(index_dict + 1) = Split(dict_cnum_company.keys()(index_dict), "-")(1)
   Debug.Print index_dict
 Next

 'assigns the value of the arrays to the celles.
 sht_out.Range("A1", "A" & UBound(arr_cnum)) = Application.WorksheetFunction.Transpose(arr_cnum)
 sht_out.Range("B1", "B" & UBound(arr_Company)) = Application.WorksheetFunction.Transpose(arr_Company)

 'add 6 columns to output csv file:
 Dim arr_columns() As Variant
 arr_columns = Array("C_col", "D_col", "E_col", "F_col", "G_col", "H_col")  '
 sht_out.Range("C1:H1") = arr_columns
 Call checkAndCloseWorkbook(str_file_path, False)
 Call checkAndCloseWorkbook(str_new_file_path, True)

Exit Sub
error_handling:
  Call checkAndCloseWorkbook(str_file_path, False)
  Call checkAndCloseWorkbook(str_new_file_path, False)
End Sub

' 辅助函数:
'Get last row of Column N in a Worksheet
Function getLastValidRow(in_ws As Worksheet, in_col As String)
  getLastValidRow = in_ws.Cells(in_ws.Rows.count, in_col).End(xlUp).Row
End Function

Function checkAndAttachWorkbook(in_wb_path As String) As Workbook
  Dim wb As Workbook
  Dim mywb As String
  mywb = in_wb_path

  For Each wb In Workbooks
    If LCase(wb.FullName) = LCase(mywb) Then
      Set checkAndAttachWorkbook = wb
      Exit Function
    End If
  Next

  Set wb = Workbooks.Open(in_wb_path, UpdateLinks:=0)
  Set checkAndAttachWorkbook = wb

End Function

Function checkAndCloseWorkbook(in_wb_path As String, in_saved As Boolean)
  Dim wb As Workbook
  Dim mywb As String
  mywb = in_wb_path
  For Each wb In Workbooks
    If LCase(wb.FullName) = LCase(mywb) Then
      wb.Close savechanges:=in_saved
      Exit Function
    End If
  Next
End Function
三、执行结果展示:
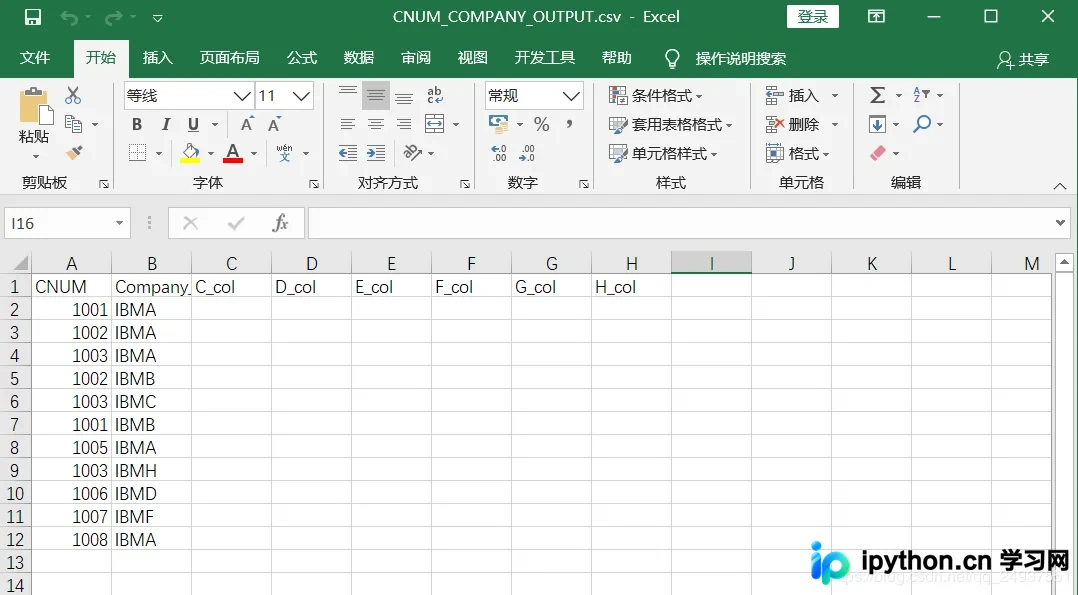
两种方法生成的最终数据一致:
结果对比与总结
四、综合对比分析:
Python Pandas 内置了丰富的数据处理函数,开发者无需重复造轮子,操作便捷且代码精简。 相比之下,使用 Excel VBA 实现相同需求时,需调用数组、字典等数据结构(因实际数据量较大,未直接遍历单元格),并涉及复杂的字符串处理、数组操作及文件读写逻辑。一旦出错,VBA 的调试难度高于 Python。尽管已对 VBA 代码进行优化,其代码量仍远多于 Python 实现。
以上就是关于VBA处理数据与Python Pandas处理数据案例比较分析的详细介绍。如需了解更多VBA与Python Pandas处理数据相关内容,欢迎查阅本站历史文章或继续浏览后续教程,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









