

Python数据科学与AI开发常用框架盘点:PyTorch、TensorFlow与Scikit-learn
深入盘点Python数据科学与AI开发的三大核心框架:PyTorch、TensorFlow与Scikit-learn。从核心定位、底层计算图架构、典型代码示例到工业级选型决策,全面梳理三大框架的适用场景与工程落地实践。
在当前的Python数据科学与人工智能工程实践中,PyTorch、TensorFlow与Scikit-learn构成了绝大多数算法研发与生产部署的基础技术底座。这三个框架并非彼此替代的单一竞争关系,而是分别在传统统计机器学习、深度前沿学术探索以及大规模工业化流水线中形成了清晰的分工定位。本文将系统盘点这三大核心框架的底层设计、运行机制、经典代码范式以及选型决策依据,帮助开发者根据具体的数据结构、算力边界和工程目标制定合理的技术路线。
一、三大框架生态定位与技术全景
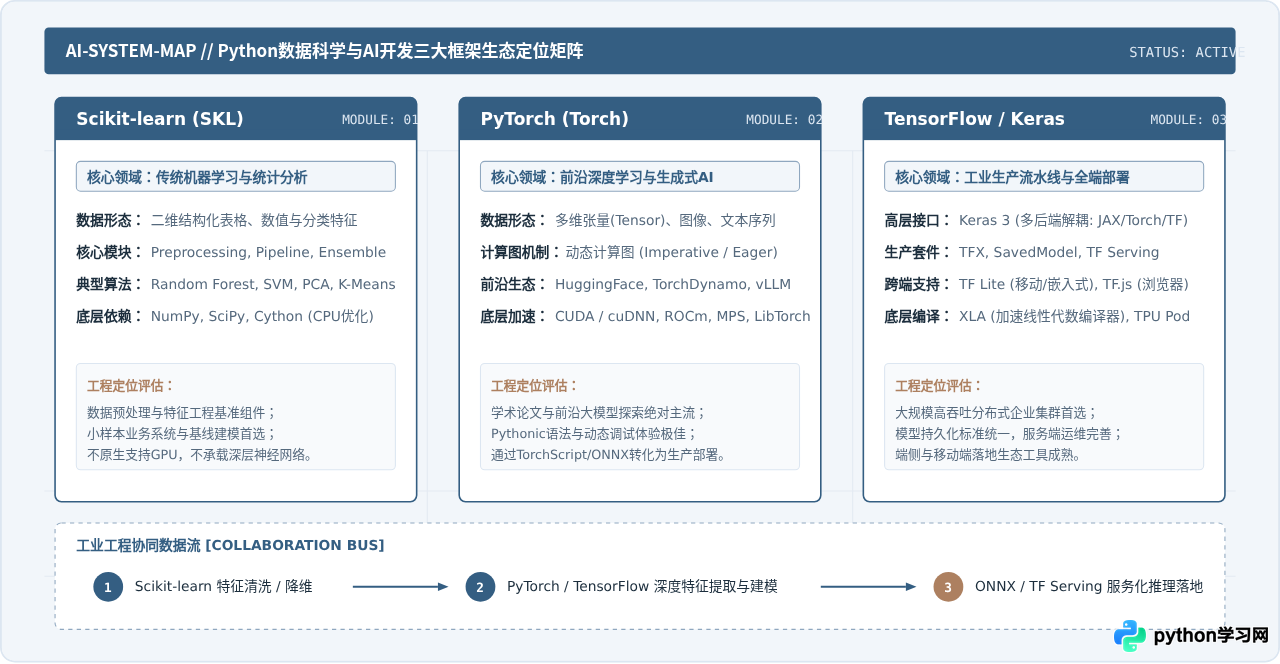
构建现代AI与数据科学系统时,任务通常跨越“特征工程/表格分析”、“深度模型训练与实验”以及“工业化高并发推断服务”三个阶段。Scikit-learn专注在CPU体系下对结构化表格数据进行统计建模与预处理,PyTorch主导了以GPU为核心的动态计算图与现代大语言模型生态,而TensorFlow则沉淀了成熟的端到端生产流水线与跨端异构部署体系。
二、Scikit-learn:传统机器学习与数据科学基石
Scikit-learn(简称sklearn)建立在NumPy、SciPy和matplotlib之上,是Python数据科学界最早统一算法接口标准的经典框架。它的核心价值在于高度一致的API设计模式,无论是线性回归、决策树、支持向量机,还是特征标准化与主成分分析,都严格遵循“估计器(Estimator)”与“转换器(Transformer)”的规范。
1. 核心设计模式与API规范
在Scikit-learn中,所有对象的调用逻辑高度标准化:
- Estimator(估计器):实现
fit(X, y)方法,从训练数据中学习参数,训练完成后的属性通常带有下划线后缀(如coef_、feature_importances_)。 - Transformer(转换器):用于数据清洗与特征变换,实现
transform(X)与便捷的fit_transform(X)。 - Predictor(预测器):用于推断输出,实现
predict(X)以及给出置信度的predict_proba(X)。 - Pipeline(管道):将特征缩放、缺失值插补、编码与最终模型按序串联为一个整体,杜绝数据泄漏(Data Leakage)。
2. 典型工程实现:标准化Pipeline与交叉验证
以下代码展示了一个工业级标准的Scikit-learn工作流,演示如何对数值特征进行中位数填补、标准化缩放,并接入随机森林分类器进行5折交叉验证评估。
# 环境要求: Python 3.9+, scikit-learn >= 1.3.0, numpy >= 1.24.0
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier

# 1. 生成示例结构化分类数据 (1000条样本, 10个特征)
X, y = make_classification(
    n_samples=1000,
    n_features=10,
    n_informative=7,
    n_classes=2,
    random_state=42
)

# 模拟缺失值注入
np.random.seed(42)
mask = np.random.rand(*X.shape) < 0.05
X[mask] = np.nan

# 2. 划分训练集与测试集
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 3. 构建无泄漏Pipeline: 缺失值插补 -> 标准化 -> 随机森林分类器
pipeline = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='median')),
    ('scaler', StandardScaler()),
    ('classifier', RandomForestClassifier(n_estimators=100, max_depth=6, random_state=42))
])

# 4. 5折交叉验证评估稳定性
cv_scores = cross_val_score(pipeline, X_train, y_train, cv=5, scoring='accuracy')

# 5. 全训练集拟合并在测试集验证
pipeline.fit(X_train, y_train)
test_accuracy = pipeline.score(X_test, y_test)

print(f"5折交叉验证准确率均值: {cv_scores.mean():.4f} (+/- {cv_scores.std():.4f})")
print(f"独立测试集最终准确率: {test_accuracy:.4f}")
3. 适用边界与工程限制
Scikit-learn的核心算法主要依赖CPU单机多线程(通过Joblib驱动OpenMP或并行子进程)。其技术边界非常明确:第一,原生算法库不支持GPU张量运算,面对千万级高维稀疏特征或海量样本时,训练延迟显著上升;第二,不支持自动微分引擎,无法灵活堆叠多层非线性神经元;第三,不适合处理原生图像像素阵列、音频波形和变长自然语言序列等非结构化数据。
三、PyTorch:学术研究与大模型开发的绝对主力
PyTorch由Meta开源并贡献给Linux基金会,凭借命令式编程(Imperative Programming)与动态计算图(Dynamic Computation Graph,即Eager Execution)彻底改变了深度学习研发范式。在PyTorch中,张量计算与Python控制流深度绑定,开发者可以使用常规的Python调试工具(如pdb、breakpoint()或IDE单步调试)直接检查每层梯度的反向流动。
1. 核心机制:动态计算图与Autograd机制
与早期将计算图定义与运行时完全割裂的静态图框架不同,PyTorch在前向传播(Forward Pass)执行的同时动态记录执行轨迹(Execution Trace)。每个张量对象(Tensor)都保存着计算历史及其梯度函数引用(grad_fn)。当调用loss.backward()时,引擎自动反向遍历图节点,使用链式法则精确计算梯度并累加至.grad属性中。
2. 典型工程实现:自定义模块与显式训练循环
以下代码展示了一个完整的PyTorch全连接网络训练结构,包含了硬件设备自动检测、自定义nn.Module、参数优化器绑定与单步反向传播过程。
# 环境要求: Python 3.9+, torch >= 2.0.0
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 自动适配计算硬件 (CUDA / Apple Silicon MPS / CPU)
device = torch.device(
    "cuda" if torch.cuda.is_available()
    else ("mps" if torch.backends.mps.is_available() else "cpu")
)
print(f"当前训练执行设备: {device}")

# 2. 定义深层前馈神经网络
class MultiLayerPerceptron(nn.Module):
    def __init__(self, in_features: int, hidden_dim: int, num_classes: int):
        super(MultiLayerPerceptron, self).__init__()
        self.network = nn.Sequential(
            nn.Linear(in_features, hidden_dim),
            nn.BatchNorm1d(hidden_dim),
            nn.ReLU(),
            nn.Dropout(p=0.2),
            nn.Linear(hidden_dim, num_classes)
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.network(x)

# 3. 实例化模型并迁移至目标设备
model = MultiLayerPerceptron(in_features=16, hidden_dim=32, num_classes=2).to(device)
criterion = nn.CrossEntropyLoss()
optimizer = optim.AdamW(model.parameters(), lr=1e-3, weight_decay=1e-4)

# 4. 模拟一个批次的张量数据 (Batch Size = 64)
dummy_inputs = torch.randn(64, 16).to(device)
dummy_labels = torch.randint(0, 2, (64,)).to(device)

# 5. 执行显式训练单步迭代
model.train()
optimizer.zero_grad()                 # 清空旧梯度缓存
outputs = model(dummy_inputs)         # 前向计算
loss = criterion(outputs, dummy_labels) # 计算损失
loss.backward()                       # 反向自动求导
optimizer.step()                      # 权重更新

print(f"前向输出维度: {tuple(outputs.shape)}, 单步损失计算值: {loss.item():.4f}")
3. 大模型时代的生态统治力
随着生成式AI与大语言模型(LLM)的爆发,PyTorch已经成为学术界与开源大模型事实上的工业底座。目前主流的大模型开源库(如Hugging Face Transformers、DeepSpeed、Megatron-LM、vLLM以及FlashAttention)均将PyTorch作为第一开发与支持平台。配合PyTorch 2.x引入的torch.compile与TorchDynamo,框架在保留动态调试灵活性的同时,实现了底层计算算子的自动融合与速度跃升。
四、TensorFlow与Keras:工业级部署与端到端生产利器
TensorFlow由Google团队研发,自诞生起就承载着服务数十亿用户的大规模分布式工程使命。它最显著的优势在于全生命周期的工业闭环工具链,覆盖从数据摄取流水线(tf.data)、分布式多机多卡训练,到跨平台持久化模型封装(SavedModel)以及毫秒级低延迟推断集群(TensorFlow Serving)。
1. 架构演进与Keras多后端重构
在TensorFlow 2.x及最新版本中,Keras已成为其默认的高层接口。随着Keras 3.0的推出,其底层架构进一步解耦,同一套Keras代码可以直接无缝运行在TensorFlow、PyTorch或JAX引擎之上。开发者既能享受到声明式网络构建的极简语法,又能在需要部署至Google Cloud TPU、Android移动端(TF Lite)或前端Web应用(TF.js)时,调用TensorFlow完整的编译与量化管线。
2. 典型工程实现:Keras序贯构建与静态图加速
在生产环境中,通常使用tf.function装饰器将Python函数跟踪编译为静态优化图,利用XLA(Accelerated Linear Algebra)进行内存复用和算子融合。
# 环境要求: Python 3.9+, tensorflow >= 2.13.0
import tensorflow as tf
from tensorflow import keras
from tensorflow.keras import layers

# 1. 禁用多余日志并打印框架版本
print(f"TensorFlow 运行时版本: {tf.__version__}")

# 2. 使用 Keras 声明式 API 构建分类模型
model = keras.Sequential([
    layers.Input(shape=(16,)),
    layers.Dense(32, activation='relu', name="hidden_layer_1"),
    layers.BatchNormalization(),
    layers.Dropout(0.2),
    layers.Dense(2, activation='softmax', name="output_layer")
])

# 3. 编译模型: 确定优化器、损失函数与监控指标
model.compile(
    optimizer=keras.optimizers.Adam(learning_rate=0.001),
    loss='sparse_categorical_crossentropy',
    metrics=['accuracy']
)

# 4. 生成模拟数据集并利用 tf.data 构建批处理管道
synthetic_x = tf.random.normal(shape=(256, 16))
synthetic_y = tf.random.uniform(shape=(256,), minval=0, maxval=2, dtype=tf.int32)
dataset = tf.data.Dataset.from_tensor_slices((synthetic_x, synthetic_y)).batch(64)

# 5. 执行模型拟合
history = model.fit(dataset, epochs=2, verbose=0)
train_acc = history.history['accuracy'][-1]
train_loss = history.history['loss'][-1]

print(f"训练完成 - 最终批次损失: {train_loss:.4f}, 准确率: {train_acc:.4f}")
3. 工业化部署基础设施
TensorFlow真正的核心壁垒在于其无可替代的生产基础设施:
- SavedModel 标准格式:将网络结构、权重权重、运算图和签名信息整合为一个自包含目录,解耦语言依赖,C++服务器可直接加载。
- TensorFlow Serving:支持模型热加载、多版本并发治理、动态批处理(Dynamic Batching),在十万级QPS推荐引擎中表现极度平稳。
- TensorFlow Lite (TFLite):针对ARM与端侧NPU提供整型量化(INT8)、权重剪枝与微控制器优化工具链。
五、底层计算机制与执行架构深度对比
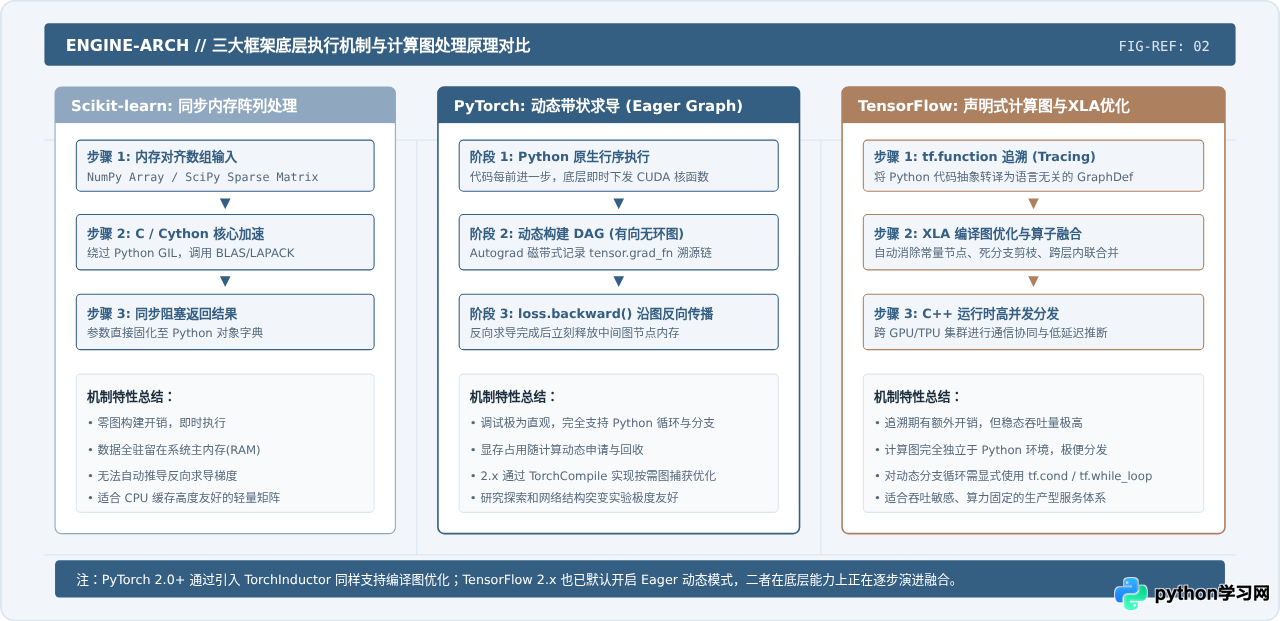
为了深刻理解为什么不同框架在调试速度、运行效率与部署难易度上表现迥异,必须考察其底层的计算图生成方式与内存执行流。
六、工程落地:全流程标准开发操作流水线
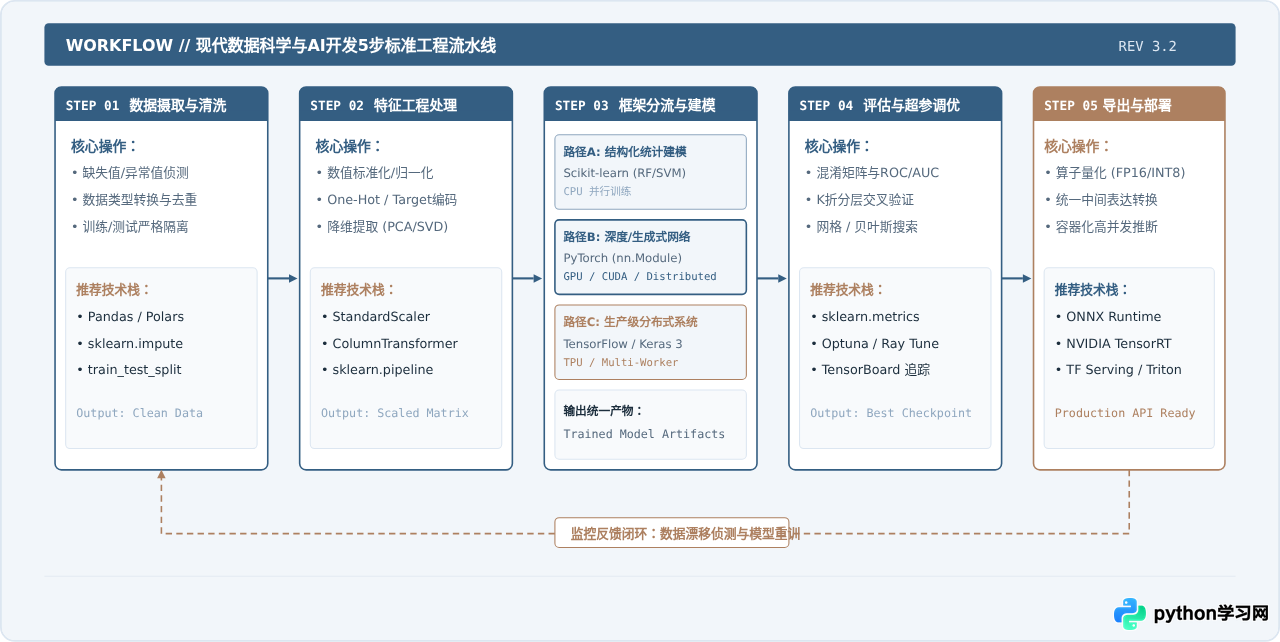
在一个规范的工业级AI或数据科学项目中,算法开发绝不仅限于编写模型结构本身。从原始数据清洗、特征加工、模型选型训练,到指标评测与最终部署,需要严密的标准化操作步骤。
七、三大框架核心技术指标横向对比
为了让工程团队在技术选型时有具体的定量与定性依据,以下从语言规范、计算图机制、硬件加速能力、分布式扩展以及主流应用场景进行全方位对照:
| 评测维度 | Scikit-learn | PyTorch | TensorFlow / Keras |
|---|---|---|---|
| 核心计算图架构 | 无计算图(基于 NumPy/SciPy 同步执行) | 动态图为主(Eager),2.x 支持编译图捕获 | 静态图优化为主(GraphDef),支持 Eager 模式 |
| 原生硬件加速 | 主要依赖 CPU 多核(支持 OpenMP 并行) | 完整支持 NVIDIA GPU (CUDA), AMD (ROCm), Apple (MPS) | 完整支持 GPU (CUDA), Google TPU, 端侧 NPU |
| 自动微分引擎 | 无(算法解析式求导或无导数优化) | 强大的 Autograd 动态链式求导引擎 | GradientTape 记录式求导引擎 |
| 分布式训练扩展 | 基于多进程单机并行(Joblib 进程池) | DDP(分布式数据并行)、FSDP、DeepSpeed、Megatron | MirroredStrategy、MultiWorkerMirroredStrategy、TPUStrategy |
| 移动与端侧部署 | 需导出至 C/C++ 或转 ONNX 嵌入 | ExecuTorch、TorchScript、转换为 ONNX/TensorRT | 成熟完备的 TensorFlow Lite (TFLite) 与 TF.js |
| 学习曲线与调试难度 | 学习成本最低,API 规范统一直观 | 代码风格 Pythonic,报错堆栈清晰,调试极佳 | 历史版本(1.x/2.x)包袱较重,报错追溯相对复杂 |
| 当前学术与工业现状 | 传统机器学习与统计特征工程的工业标准 | 学术论文、大语言模型(LLM)与生成式AI霸主 | 大规模工业搜推广系统、移动端与Google生态首选 |
八、框架选型决策路径与工程落地建议
技术选型不应盲目追求框架的“前沿性”或“复杂性”,而应以解决实际业务问题为唯一导向。以下决策树梳理了从业务目标到框架落地的清晰判断逻辑:
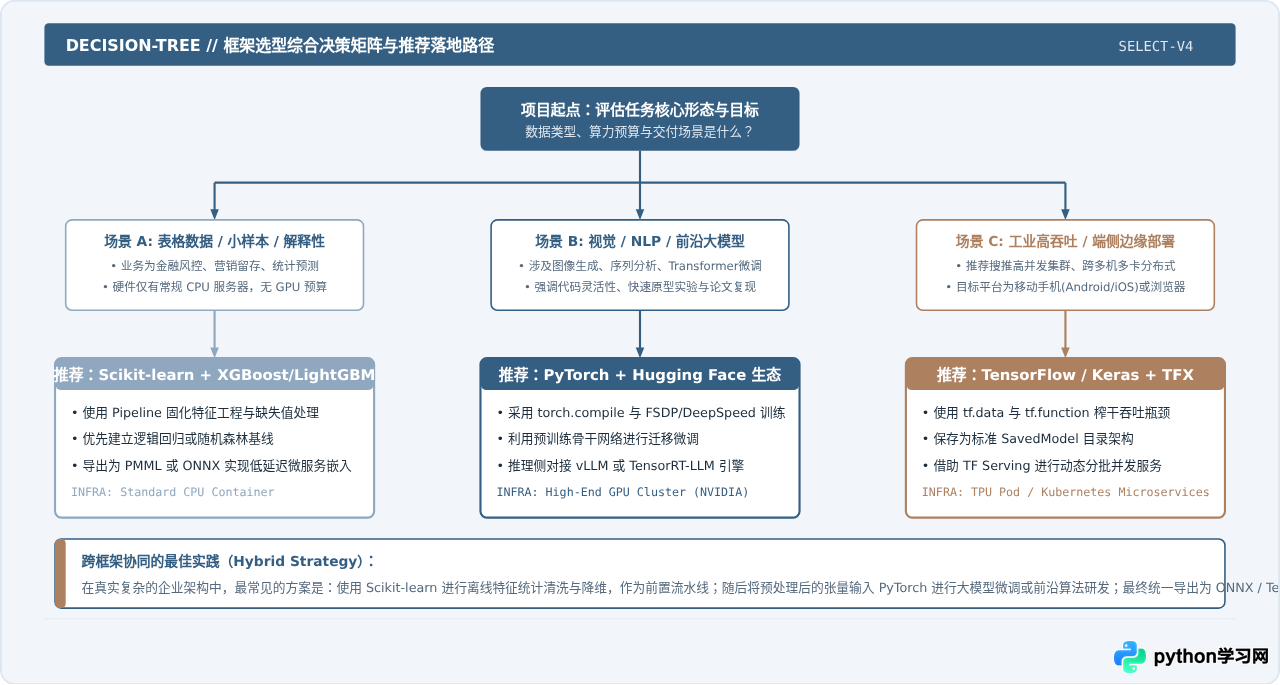
技术落地总结建议:初学者或业务初创团队建议以 Scikit-learn 快速搭建基线,在明确验证业务痛点确实需要深层表示学习或生成能力后,再转向 PyTorch 进行模型探索。在生产上线环节,应尽早将模型架构与具体训练框架解耦,通过 ONNX 规范打通上下游,以最低的技术负债获取最高的业务敏捷度。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









