

Python数据科学与AI主流框架解析:从Pandas到PyTorch
深入解析Python数据科学与AI核心技术栈:从Pandas表格清洗、NumPy底层数组计算,到Scikit-Learn经典机器学习建模与PyTorch深度学习动态张量计算,全面剖析数据流转、内存映射机制与工程选型边界。
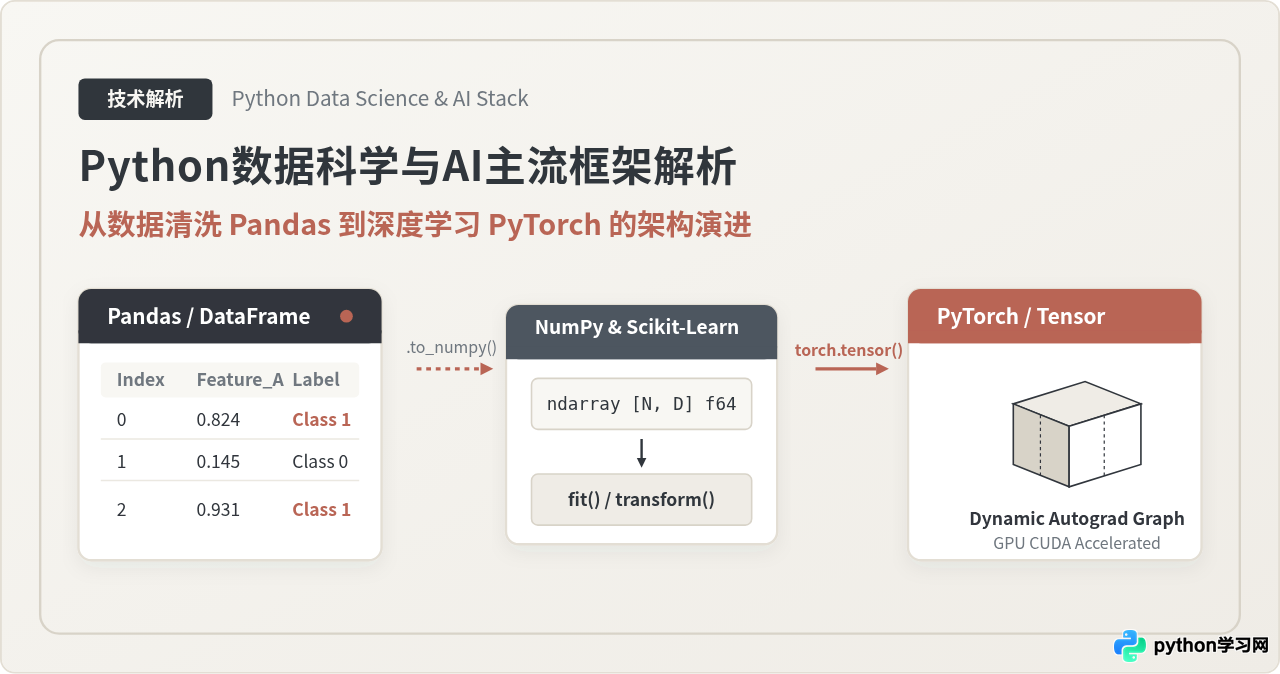
在现代Python数据科学与AI技术体系中,Pandas、NumPy、Scikit-Learn与PyTorch并非相互替代的孤立工具,而是构成了一条层次清晰的计算流水线:Pandas负责异构业务数据的清洗与聚合,NumPy提供高效的多维数值数组与底层计算基石,Scikit-Learn统一了经典机器学习的特征变换与评估规范,而PyTorch则主导高维张量运算、自动求导与GPU加速的深度学习建模。理解它们各自的抽象层级、底层内存机制与工程分水岭,是构建高吞吐、零冗余数据科学与AI系统的核心前提。
一、核心框架谱系与数据形态演进
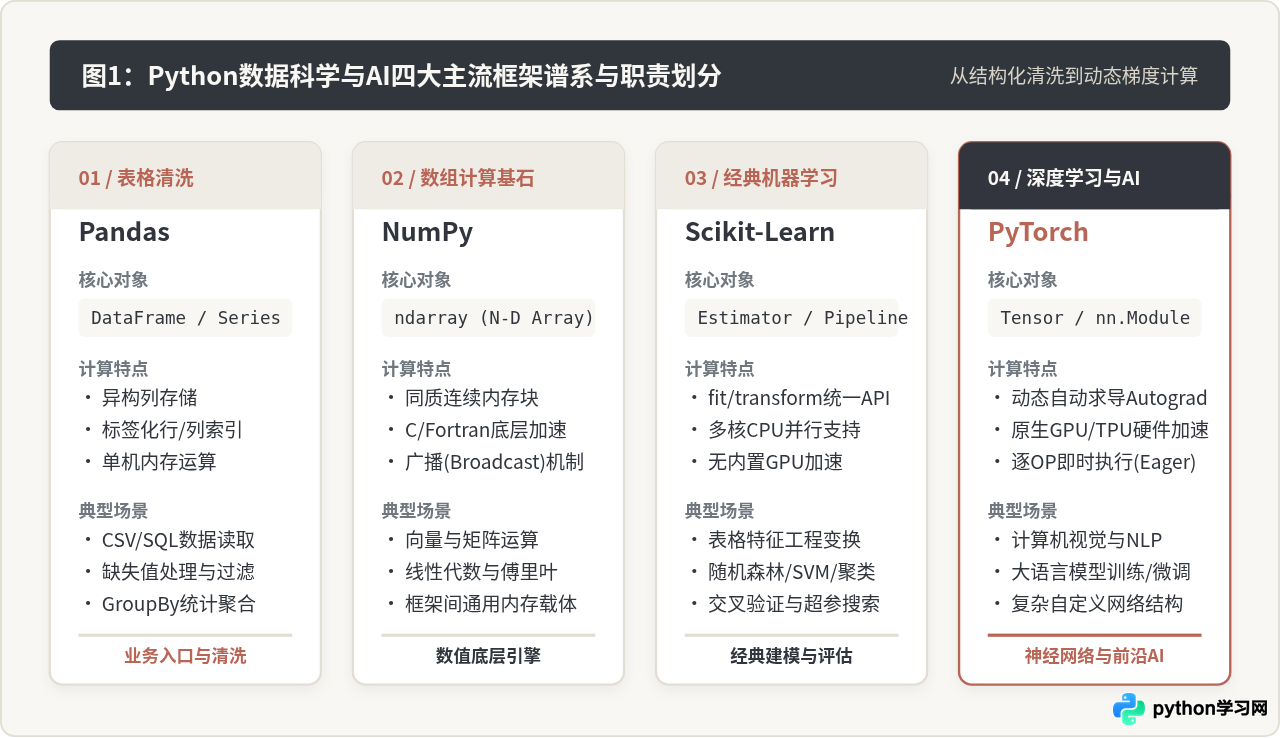
面对真实世界的业务问题,数据最初往往以包含文本、日期、枚举值和缺失值的异构表格形式存在。机器算法无法直接消化这类杂乱格式,必须经历“表格清洗 → 数值矩阵化 → 特征工程 → 高维计算图”的形态演进。四大框架正是为了对应这四个阶段而设计:
- Pandas(业务层与异构清洗): 核心为
DataFrame与Series。它在内存中以基于类型的BlockManager管理多列数据,允许各列拥有不同数据类型(如浮点数、字符串、时间戳),并支持复杂的行/列标签索引、连接合并与分组聚合。 - NumPy(数值计算与内存基石): 核心为
ndarray。它要求数据类型必须完全同质(Homogeneous),在连续物理内存中组织高维数值,依托底层高效的 BLAS/LAPACK 库执行向量化算子,是所有上层框架通用的内存载体。 - Scikit-Learn(经典机器学习范式): 核心为
Estimator与Pipeline。它建立在 NumPy 数组之上,统一了fit()、transform()、predict()的面向对象接口,针对结构化表格数据的分类、回归、聚类和降维提供了工业级稳定实现。 - PyTorch(深度学习与动态张量图): 核心为
Tensor与nn.Module。在保留类 NumPy 多维数组 API 的同时,它原生支持 GPU/TPU 硬件加速与基于反向传播的动态自动求导机制(Autograd),专为深层非线性拓扑网络而生。
二、跨框架数据流转与底层内存机制
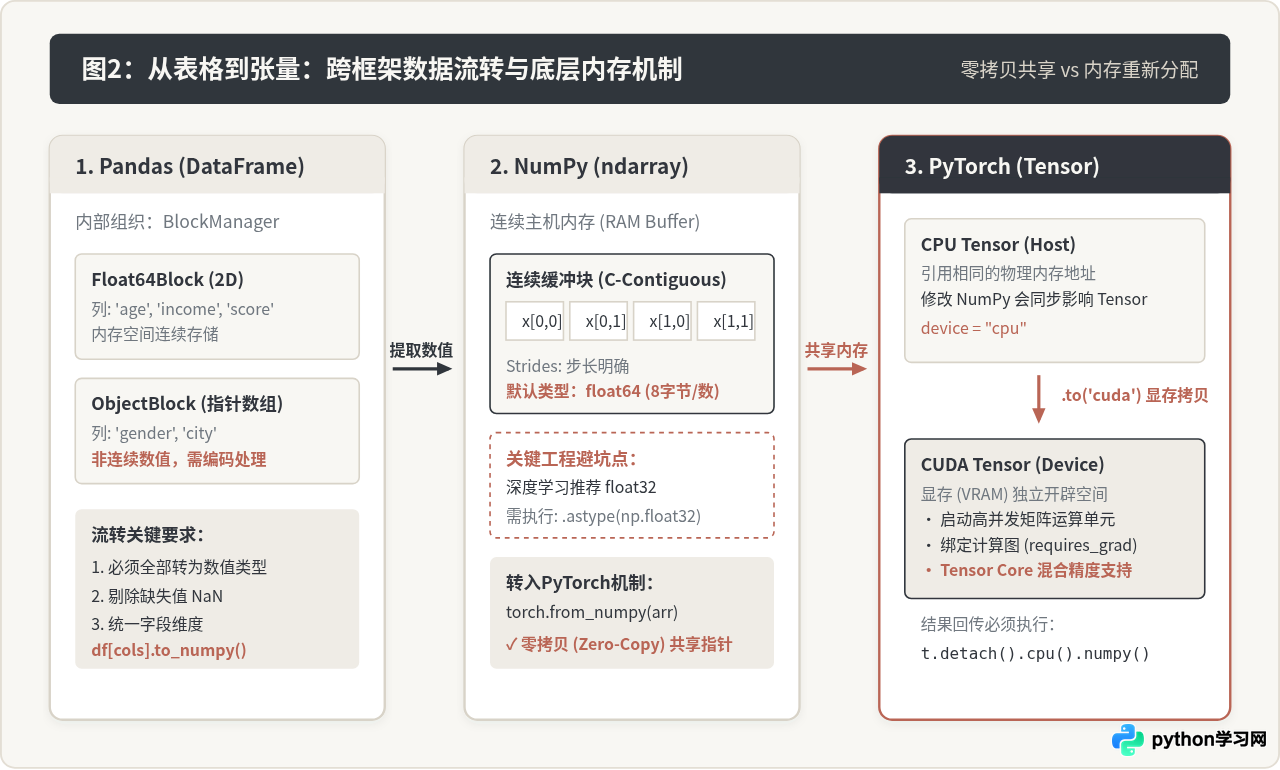
跨框架协作时最常遇到的性能损耗和诡异 Bug,多源自对底层内存布局与数据类型约定的误解。从 Pandas 表格转化到 PyTorch 张量,本质上是一次从“散列异构块”到“连续内存指针”,再到“显存缓冲区”的流转过程。
1. 内存共享与零拷贝机制
当从 Pandas 提取纯数值列时,调用 df.to_numpy()(推荐替代旧版 .values)会将各列整合成连续的 NumPy ndarray。随后使用 torch.from_numpy(arr) 将其转为 PyTorch CPU 张量时,PyTorch 会直接复用该 NumPy 数组在主机内存中的起始指针,实现真正的零拷贝(Zero-Copy)。
但需注意:一旦修改其中一方的数值,另一方将同步改变。如果需要独立副本,应显式使用 torch.tensor(arr) 或 arr.copy()。而当调用 tensor.to('cuda') 时,数据必须通过 PCIe 总线复制至 GPU 显存,此时一定会发生物理内存分配。
2. 数据类型(dtype)的隐藏陷阱
Pandas 和 NumPy 在处理浮点数时,默认采用双精度 float64(占用 8 字节)。而在深度学习框架 PyTorch 中,标准运算精度为单精度 float32(占用 4 字节),现代显卡的 Tensor Core 对 float32/bfloat16 提供了数倍于 float64 的硬件吞吐加速。
如果未显式转换数据类型,torch.from_numpy(df.to_numpy()) 会生成 torch.float64 张量,导致 GPU 显存占用直接翻倍,且无法调用 CUDA 优化的单精度矩阵乘法核函数(GEMM),拖慢数倍训练速度。正确做法是在转换时显式指定 .astype(np.float32)。
import numpy as np
import pandas as pd
import torch

# 示例:构建原始业务表格
df = pd.DataFrame({
    'feature_age': [25.0, 32.0, 47.0, 19.0],
    'feature_income': [52000.0, 89000.0, 120000.0, 31000.0],
    'category_city': ['Beijing', 'Shanghai', 'Shenzhen', 'Beijing'],
    'target': [0, 1, 1, 0]
})

# 步骤 1:Pandas 阶段 - 缺失值处理与分类变量数值化
df_clean = pd.get_dummies(df, columns=['category_city'], drop_first=True)
feature_cols = [c for c in df_clean.columns if c != 'target']

# 步骤 2:NumPy 阶段 - 提取同质数值数组,强制对齐为 float32
X_np = df_clean[feature_cols].to_numpy(dtype=np.float32)
y_np = df_clean['target'].to_numpy(dtype=np.int64)

# 步骤 3:PyTorch 阶段 - 零拷贝接入 CPU 张量
X_tensor = torch.from_numpy(X_np)
y_tensor = torch.from_numpy(y_np)

# 验证零拷贝特性:共享底层物理内存
X_np[0, 0] = 999.0
print(f"验证零拷贝 (X_tensor[0,0] 应为 999.0): {X_tensor[0, 0].item()}")

# 步骤 4:显存迁移(若 GPU 可用)
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
X_gpu = X_tensor.to(device)
print(f"张量就绪:设备={X_gpu.device}, 形状={X_gpu.shape}, 类型={X_gpu.dtype}")
# 示例输出:
# 验证零拷贝 (X_tensor[0,0] 应为 999.0): 999.0
# 张量就绪:设备=cpu, 形状=torch.Size([4, 4]), 类型=torch.float32
三、任务分水岭与建模范式比对:Scikit-Learn vs PyTorch
Scikit-Learn 与 PyTorch 代表了两种截然不同的工程设计哲学。选择哪一个框架,取决于数据结构维度、算力瓶颈位置以及对模型控制粒度的要求。
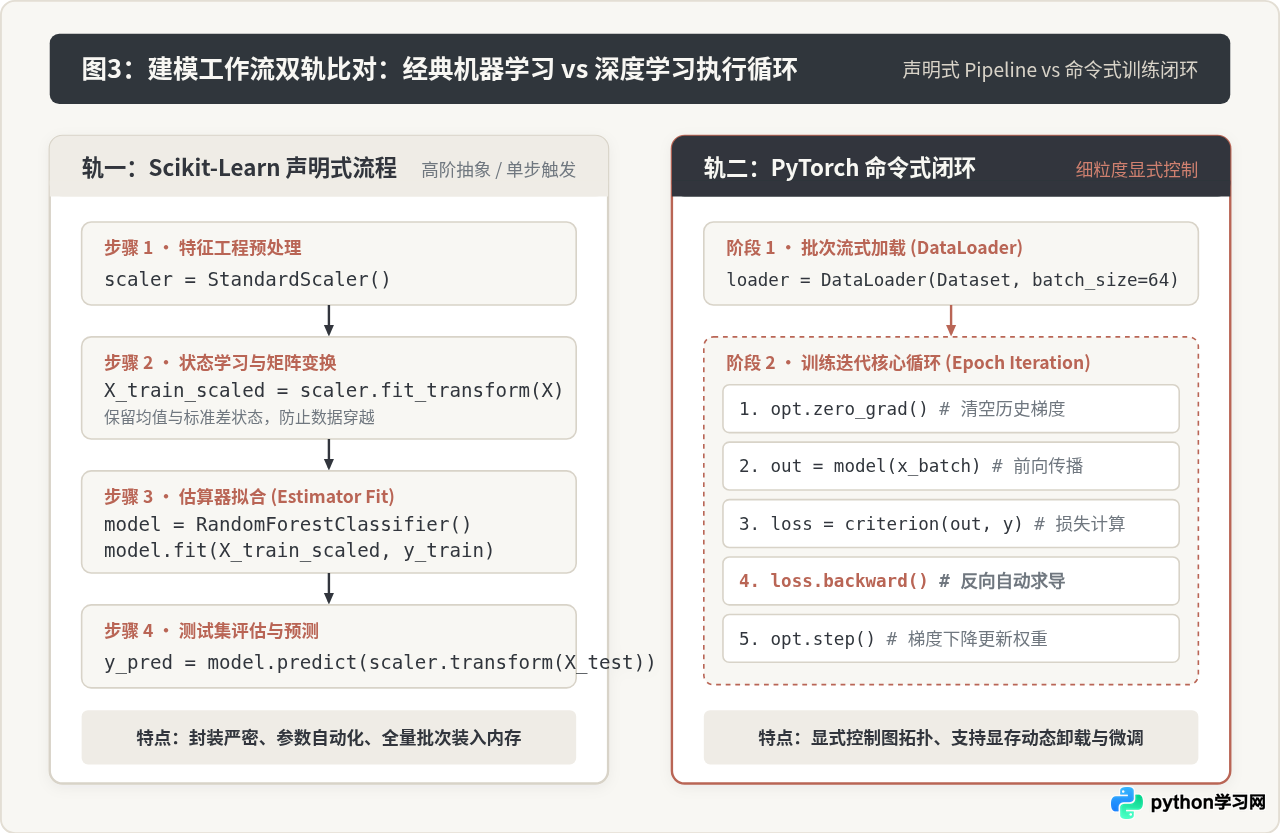
1. 声明式 Pipeline 与命令式训练循环
Scikit-Learn 采用极度封装的声明式设计:特征标准化、主成分分析与分类器通过 Pipeline 串联为一个黑盒整体。调用一次 pipeline.fit(X, y) 即可在底层完成全量参数优化,开发者无需关心梯度的反向传播与学习率调度。
PyTorch 则采用完全开放的命令式执行范式(Eager Execution):开发者需要显式定义数据加载批次(DataLoader)、构建前向传播拓扑、定义损失函数,并手动在一个外层 epoch 循环内执行 zero_grad() → backward() → step() 的完整五步法。这种设计将控制权完全下放给开发者,使得定制复杂的注意力机制、自监督损失或多分支输出变得极为自然。
2. 代码范式直观对比
为了直观展示两种建模模式的差异,以下列出完成同一分类任务时两个框架的标准写法:
# ================= 范式 A:Scikit-Learn 声明式流水线 =================
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier

# 4行代码完成预处理与模型绑定,接口一致
pipe = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', RandomForestClassifier(n_estimators=100, random_state=42))
])
pipe.fit(X_np, y_np)
y_pred_sklearn = pipe.predict(X_np)


# ================= 范式 B:PyTorch 显式命令式训练闭环 =================
import torch
import torch.nn as nn
from torch.utils.data import TensorDataset, DataLoader

# 1. 显式定义网络拓扑
class SimpleClassifier(nn.Module):
    def __init__(self, in_features):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(in_features, 16),
            nn.ReLU(),
            nn.Linear(16, 2)
        )
    def forward(self, x):
        return self.net(x)

# 2. 显式组装批次流
dataset = TensorDataset(torch.from_numpy(X_np), torch.from_numpy(y_np))
loader = DataLoader(dataset, batch_size=2, shuffle=True)

# 3. 显式配置组件
model = SimpleClassifier(in_features=X_np.shape[1])
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

# 4. 显式迭代循环
for epoch in range(5):
    for batch_x, batch_y in loader:
        optimizer.zero_grad()               # 1. 梯度清零
        outputs = model(batch_x)            # 2. 前向传播
        loss = criterion(outputs, batch_y)  # 3. 损失计算
        loss.backward()                     # 4. 反向求导
        optimizer.step()                    # 5. 权重更新
四、工程实战排错与常见性能陷阱
将数据从分析环境投入生产流水线时,以下四个高频隐患极易引发内存泄漏或训练异常:
1. 误将张量直接留存引发 GPU 显存泄漏
在 PyTorch 训练循环中记录损失值时,如果编写 total_loss += loss,由于 loss 张量附带了整张反向计算图的上下文引用,会导致整轮迭代的激活值全部驻留在显存中无法释放,经过数个 epoch 就会抛出 CUDA out of memory。
解决办法: 记录数值时必须使用 loss.item() 提取原生 Python 浮点数标量,彻底脱离计算图。对于评估阶段,外层务必包裹 with torch.no_grad():。
2. PyTorch DataLoader 多进程中引用 Pandas 对象引发内存放大
在实现自定义 torch.utils.data.Dataset 时,部分开发者习惯将完整的 Pandas DataFrame 作为属性直接存入 self.df,并在 __getitem__ 中通过 iloc 索引。在 Linux 环境下,当 DataLoader(num_workers > 0) 采用 fork 启动子进程时,Python 引用计数器的修改会频繁破坏内存写时复制(Copy-on-Write),导致内存瞬间膨胀数倍甚至被 OOM Killer 杀掉。
解决办法: 在 Dataset.__init__ 阶段,就提前将 Pandas 表格全部转化为 NumPy 连续数组或 CPU 张量,在 __getitem__ 中只执行纯数组切片。
3. Pandas 隐式拷贝导致特征失真
在对表格切片做特征衍生时,若使用类似 df_sub['new_feat'] = 1 的语法,可能触发 SettingWithCopyWarning。这表示当前操作是在临时视图还是在独立副本上存在不确定性。如果不加理会,传给下游模型的特征可能根本未被正确更新。
解决办法: 在提取子数据集时显式调用 df.loc[mask, cols].copy(),切断视图关联。
五、技术选型决策路径与工程边界
在实际项目架构评审中,不加权衡地全盘引入“最重”的技术栈往往是技术负债的开端。框架的优劣取决于应用场景的约束条件:
| 对比维度 | Pandas + Scikit-Learn | NumPy + GBDT 生态 (XGB/LGB) | PyTorch 深度学习 |
|---|---|---|---|
| 核心数据形态 | 结构化表格、低维稀疏矩阵 | 稠密数值矩阵、类别特征编码 | 高维张量、序列、图像、图拓扑 |
| 硬件算力依赖 | 多核 CPU 单机内存(RAM) | 多核 CPU / 支持可选 GPU 插件 | 强烈依赖 CUDA / GPU 集群显存 |
| 样本规模适应 | < 1,000 万行表格数据 | 10 万 ~ 数亿行稠密表格 | 海量数据,依赖流式 DataLoader |
| 模型解释性 | 极高(线性系数、决策路径、P值) | 高(SHAP 值、特征重要度增益) | 低(黑盒隐层,需特定探针归因) |
| 工程迭代周期 | 极快,几小时内即可完成 Baseline | 快,表格数据工业落地的标杆首选 | 较重,需细致调优架构、超参和学习率 |
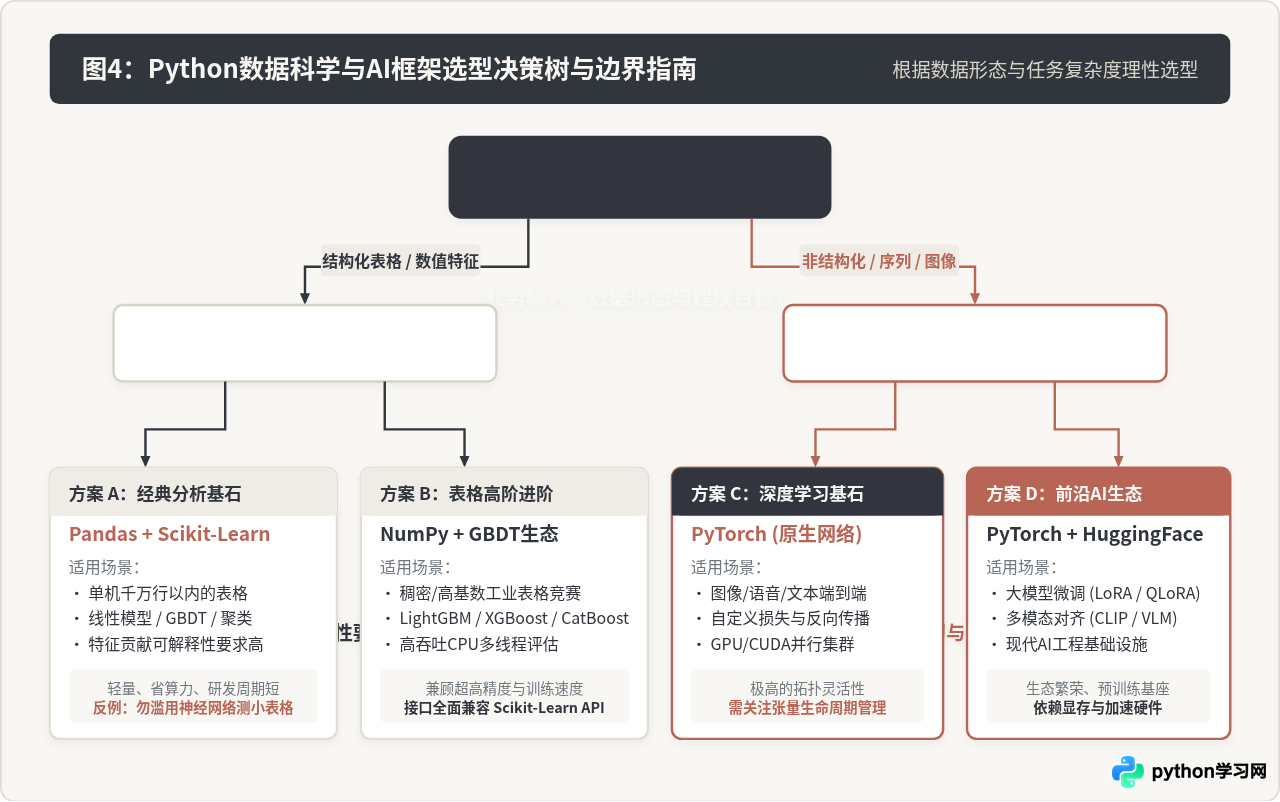
理性选型的两条反例法则
- 反例一:在小规模表格数据上盲目使用深度全连接网络(MLP)。 当数据量仅有几千到几万行时,使用 PyTorch 搭建的神经网络在泛化能力和鲁棒性上往往明显逊于经过调优的随机森林或 LightGBM,且会平白增加数十倍的训练与维护开销。表格数据首选仍是基于决策树集成的 GBDT。
- 反例二:试图用 Scikit-Learn 去训练动态图神经网络或大语言模型。 Scikit-Learn 的架构假设所有样本矩阵一次性或在单机内存中完成迭代,不具备张量流式微调、梯度累积、分布式数据并行(DDP)和混合精度加速能力。面对多模态和非结构化表征,应当果断切换到 PyTorch。
总结与全篇实践建议
从 Pandas 到 PyTorch,构建现代化 Python AI 系统的精髓在于让合适的工具留在其最擅长的边界内:用 Pandas 清理异构脏数据,用 NumPy 锁定同质数值基石,在结构化特征和基线验证上充分发挥 Scikit-Learn 的严谨高阶封装,当遭遇复杂非线性、高维感知数据和分布式算力诉求时,再顺畅过渡到 PyTorch 展开深层张量运算。遵循这一阶梯式技术路径,既能保证研发初期的敏捷交付,也能为未来的大规模模型演进筑牢底层扩展能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









