

Python人工智能开发必备库:TensorFlow、PyTorch与Scikit-learn

在现代Python人工智能与机器学习工程中,Scikit-learn、PyTorch与TensorFlow构成了绝大多数项目的底层基础设施。构建一个AI系统并不需要孤立地在三者之间做排他性抉择,而是根据输入数据形态、模型复杂度要求以及上线运行环境,精确将不同工具配置在研发管线的对应环节。本文直接梳理这三大库的核心定位、运行机制、代码实现流程与工业选型准则。
一、三大核心库的工程定位与核心分工
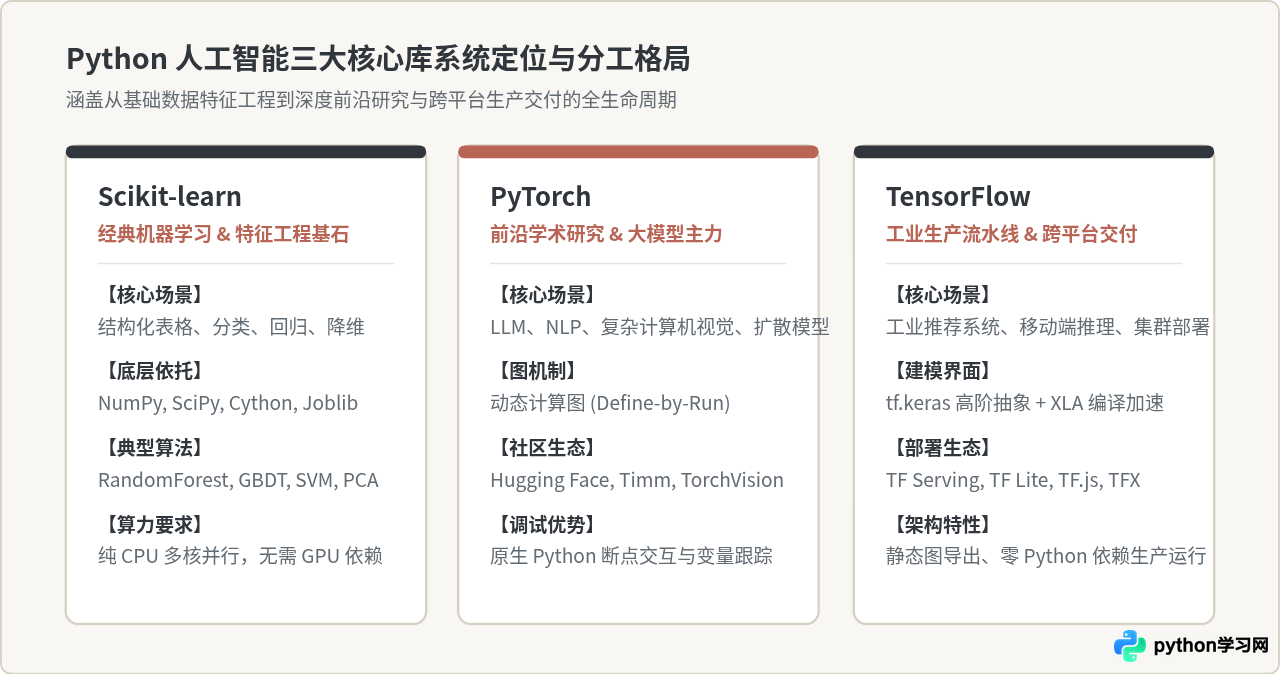
Python之所以成为人工智能领域的主导语言,核心在于其拥有分层清晰、各司其职的计算生态。初涉该领域的开发者常误以为三者是同一层级的直接竞争对手,但从实际工程链路审视,它们分别掌管传统统计学习、前沿深度神经网络研发以及工业级分布式交付三个核心领域。
- Scikit-learn:专注于传统统计机器学习算法与数据前处理。它建立在NumPy、SciPy与Joblib之上,不依赖GPU加速,以极高的一致性和轻量级接口处理表格化结构数据。
- PyTorch:由Meta主导并受到学术界与大模型社区广泛推崇的深度学习框架。其核心优势在于即时执行的动态计算图(Imperative / Dynamic Computation Graph),在自然语言处理(NLP)、生成式大模型及计算机视觉原型开发中占据核心地位。
- TensorFlow:由Google主导的端到端深度学习生产平台。通过高层API(tf.keras)降低建模门槛,同时拥有成熟的TensorFlow Serving、TensorFlow Lite和TensorFlow.js,在跨端多平台生产部署与大规模集群吞吐上具有深厚积累。
二、标准开发范式与工作流步骤拆解
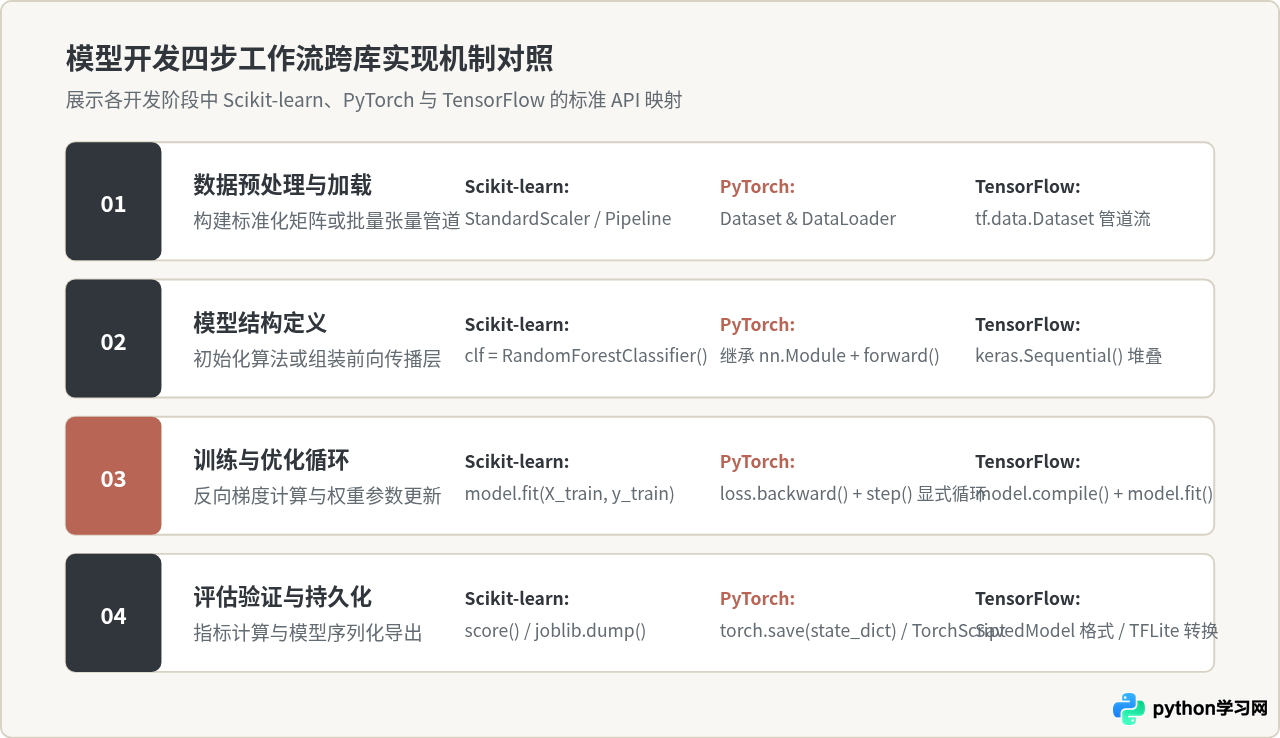
尽管这三个库的设计哲学不同,但完成一个完整的AI任务通常均遵循“数据预处理 → 模型搭建 → 训练迭代 → 评估与导出”的四个阶段。理解各库在每一阶段的具体实现范式,有助于厘清代码组织结构。
三、核心库代码实现与实操对比
1. Scikit-learn:以结构化分类任务为例
Scikit-learn的API设计被称为业界规范范例。其核心哲学是“一切皆评估器(Estimator)”,通过统一的 fit() 训练模型,通过 transform() 进行数据转换,通过 predict() 生成预测结果。
import numpy as np
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report

# 1. 加载数据并拆分
X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 2. 特征标准化处理
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)

# 3. 初始化分类器并训练
clf = RandomForestClassifier(n_estimators=100, random_state=42)
clf.fit(X_train, y_train)

# 4. 模型预测与性能指标报告
y_pred = clf.predict(X_test)
print(classification_report(y_test, y_pred))
这段代码简洁清晰,适用于几乎所有表格化数据。Scikit-learn不仅封装了算法,还提供了交叉验证(cross_val_score)、超参数网格搜索(GridSearchCV)等完备的辅助工具。
2. PyTorch:显式控制的动态神经网络
PyTorch的核心理念是“Define-by-Run(按运行定义)”。网络是一个标准的Python类,继承自 torch.nn.Module。前向传播过程由普通的Python控制流组织,训练循环需要开发者显式编写梯度清零、反向传播与优化器步进。
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset

# 1. 构造张量数据并封装为批次管道
X_tensor = torch.randn(1000, 20)
y_tensor = torch.randint(0, 2, (1000,))
dataset = TensorDataset(X_tensor, y_tensor)
loader = DataLoader(dataset, batch_size=32, shuffle=True)

# 2. 面向对象构建神经网络
class BinaryClassifier(nn.Module):
    def __init__(self, input_dim):
        super(BinaryClassifier, self).__init__()
        self.fc1 = nn.Linear(input_dim, 64)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(64, 2)

    def forward(self, x):
        return self.fc2(self.relu(self.fc1(x)))

model = BinaryClassifier(input_dim=20)
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)

# 3. 显式训练循环(透明掌控每一步)
model.train()
for epoch in range(5):
    for batch_x, batch_y in loader:
        optimizer.zero_grad()               # 清除历史累计梯度
        outputs = model(batch_x)            # 前向计算
        loss = criterion(outputs, batch_y)  # 计算损失
        loss.backward()                     # 反向自动求导
        optimizer.step()                    # 权重更新
显式循环虽然增加了几行代码,但在需要修改损失计算逻辑、添加对抗扰动或实施多任务联合梯度裁剪时,给予了开发者完全的自由度,这也是深度学习研究人员首选PyTorch的关键原因。
3. TensorFlow (Keras):工业化封装与声明式建模
现代TensorFlow(2.x及以上)将Keras确立为核心高级API。对于绝大多数常规深度学习应用,开发者无需手动书写反向传播循环,只需调用声明式的 compile() 与 fit()。
import tensorflow as tf
from tensorflow.keras import layers, models

# 1. 模拟生成数据集
import numpy as np
X_data = np.random.randn(1000, 20).astype(np.float32)
y_data = np.random.randint(0, 2, size=(1000,)).astype(np.int32)

# 2. 高阶声明式顺序网络定义
model = models.Sequential([
    layers.Input(shape=(20,)),
    layers.Dense(64, activation='relu'),
    layers.Dense(2, activation='softmax')
])

# 3. 声明优化目标、损失函数与评价指标
model.compile(
    optimizer='adam',
    loss='sparse_categorical_crossentropy',
    metrics=['accuracy']
)

# 4. 执行训练迭代与校验
history = model.fit(
    X_data, y_data,
    epochs=5,
    batch_size=32,
    validation_split=0.2,
    verbose=1
)

# 5. 导出为可供线上跨语言调用的 SavedModel 格式
# model.save('saved_model/my_serving_model')tf.GradientTape 手写训练步),但在日常实践中,若不需要深度自定义算子,其标准工作流以高层Keras封装结合 tf.data 数据管道为主。
四、底层运行机制与计算图模式差异
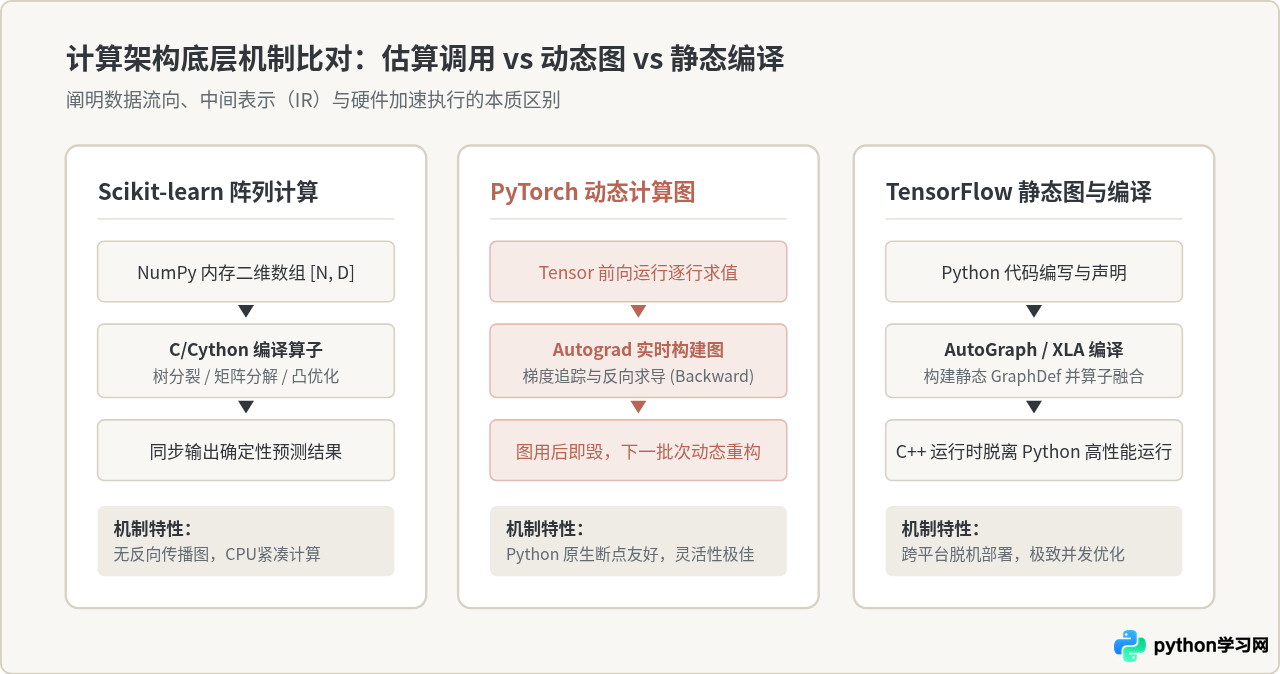
选择或理解这三个库,最根本的区分点在于它们在内存中如何组织数学计算与数据流图。从确定性算法的即时计算,到基于计算图的自动微分,其底层架构直接决定了调试体验与运行效率。
五、多维度技术选型决策框架
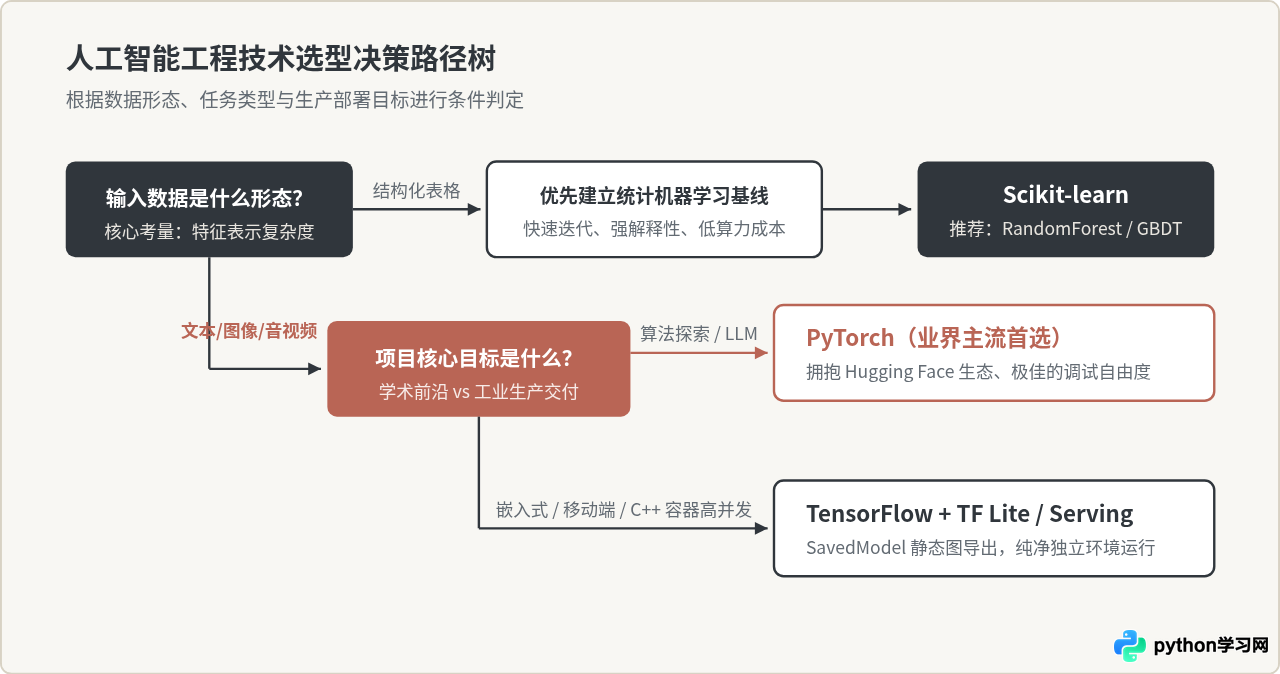
面对具体业务场景,如何快速敲定首选工具?选型不应根据流行度或主观喜好,而应根据以下四个硬性指标决定:
- 数据类型与规模:如果输入是几千至数百万行结构化关系型表格、统计特征明确,优先使用
Scikit-learn(或其集成的GBDT扩展库如LightGBM/XGBoost),其训练速度与性价比通常远优于在GPU上盲目堆砌深度神经网络。如果是图像、语音、自然语言文本或多模态时序,必须进入深度学习框架。 - 业务目标是算法研发还是既有服务落地:如果处于算法探索期,需要参考最新学术论文、复现开源模型或设计特殊的层结构,
PyTorch是事实上的首选;如果是将成熟模型集成入现有的大规模C++微服务、Android/iOS终端或嵌入式硬件,TensorFlow(及其Lite工具链)提供了极其平滑的开箱支持。 - 硬件与运维成本:Scikit-learn完全基于标准通用CPU多核,无CUDA驱动依赖,部署容器体积极小(通常在百兆内);而PyTorch与TensorFlow环境通常伴随庞大的CUDA运行库与几百兆甚至数G的依赖。
六、总结与工程落地建议
在实际生产系统中,最佳实践往往是组合使用这三大库,而不是非此即彼:
| 对比维度 | Scikit-learn | PyTorch | TensorFlow (Keras) |
|---|---|---|---|
| 核心领域 | 经典统计机器学习、数据预处理 | 前沿深度学习、LLM、多模态研究 | 工业级流水线、跨平台部署与服务化 |
| 计算图模型 | 无计算图(CPU 直接数组运算) | 动态图(Define-by-Run,即时构建) | 静态图优化(AutoGraph / XLA 编译) |
| 硬件依赖 | 仅 CPU,轻量无额外运行时驱动 | 强依赖 CUDA/MPS 等硬件加速平台 | 支持 CPU/GPU/TPU,跨端适配全面 |
| 学习曲线 | 平缓,API 统一且高度封装规范 | 中等,符合 Python 直觉,调试友好 | 入门简单(Keras),进阶底层相对复杂 |
| 典型搭配方式 | 负责特征工程与基线模型构建 | 负责复杂模型架构探索与权重训练 | 负责模型固化、量化压缩与后端部署 |
典型的现代化工业架构是:使用 Scikit-learn 完成清洗、编码、离散化及构建初步可解释基线;当确定需要深度表征时,在 PyTorch 环境中快速实验前沿架构与预训练权重;而在最终需要将模型交付至边缘设备(如移动端App)或要求零 Python 运行时的分布式推理集群时,借助 TensorFlow Lite 或 ONNX 中间格式进行落地固化。掌握三者的各自特长,方能在人工智能项目开发中游刃有余。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









