

Python机器学习入门常用库:Scikit-learn、TensorFlow与PyTorch
深入解析Python机器学习领域三大核心库Scikit-learn、TensorFlow与PyTorch的定位差异、核心工作流、代码实践与初学者选型路径。
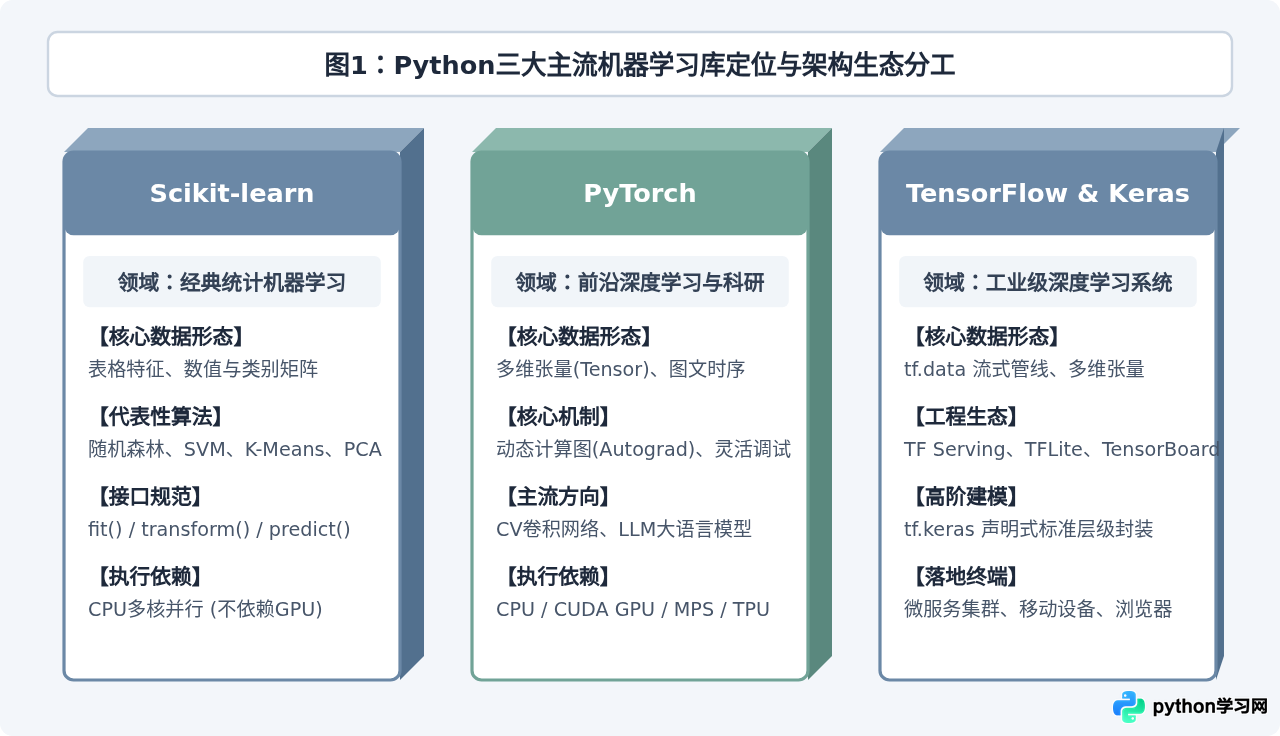
在 Python 机器学习生态中,初学者常因库的选择过多而感到迷茫。实际上,学习路线并不需要面面俱到,核心分界线在于任务形态:处理表格数据与传统统计建模首选 Scikit-learn;深入计算机视觉、自然语言处理等前沿深度学习任务且注重灵活实验首选 PyTorch;构建工业级管道、端侧轻量化及跨平台微服务部署则优先考虑 TensorFlow(包含 Keras)。本文将清晰拆解这三大基础库的核心定位、使用步骤、基础代码示例与具体选型依据。
一、Scikit-learn:传统机器学习与结构化数据处理的基石
Scikit-learn(简称 sklearn)是建立在 NumPy、SciPy 与 Matplotlib 之上的经典开源算法库。如果面对的是 Excel 表格、CSV 文件、数据库抽取特征等具有明确列名(结构化属性)的数据集,Scikit-learn 通常是最快、最稳妥的基准算法实现库。
1. 核心设计哲学:高内聚的一致性接口
Scikit-learn 最显著的特点是所有算法均遵循高度统一的面向对象设计规范,极大降低了切换不同算法时的认知成本:
- 估计器(Estimator):所有模型(如分类器、回归器)均使用
fit(X, y)接收特征矩阵与标签并完成训练。 - 转换器(Transformer):用于数据预处理与特征变换的对象(如标准化、编码器),使用
fit()提取参数,使用transform()完成矩阵变换,或用fit_transform()一步完成。 - 预测器(Predictor):训练后的模型均提供
predict(X)输出离散类别或连续数值,分类任务通常还提供predict_proba(X)输出各类别的置信概率。
2. 典型实战代码:Pipeline管道集成与模型训练
在实际工程中,避免在训练集和测试集之间发生“数据泄露(Data Leakage)”至关重要。使用 Pipeline 可以将标准化与随机森林分类器组合成原子化流水线:
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.pipeline import Pipeline
from sklearn.metrics import accuracy_score, classification_report

# 1. 模拟生成结构化分类数据(1000条样本,10个特征)
X, y = make_classification(
    n_samples=1000,
    n_features=10,
    n_informative=7,
    random_state=42
)

# 2. 划分训练集与测试集(固定随机种子确保复现性)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 3. 构建原子化流水线:标准化 -> 随机森林分类器
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('rf', RandomForestClassifier(n_estimators=100, max_depth=6, random_state=42))
])

# 4. 训练拟合
pipeline.fit(X_train, y_train)

# 5. 验证预测与结果评估
y_pred = pipeline.predict(X_test)
acc = accuracy_score(y_test, y_pred)
print(f"测试集准确率: {acc:.4f}")
print("分类报告示例:\n", classification_report(y_test, y_pred, digits=4))
n_jobs=-1 多核并行,但它无法直接调用 GPU 显存加速计算。如果遇到百万行以上的高维稠密非结构化特征(如图像像素、音频频谱),请转用深度学习框架。
二、PyTorch:灵活直观的动态图深度学习框架
PyTorch 由 Meta 人工智能研究院主导维护。其凭借命令式(Imperative)编程模型和即时求导机制(Dynamic Computational Graph),成为近年来计算机视觉(CV)、自然语言处理(NLP)及大语言模型(LLM)研发领域的绝对主流工具。
1. 为什么研究人员与工程师青睐 PyTorch?
- 动态图机制(Eager Execution):在代码逐行运行的同时动态构建计算图。开发者可以直接使用 Python 原生断点(如
pdb或 IDE 单步调试)检查中间层 Tensor 的形状与数值,无须等待图编译完成。 - Pythonic 设计范式:代码风格高度贴合 Python 习惯,张量(Tensor)的操作语法与 NumPy 几乎一致,可在 CPU 与 CUDA GPU 之间轻松迁移。
- 庞大的前沿开源生态:Hugging Face(Transformers 库)、Timm(视觉模型库)等开源项目均以 PyTorch 作为第一公民支持。
2. 典型实战代码:自定义全连接神经网络
以下示例展示了继承 torch.nn.Module 构建前馈神经网络的标准过程,涵盖前向传播、损失函数计算与反向梯度清空:
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 检查计算设备(优先选用 GPU 加速,无卡时自动回退至 CPU)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

# 2. 定义神经网络架构
class SimpleBinaryClassifier(nn.Module):
    def __init__(self, input_dim):
        super(SimpleBinaryClassifier, self).__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, 32),
            nn.ReLU(),
            nn.Linear(32, 1) # 输出未激活的 Logits
        )

    def forward(self, x):
        return self.network(x)

# 3. 准备微型张量数据(500个样本,8维特征)
torch.manual_seed(42)
X_data = torch.randn(500, 8).to(device)
y_data = torch.randint(0, 2, (500, 1)).float().to(device)

# 4. 实例化模型、损失函数与优化器
model = SimpleBinaryClassifier(input_dim=8).to(device)
criterion = nn.BCEWithLogitsLoss()
optimizer = optim.Adam(model.parameters(), lr=0.01)

# 5. 标准训练循环迭代(以 5 个 epoch 为例)
model.train()
for epoch in range(1, 6):
    optimizer.zero_grad()               # 关键步骤:清空历史累加梯度
    outputs = model(X_data)             # 前向传播
    loss = criterion(outputs, y_data)   # 计算损失
    loss.backward()                     # 反向传播计算导数
    optimizer.step()                    # 沿梯度方向更新网络权重
    print(f"Epoch [{epoch}/5], Loss: {loss.item():.4f}")
backward() 时累加梯度,因此在每一次新的参数更新前,必须显式调用 optimizer.zero_grad()。在验证阶段,切记包裹 with torch.no_grad(): 以关闭自动求导,节省显存开销。
三、TensorFlow 与 Keras:工业级部署与工程化落地
TensorFlow 是 Google 开发的工业级端到端开源机器学习平台。自 2.0 版本起,TensorFlow 全面将高阶易用的 Keras 作为核心标准 API,同时保留了底层的生产就绪基础设施,是工业界模型部署最为成熟的方案之一。
1. 工业级工程体系的核心支撑
- Keras 高阶封装:使用声明式的
Sequential或函数式 API(Functional API),几行代码即可完成层堆叠、编译(compile)与模型拟合(fit)。 - 生产落地生态完整:官方提供
TensorFlow Serving(高并发 C++ gRPC/REST 服务)、TensorFlow Lite(移动端及物联网嵌入式部署)以及TensorFlow.js(浏览器端推理)。 - 可视化与监控:内建的
TensorBoard能实时监控权重分布、计算图拓扑、损失收敛曲线及性能瓶颈分析。
2. 典型实战代码:Keras 标准流水线构建
利用 Keras 快速实现等价的二分类模型,直观感受其结构清晰度与高度内聚的接口:
import numpy as np
import tensorflow as tf
from tensorflow.keras import layers, models

# 1. 构造演示数据
np.random.seed(42)
X_train = np.random.randn(500, 8).astype(np.float32)
y_train = np.random.randint(0, 2, size=(500, 1)).astype(np.float32)

# 2. 构建序贯模型(Sequential)
model = models.Sequential([
    layers.Input(shape=(8,)),
    layers.Dense(32, activation='relu'),
    layers.Dense(1, activation='sigmoid') # 直接输出 [0, 1] 概率
])

# 3. 编译模型:指定优化器、损失函数与评估指标
model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=0.01),
    loss='binary_crossentropy',
    metrics=['accuracy']
)

# 4. 执行训练与批量拟合
history = model.fit(
    X_train, y_train,
    epochs=5,
    batch_size=32,
    verbose=1
)

# 5. 导出标准化生产部署模型格式(SavedModel)
# model.save("saved_model_dir/my_classifier")
tf.keras 即可满足绝大多数任务需求。在需要工业上线时,直接导出为 SavedModel 格式,无需编写繁杂的包装脚本即可无缝塞入 Docker 容器中供 C++ 服务调用。
四、机器学习工程全流程步骤演练
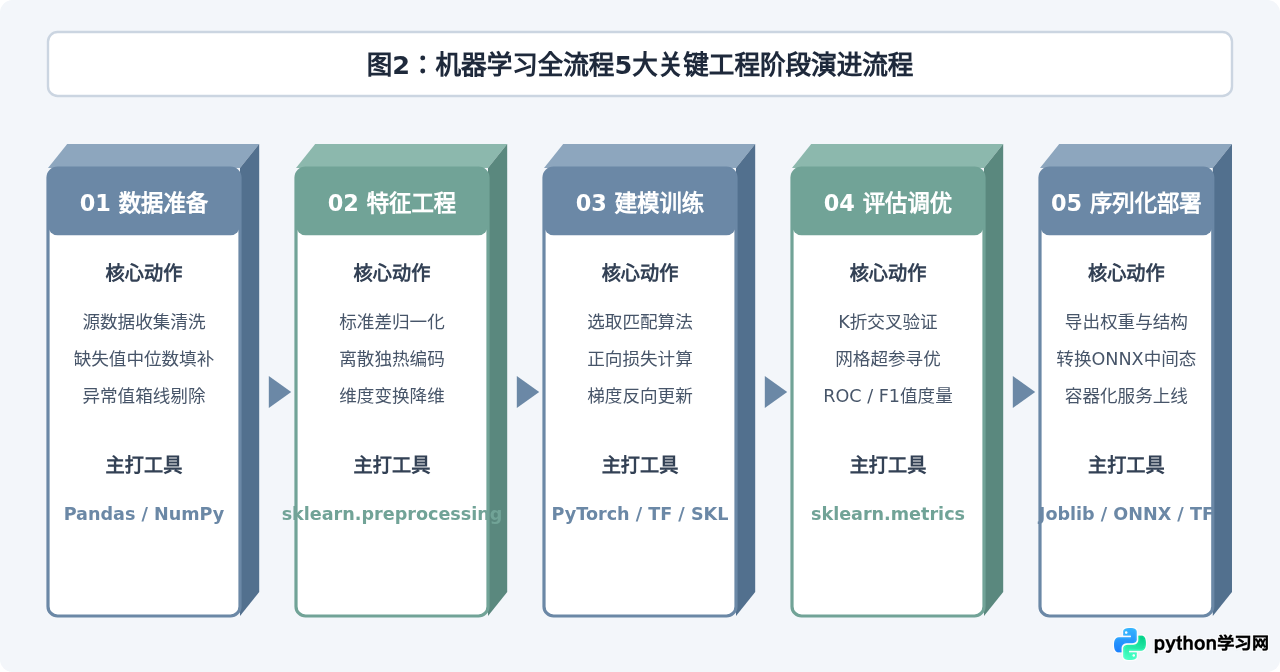
无论选择上述哪一个工具库,一个严谨的机器学习项目均需要经过明确的 5 个阶段。正如下方图2所示,各个阶段紧密咬合,形成可追踪、可迭代的闭环工程流水线:
五、新手技术选型逻辑与学习路径
在面对一个实际项目时,无需纠结“哪个库性能最强”,而应从数据形态、算力资源与最终目标三方面进行正向推导:
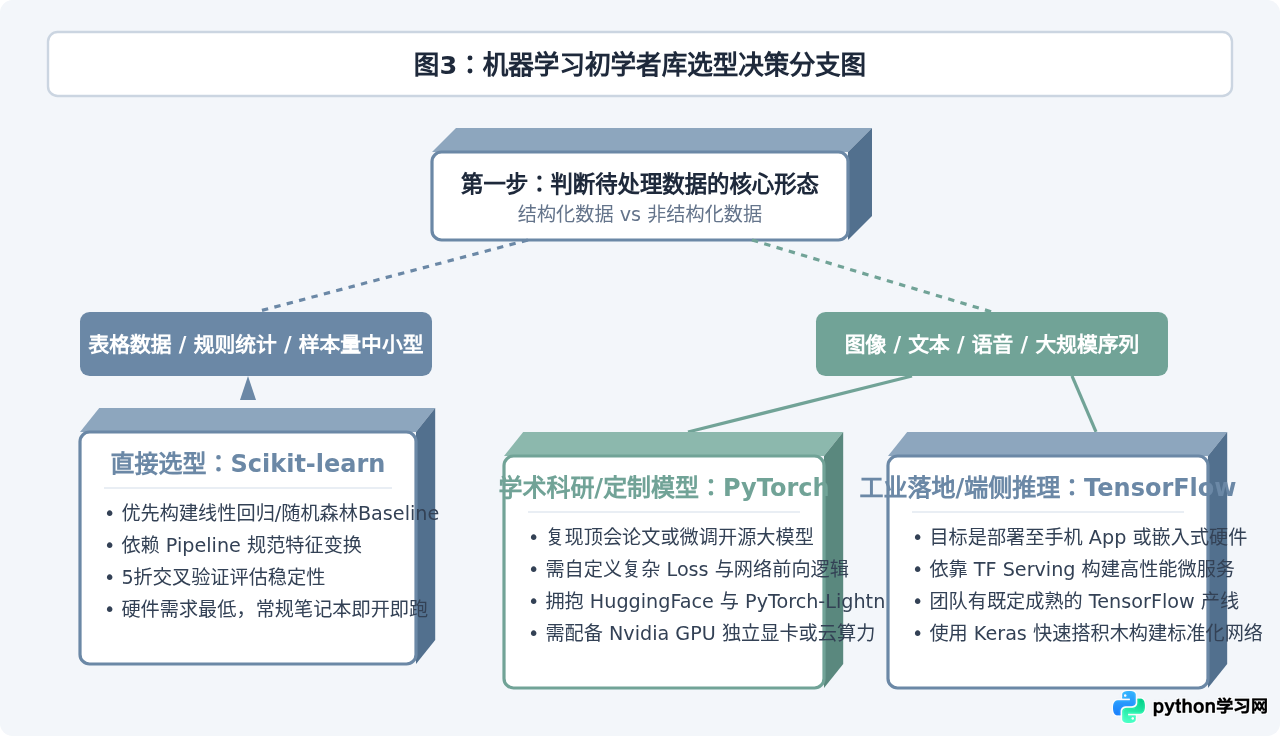
对初学者的具体落地建议如下:
- 第一阶段(建立基础工程思维):无论未来是否从事深度学习,均推荐先学习 Scikit-learn。在极低算力成本下彻底搞清数据切分、交叉验证、混淆矩阵、过拟合与欠拟合等核心概念。
- 第二阶段(跨入神经网络领域):当数据转向图像或文本时,推荐直接进入 PyTorch。其清晰透明的数据流和报错信息能帮助你透彻理解反向传播(Backpropagation)与权重优化的底层运作机制。
- 第三阶段(针对生产做工程扩展):当遇到企业级高并发部署、移动端量化压缩(TFLite)或大规模分布式集群调度时,再有针对性地吸收 TensorFlow 的生态组件。
六、三大库核心维度对比与总结
为了给开发者提供系统化的速查参考,下表汇总了三者在编程模式、算力支持、生态体系与适用人群上的核心差异:
| 核心评估维度 | Scikit-learn | PyTorch | TensorFlow (含 Keras) |
|---|---|---|---|
| 核心问题定位 | 经典统计学习、特征预处理 | 前沿深度学习、学术实验、大模型 | 工业级深度学习、全栈部署管线 |
| 计算底层机制 | NumPy / SciPy 原生矩阵运算 | 动态计算图(Eager Autograd) | 静态图优化(AutoGraph)与 Eager 兼容 |
| 硬件加速支持 | 仅 CPU(支持多核多线程) | CPU、CUDA GPU、MPS、TPU | CPU、CUDA GPU、TPU、移动端 NPU |
| 代码风格与门槛 | 极低,fit/predict 统一标准 | 中等,贴近原生 Python 面向对象 | Keras 极低,底层 TF 原生较复杂 |
| 模型部署体系 | Joblib / Pickle 文件序列化 | TorchScript / ONNX 导出 | TF Serving / TFLite / TF.js 原生支持 |
| 社区主导力量 | 开源社区与科研基金会 | Meta 及开源研究者(主流学术界) | Google 及企业工程化运维团队 |
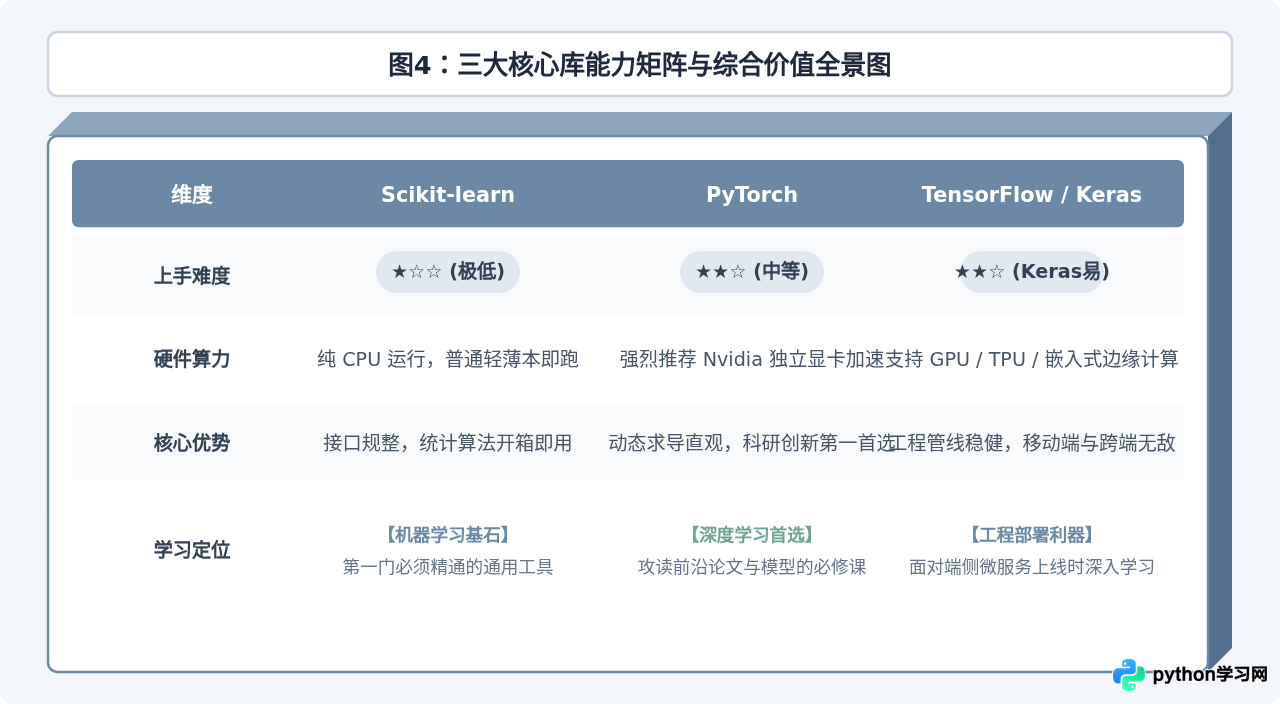
掌握这三个库并不意味着需要在短时间内全部熟读其源码。最有效的方法是:先用 Scikit-learn 处理好结构化业务问题;在面对图像、语音或大语言模型等复杂场景时以 PyTorch 为主力构建模型;而在产品需要部署到移动端、浏览器或生产集群微服务时,借助 TensorFlow 与 Keras 的完备生态实现稳健上线。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









