

Python人工智能生态解析:NumPy、TensorFlow与PyTorch的作用
深入解析Python人工智能生态中NumPy、TensorFlow与PyTorch的核心定位、本质区别、协作流程与技术选型指南,帮助开发者建立清晰的技术全景与工程实践能力。
import numpy as np、import torch 或 import tensorflow as tf。很多初学者常会感到困惑:它们都是做矩阵计算的,为什么需要三个库?它们之间是替代关系还是分工协作?本文将直接拆解 NumPy、TensorFlow 与 PyTorch 在人工智能生态中的核心定位、底层差异与协作机制,帮助你在实际项目中准确选型并规范使用。
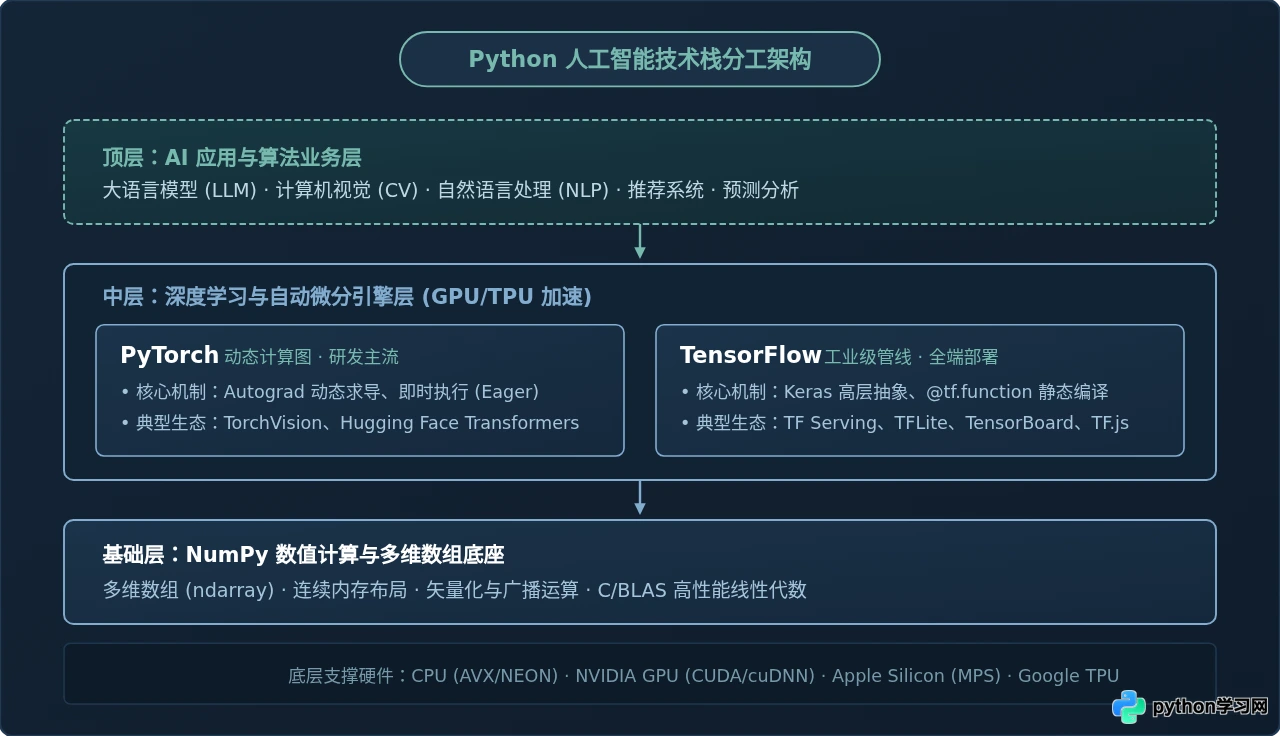
一、NumPy:人工智能的底层多维数组与数值计算基石
在 Python 的整个科学计算与 AI 体系中,NumPy(Numerical Python)处于最底层的基石地位。它的核心使命是为 Python 提供高效的连续内存多维数组(ndarray),以及基于这套数据结构的高度优化的矢量化数学运算函数。
原生 Python 的内置列表(list)本质是指针数组,列表中存储的是指向具体对象的地址指针,元素在物理内存中离散分布。这种机制在处理大规模图像像素、文本词向量或音频信号时,会导致严重的 CPU 缓存命中率低下,且每一步操作都受制于全局解释器锁(GIL)和动态类型检查。NumPy 彻底解决了这一性能瓶颈:
- 同质连续内存:NumPy 的
ndarray在内存中以连续字节块紧凑排布,所有元素具有统一的数据类型(如float32或int64),极大提升了硬件层面的缓存命中率。 - 矢量化与底层 C 优化:底层直接绑定 BLAS、LAPACK 等高度优化的线性代数库,并利用 CPU 的 SIMD(单指令流多数据流)向量化指令集,避免了显式的 Python
for循环。 - 多维广播机制(Broadcasting):允许不同形状但维度兼容的数组在算术运算时自动对齐,减少不必要的数据复制开销。
NumPy 核心操作示例
以下示例展示了在数据预处理阶段,如何利用 NumPy 进行矩阵乘法与基于广播特性的特征归一化:
# 环境:Python 3.8+ / numpy 1.20+
import numpy as np

# 1. 模拟 4 个样本,每个样本包含 3 个连续特征
features = np.array([
    [10.0, 200.0, 0.5],
    [12.0, 220.0, 0.6],
    [9.0,  190.0, 0.4],
    [11.0, 210.0, 0.5]
], dtype=np.float32)

# 2. 计算均值和标准差(广播机制计算 Z-Score 归一化)
mean = np.mean(features, axis=0)
std = np.std(features, axis=0)
normalized = (features - mean) / std

# 3. 线性变换:特征与权重矩阵相乘 (4x3 @ 3x2 -> 4x2)
weights = np.array([
    [0.2, 0.1],
    [0.4, -0.3],
    [0.8, 0.5]
], dtype=np.float32)
output = np.matmul(normalized, weights)

print("标准化后特征形状:", normalized.shape)
print("线性输出结果示例:
", output[:2])1. 无法原生调度 GPU/TPU 硬件加速:NumPy 的核心运算只能运行在 CPU 上,面对千万甚至上千亿参数的模型无法承载;
2. 缺乏自动微分(Autograd)引擎:神经网络训练的核心是基于反向传播算法计算损失函数对每个权重的偏导数。在 NumPy 中若要训练深度模型,必须手动手推求导公式并硬编码梯度公式,这在复杂多层网络中几乎不可行。
二、PyTorch 与 TensorFlow:深度学习与自动微分引擎的两强
为了解决 GPU 大规模矩阵并行计算以及复杂的自动求导(Automatic Differentiation),以 PyTorch(由 Meta 主导)和 TensorFlow(由 Google 主导)为代表的深度学习框架应运而生。
它们在保留类似 NumPy 数组接口操作体验的同时,引入了两个革命性能力:张量(Tensor)跨设备运算与计算图追踪/自动微分机制。无论是 PyTorch 的 torch.Tensor 还是 TensorFlow 的 tf.Tensor,都可以在 CPU、NVIDIA GPU(CUDA)以及专用加速卡上自由流转。
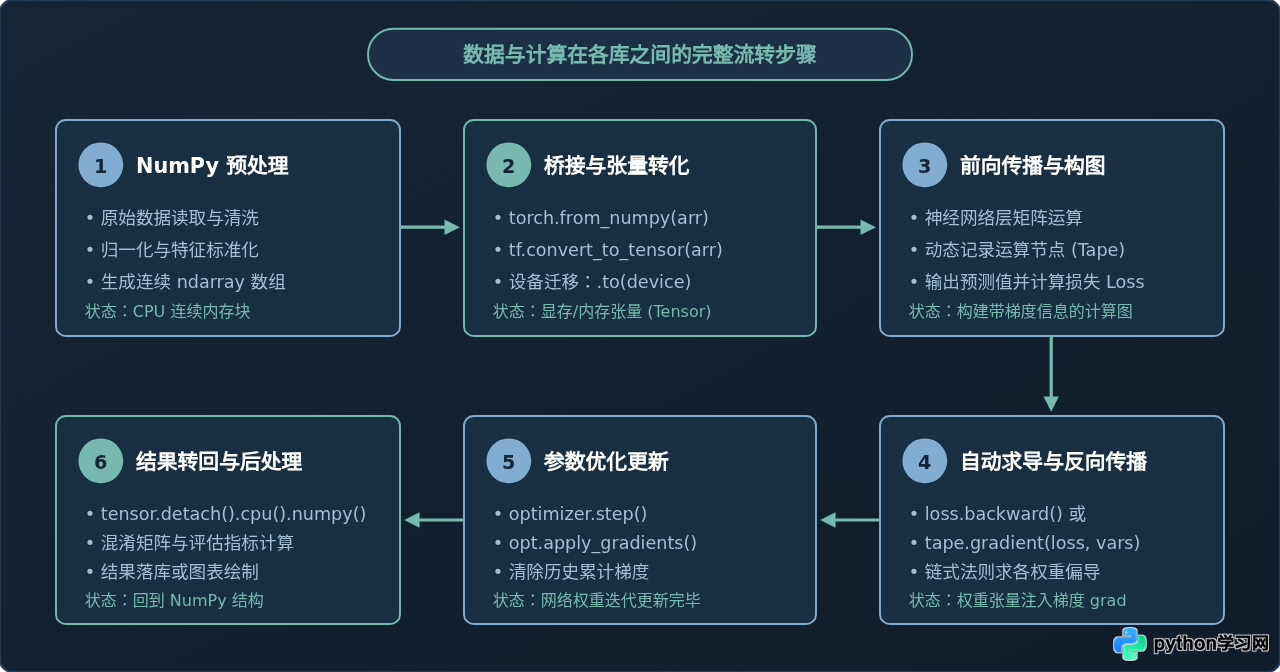
1. 数据与训练的完整流转步骤
- NumPy 阶段:从 CSV、数据库或图像文件读取原始数据,完成清洗、切分与数组化。此时数据常驻于系统内存。
- 张量转换与上云/上卡:调用
torch.from_numpy()或tf.convert_to_tensor(),将 CPU 数组映射为张量对象,并移动到指定的 GPU 设备显存。 - 前向运算与轨迹追踪:输入张量穿过前向神经网络,框架在内部隐式或显式地构建运算拓扑图,计算出预测值与损失(Loss)。
- 反向自动微分:框架顺着构建好的计算图,依据微积分链式法则反向求出所有可学习参数的梯度向量。
- 参数更新与清空:优化器(如 Adam、SGD)根据求出的梯度调整网络权重,并清空历史累计梯度。
- 回传 NumPy 分析:推断完成后的预测数值脱离计算图,从显存拷贝回 CPU 内存并转为
ndarray,供后续指标计算与图表绘制。
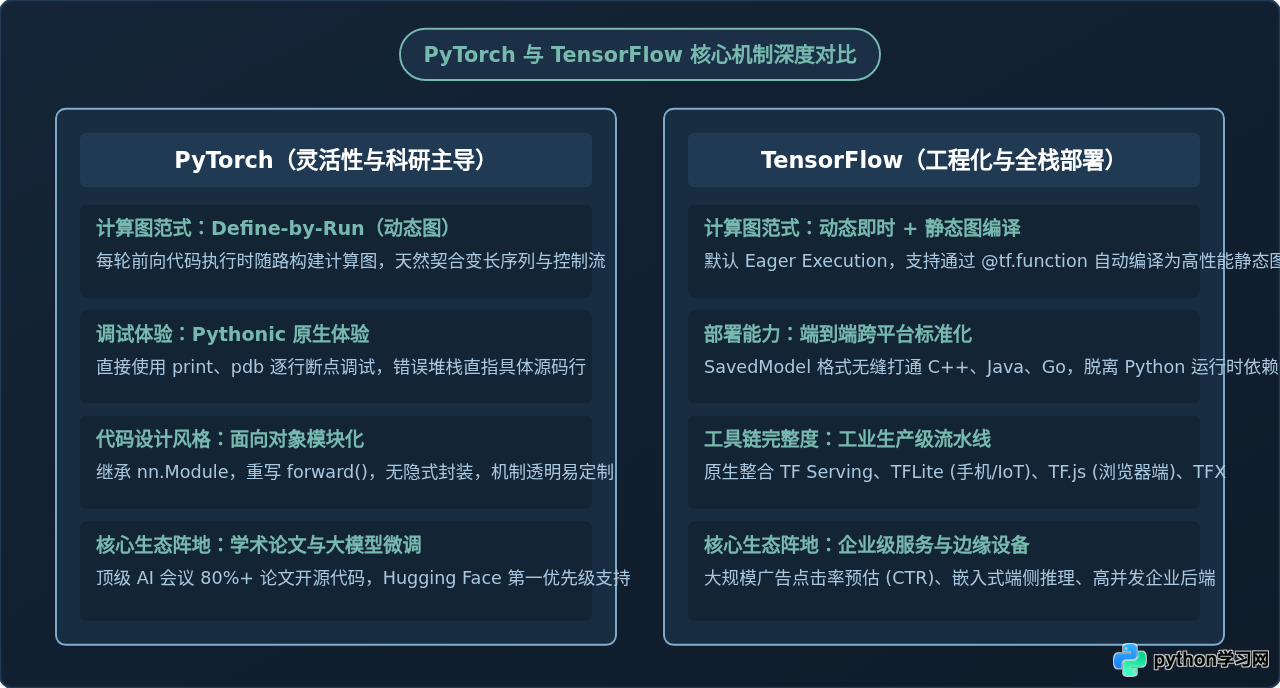
三、核心机制剖析:PyTorch 与 TensorFlow 的本质区别
虽然 PyTorch 和 TensorFlow 都能完成深度学习模型的训练与推理,但两者的底层设计哲学和生态重心有着明显分野:
1. 计算图范式:动态图(Define-by-Run)vs 静态编译(Define-and-Run)
PyTorch 诞生之初就彻底确立了动态计算图优先的哲学。代码每执行一行,对应的计算节点就在内存中即时生成。这意味着它完全遵循普通的 Python 控制流——你可以在前向传播函数中自由写入标准的 if-else 条件分支、for 循环,甚至可以在循环体中动态改变输入张量的形状,这被称为命令式即时执行(Eager Execution)。
TensorFlow 1.x 曾强制采用严格的静态图模式:先用代码定义完整的拓扑图,再开启一个 Session 把数据喂入执行。这种方式对生产优化极其友好,但调试极其痛苦。TensorFlow 2.x 进行了彻底重构,默认同样采用动态即时执行(Eager Execution),同时通过 @tf.function 装饰器配合 AutoGraph 引擎,在需要极致性能时一键将 Python 函数追踪编译为优化的静态计算图。
2. 代码编写风格与自动求导对比
下面的代码分别使用 PyTorch 和 TensorFlow 实现相同的简单线性回归反向传播,读者可以直观体会它们的语法与机制差异:
PyTorch 实现风格:
import torch

# 定义带求导标志的权重张量与数据
x = torch.tensor([[1.0], [2.0], [3.0]], dtype=torch.float32)
y_true = torch.tensor([[2.0], [4.0], [6.0]], dtype=torch.float32)
w = torch.tensor([[0.0]], dtype=torch.float32, requires_grad=True)

# 前向传播:即时计算
y_pred = torch.matmul(x, w)
loss = torch.mean((y_pred - y_true) ** 2)

# 反向自动求导
loss.backward()

print("PyTorch 权重求导结果:", w.grad.item())TensorFlow 2.x 实现风格:
import tensorflow as tf

x = tf.constant([[1.0], [2.0], [3.0]], dtype=tf.float32)
y_true = tf.constant([[2.0], [4.0], [6.0]], dtype=tf.float32)
w = tf.Variable([[0.0]], dtype=tf.float32)

# 使用 GradientTape 上下文显式记录求导轨迹
with tf.GradientTape() as tape:
    y_pred = tf.matmul(x, w)
    loss = tf.reduce_mean(tf.square(y_pred - y_true))

# 显式计算梯度
grad = tape.gradient(loss, w)

print("TensorFlow 权重求导结果:", grad.numpy()[0][0])3. 核心机制特性对比表
| 对比维度 | NumPy | PyTorch | TensorFlow 2.x |
|---|---|---|---|
| 核心数据载体 | numpy.ndarray |
torch.Tensor |
tf.Tensor / tf.Variable |
| 硬件加速 | 仅 CPU(依赖 BLAS/SIMD) | CPU、CUDA GPU、Apple MPS、TPU | CPU、CUDA GPU、Google TPU、DirectML |
| 自动微分(Autograd) | 无,需人工推导公式 | 基于反向图的 loss.backward() |
基于上下文管理器的 tf.GradientTape |
| 计算图模式 | 无图结构,即时数组运算 | 动态图(通过 TorchScript 导出静态图) | 动态优先(通过 @tf.function 编译静态图) |
| 调试排错体验 | 原生 Python 调试器,直观 | 原生 Pythonic,逐行断点极其容易 | Eager模式易调试;进入图编译后错误堆栈较深 |
| 产业与开源主战场 | 整个科学计算与数据工程通用基石 | 学术研究、顶会论文、大语言模型(LLM) | 工业级大规模预估系统、端侧嵌入式部署 |
四、工程实战指南:场景选型决策与常见避坑要点
在了解了三者的本质机制之后,面对具体的工程任务,我们应当如何做出明确、理性的技术选型?
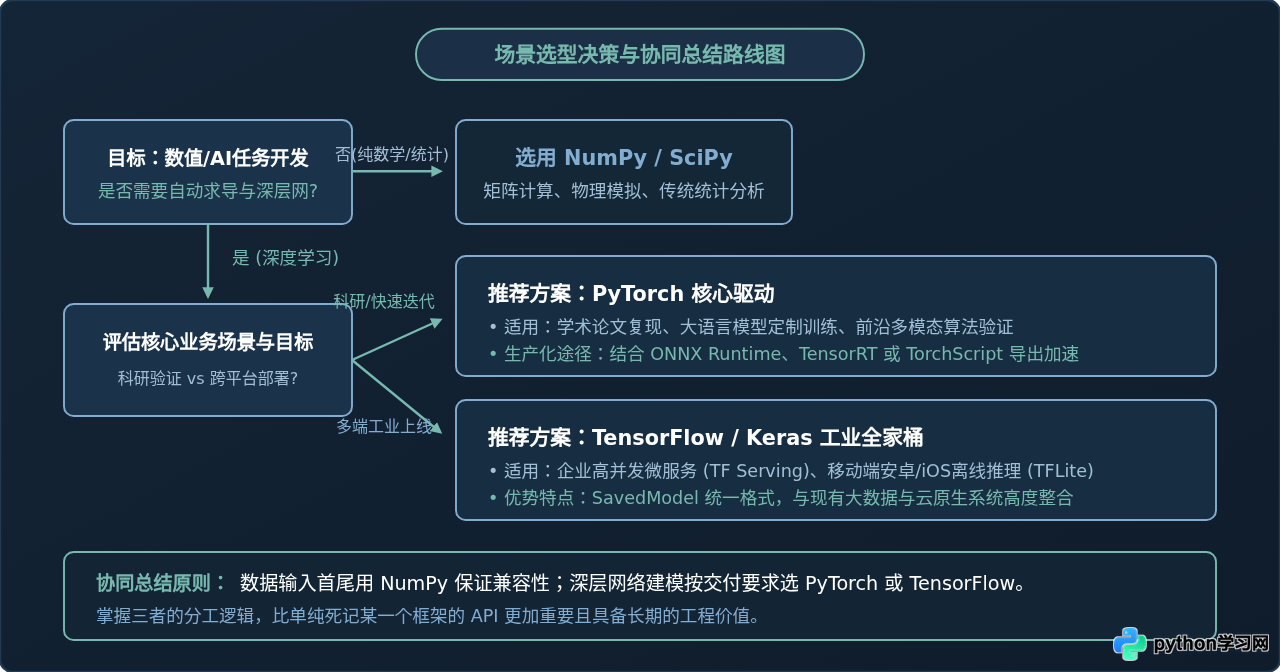
1. 清晰明确的选型决策树
- 场景 A:经典机器学习与纯数值计算
如果你的任务是传统数据分析、统计假设检验、基于 Scikit-learn 的逻辑回归/随机森林,或者需要做物理流体模拟、图像滤波:直接使用 NumPy(结合 SciPy 和 Pandas)。引入重量级深度学习框架只会增加依赖复杂度与资源开销。 - 场景 B:学术研究、创新网络结构与大模型微调
如果你需要快速阅读复现前沿论文、微调 Hugging Face 社区模型、编写非固定拓扑的复杂神经网络:优先选择 PyTorch。目前学术界超过八成的论文使用 PyTorch 发布代码,调试与排查逻辑 Bug 极为直观高效。 - 场景 C:工业级全栈服务、高并发微服务与端侧部署
如果你所在团队拥有成熟的 Java/C++ 后端,需要把模型无缝导出为不依赖 Python 环境的二进制文件,部署到 Kubernetes(通过 TF Serving gRPC 服务),或者打包到 Android/iOS 手机端(通过 TFLite):优先选择 TensorFlow / Keras。其工具链在端到端工业流水线上的健壮度依然具备显著优势。
2. 数据转换中的常见陷阱与注意事项
-
内存共享(Zero-Copy)与独立内存复制的区别:
在 CPU 内存中,使用torch.from_numpy(arr)创建张量时,张量与原始 NumPy 数组默认共享同一底层内存块。修改张量中的数值,原 NumPy 数组的值会同步被改变。但如果张量被移动到 GPU(如tensor.cuda()),则会触发物理显存拷贝,此时两者的修改不再互相关联。 -
浮点精度的默认陷阱(float64 vs float32):
NumPy 在大多数现代系统上创建浮点数组时,默认类型为双精度float64;而深度学习框架(PyTorch/TensorFlow)为了追求显卡 Tensor Core 的极限计算吞吐,默认期望的是单精度float32甚至是半精度(float16/bfloat16)。如果不显式指定dtype=np.float32,在转为张量时往往会引发类型不匹配警告或导致显存占用与计算耗时翻倍。 -
反向传播后的内存释放与脱钩(Detach):
在评估模型或记录日志时,如果直接把带有梯度历史的张量转换为 NumPy(例如直接调用tensor.numpy()),PyTorch 会直接抛出运行时错误。正确的操作必须先调用.detach()将张量从计算图的求导链条中剥离,再移至 CPU 内存(.cpu()),最后调用.numpy()。
五、总结
回顾 Python 人工智能生态,NumPy、TensorFlow 和 PyTorch 不是简单的“非此即彼”,而是在技术演进过程中形成的清晰分工体系:
NumPy 是多维数据表示和通用的 CPU 数值基石,它让数据有了统一的标准结构;TensorFlow 与 PyTorch 则在此基础之上插上了硬件加速与自动微分的翅膀,PyTorch 以极其灵活优雅的动态图机制赢得了科研探索与大模型创新的主流地位,而 TensorFlow 依靠成熟完备的 SavedModel 与端到端流水线构筑了稳固的工业落地标准。在真实的人工智能项目中,理顺数据在三者之间的流转边界,能够让你以最高效、规范的方式构建稳定可靠的 AI 系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









