

Python csv模块与pandas处理CSV文件的区别
深入对比Python内置csv模块与第三方pandas库在处理CSV文件时的核心区别,涵盖架构原理、内存机制、代码语法、性能表现与选型决策指南。
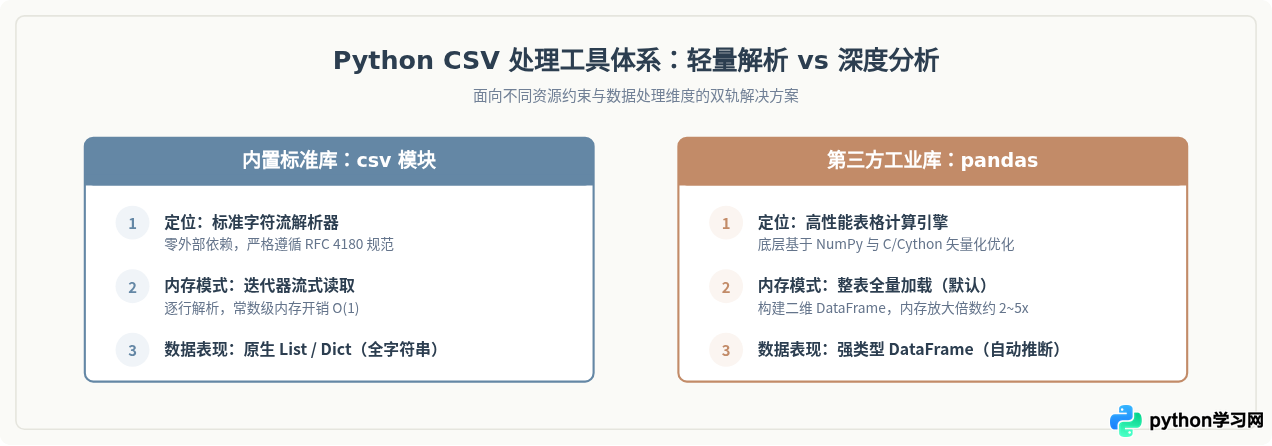
在Python中读取与写入CSV文件时,内置的csv模块与第三方数据分析库pandas是最常用的两种选择。两者的核心差异在于设计目标:csv是一个轻量、无外部依赖的字符流解析工具,按行顺序读取字符串并保持极低内存占用;而pandas则是功能强大的表格数据分析引擎,默认将整个数据集加载为强类型的二维表结构(DataFrame),支持高性能的矢量化计算与丰富的数据重塑操作。理解两者的底层机制、资源开销与使用边界,能够帮助开发者在面对不同规模的数据任务时做出最优技术选型。
一、定位与设计理念的本质区别
很多初学者在选择处理CSV文件的工具时,容易把csv和pandas当成同类功能的“简单版”与“升级版”,这种认知并不准确。它们从诞生之初所面向的核心场景与解决的问题维度就截然不同。
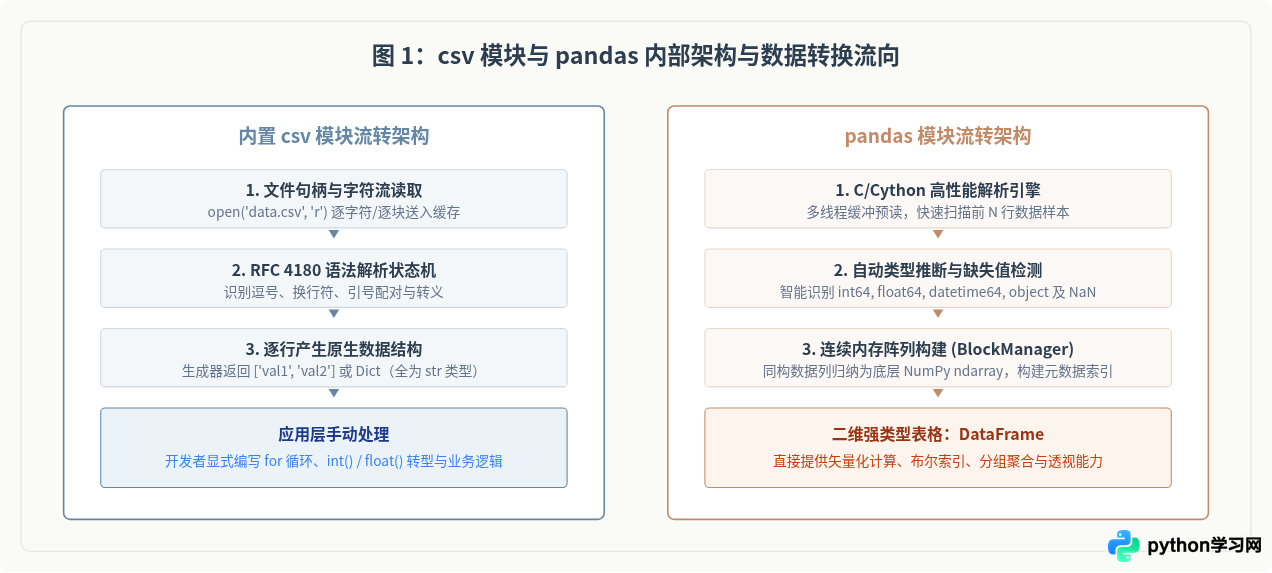
Python自带的csv模块是Python标准库的一部分,属于低级(Low-level)文本解析工具。它的核心职责是充当一个符合规范的CSV编解码器(Codec)。它严格按照RFC 4180标准处理字段分隔符、行尾结束符、双引号转义等纯文本排版规则。它不关心字段所代表的实际业务语义(例如某列是销售额、年龄还是日期),只负责将文本安全、忠实地切分为Python列表或字典。
相比之下,pandas是一个功能完整的高级(High-level)数据分析与挖掘框架。处理CSV文件只是其数据输入输出(I/O)子系统中的一小部分能力。当调用pd.read_csv()时,pandas不仅解析文本,还会启动内置的类型推断引擎,分配连续的内存块,将数据组织成具有行索引与列标签的二维结构(DataFrame)。pandas的设计目标是让开发者在加载数据后,能立即进行分组聚合、多表连接、窗口计算和统计建模。
二、内存机制与执行效率的深度对比
在实际工程场景中,选择两者的最关键考量往往是内存占用与执行时间。
1. 内存消耗与加载模式
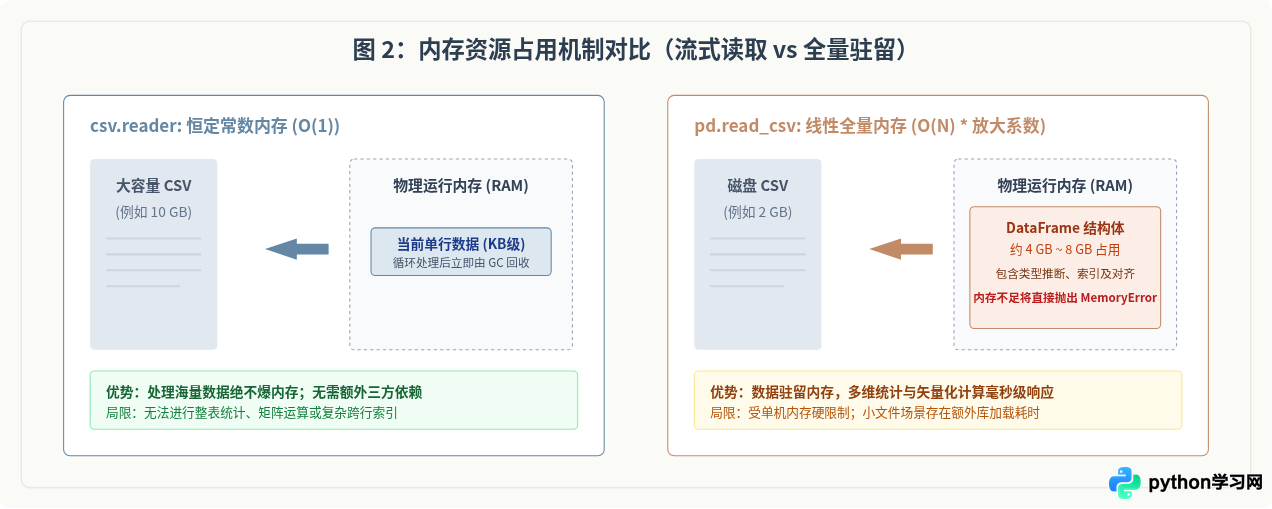
csv.reader返回的是一个迭代器(Generator对象)。当你通过for row in reader:遍历时,Python每次只在内存中保留当前行的文本及切分出来的几个字符串对象。无论待处理的CSV文件是10MB还是100GB,程序运行过程中的常驻内存(RSS)都可以稳定在几兆字节到十几兆字节之间,内存复杂度为严格的O(1)。
pd.read_csv()默认是一次性将整个文件解析并载入内存。因为构建DataFrame需要保存列元数据、行索引标签以及底层NumPy数组的指针对齐结构,加上字符串对象在Pandas旧版本中是以Python指针数组形式存储,通常加载后的DataFrame在内存中的占用大小是原磁盘CSV文件体积的2倍至5倍。如果一台机器只有16GB内存,读取一个4GB的CSV文件很可能会直接触发内存溢出(OOM, Out of Memory)崩溃。
2. 计算性能:Python解释器循环 vs C/Cython 矢量化
如果仅仅是读取前1000行并写入另一个文件,csv模块往往更快,因为它不需要构建繁杂的对象系统。但一旦涉及到数学计算、条件过滤、数据分组与聚合,情况就会彻底反转:
- csv模块的局限:所有的运算都在Python原生解释器层面进行。计算平均值需要写显式
for循环,执行每一步累加都需要经历Python动态类型的解包与打包,速度受限于GIL与解释器开销。 - pandas的高性能:底层的运算被分发到底层的NumPy C代码。例如
df['price'] * 1.1是连续内存空间内的SIMD(单指令多数据流)矢量化操作,速度通常比纯Python循环快数十倍乃至上百倍。
三、实际代码示例与操作对比
通过具体的数据处理任务,我们可以直观看到两者的代码组织形式和编程心智模型的差异。假设我们有一个包含员工信息的employees.csv文件,内容如下:
name,department,salary,hire_date
Alice,Engineering,12500,2021-03-15
Bob,Marketing,8200,2020-07-01
Charlie,Engineering,14000,2019-11-20
David,Sales,9100,2022-01-10
Eva,Marketing,8900,2021-08-05
任务 1:读取数据并按条件过滤(找出薪资大于 9000 的员工)
使用 csv 模块实现:
import csv

high_earners = []

with open('employees.csv', mode='r', encoding='utf-8') as f:
    reader = csv.DictReader(f)
    for row in reader:
        # 注意:csv 读取的所有字段默认均为 str,必须显式转换类型
        if float(row['salary']) > 9000:
            high_earners.append({
                'name': row['name'],
                'department': row['department'],
                'salary': float(row['salary'])
            })

print(high_earners)
# 示例输出:
# [{'name': 'Alice', 'department': 'Engineering', 'salary': 12500.0},
#  {'name': 'Charlie', 'department': 'Engineering', 'salary': 14000.0},
#  {'name': 'David', 'department': 'Sales', 'salary': 9100.0}]
使用 pandas 实现:
import pandas as pd

# 读取时自动将 salary 识别为数值列
df = pd.read_csv('employees.csv')

# 采用矢量化布尔切片,一行代码完成过滤
filtered_df = df[df['salary'] > 9000]

print(filtered_df[['name', 'department', 'salary']])
# 示例输出:
#       name   department  salary
# 0    Alice  Engineering   12500
# 2  Charlie  Engineering   14000
# 3    David        Sales    9100
任务 2:分组统计(计算每个部门的平均薪水)
使用 csv 模块实现:
import csv
from collections import defaultdict

dept_totals = defaultdict(float)
dept_counts = defaultdict(int)

with open('employees.csv', mode='r', encoding='utf-8') as f:
    reader = csv.DictReader(f)
    for row in reader:
        dept = row['department']
        dept_totals[dept] += float(row['salary'])
        dept_counts[dept] += 1

dept_averages = {
    dept: round(dept_totals[dept] / dept_counts[dept], 2)
    for dept in dept_totals
}

print(dept_averages)
# 示例输出:
# {'Engineering': 13250.0, 'Marketing': 8550.0, 'Sales': 9100.0}
使用 pandas 实现:
import pandas as pd

df = pd.read_csv('employees.csv')

# 直接使用 groupby 与聚合函数
dept_averages = df.groupby('department')['salary'].mean().round(2)

print(dept_averages)
# 示例输出:
# department
# Engineering    13250.0
# Marketing       8550.0
# Sales           9100.0
# Name: salary, dtype: float64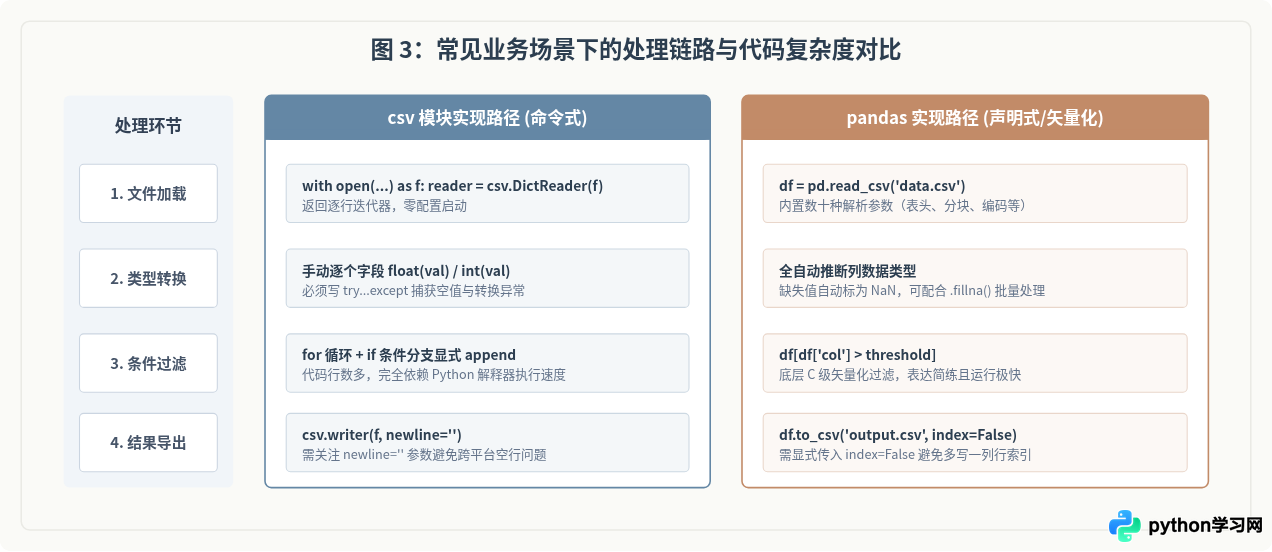
四、关键差异维度总览
为了更系统地评估两者的技术特性,我们将开发者在选型时最关心的核心指标汇总如下:
| 对比维度 | Python 内置 csv 模块 | 第三方 pandas 库 |
|---|---|---|
| 环境依赖 | 零依赖,随 Python 解释器内置提供 | 需外部安装(依赖 numpy、python-dateutil 等) |
| 内存占用模式 | 恒定低内存(迭代器流式),O(1) 复杂度 | 全量加载为 DataFrame,内存常为文件大小的 2~5 倍 |
| 数据类型支持 | 无类型系统,读取出的内容均为字符串(str) | 强类型系统,自动推断数值、布尔、日期及缺失值 |
| 数据操作能力 | 仅提供文本切分与转义,无统计计算方法 | 支持矢量化计算、分组(groupby)、关联(merge)、透视表 |
| 大数据集处理 | 天生适合处理上百 GB 级的超大文件(逐行流式清洗) | 大文件需配合 chunksize 分块读取,否则易引发 OOM |
| 启动与加载开销 | 毫秒级初始化,脚本执行瞬时完成 | import pandas 存在冷启动加载时间(约 0.2~0.5s) |
| 语法抽象层级 | 命令式(Imperative),需手动维护循环与容器状态 | 声明式(Declarative),通过链式调用表达数据转换逻辑 |
五、工程实践中的选型决策树
选择csv还是pandas,不取决于“哪个库更高级”,而取决于你的硬件资源约束、数据文件体量以及后续的数据处理需求。
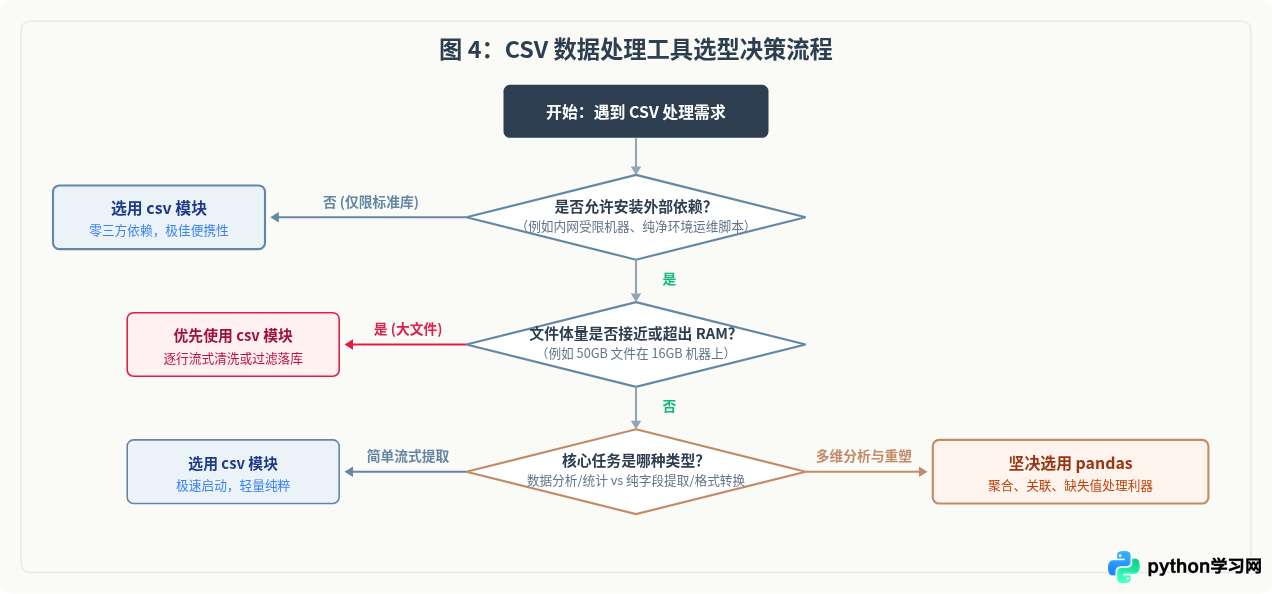
1. 优先使用 csv 模块的典型场景
- 超大体量日志与流水清洗:文件达到数十吉字节(GB),任务仅是按行扫描、检查某列状态码、提取符合条件的少数行并写入新文件或数据库。此时
csv.reader流式处理是唯一不依赖大型分布式集群的单机低成本方案。 - 微服务、轻量脚本与部署受限环境:在 Docker 极简基础镜像、AWS Lambda 或受保护的生产服务器上,可能没有也不允许安装庞大的三方库。内置的
csv无任何外部安装成本。 - 简单格式转换:仅仅是将 CSV 转换成 JSON,或者将列表数据以标准分隔符保存,使用
csv.DictWriter即可清晰高效完成。
2. 优先使用 pandas 的典型场景
- 数据探索与分析(EDA):需要快速查看数据的形状(
df.shape)、缺失值统计(df.isnull().sum())、各分位数与均值(df.describe())。 - 复杂清洗与数据转换:涉及列与列之间的矢量运算、字符串批量正则替换、日期时间格式解析与重采样(Resample)。
- 多源关联与分组聚合:需要类似 SQL 的
GROUP BY、INNER JOIN、LEFT JOIN或透视表(Pivot Table)操作。 - 后续连接机器学习流水线:清洗完的数据需直接送入 Scikit-learn、PyTorch 或 XGBoost 模型进行训练,DataFrame 可以无缝转换为 NumPy 数组或张量。
六、实际开发中的常见陷阱与注意事项
在 Windows 系统下使用
csv.writer或csv.DictWriter写入文件时,如果open()没有显式指定newline='',由于 Windows 默认行终止符为\r\n,csv 模块在内部也会写入换行符,会导致输出文件每两行数据之间插入一行空白行。
正确做法:务必使用
with open('output.csv', 'w', newline='', encoding='utf-8') as f:打开写入流。
使用
df.to_csv('output.csv')保存文件时,pandas 默认会将行索引(0, 1, 2...)作为第一列写入,导致重新读取该文件时会出现名为Unnamed: 0的多余列。
正确做法:如果无需保存索引,务必传递参数
df.to_csv('output.csv', index=False)。
如果 CSV 文件由 Microsoft Excel 生成,通常会带上 UTF-8 签名(BOM, Byte Order Mark)。使用标准的
encoding='utf-8'读取时,表头首列字段名前常会附带不可见的特殊字符\ufeff,导致row['name']出现KeyError。
正确做法:若涉及 Excel 导出的 CSV 文件,推荐将编码指定为
encoding='utf-8-sig'。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









