

Python学习中哪些概念最容易劝退初学者
深入解析Python初学者最容易卡壳的核心概念:变量标签与引用模型、LEGB作用域与闭包机制、装饰器执行流程、迭代器与生成器协议,帮助建立准确的心智模型并攻克进阶阻碍。
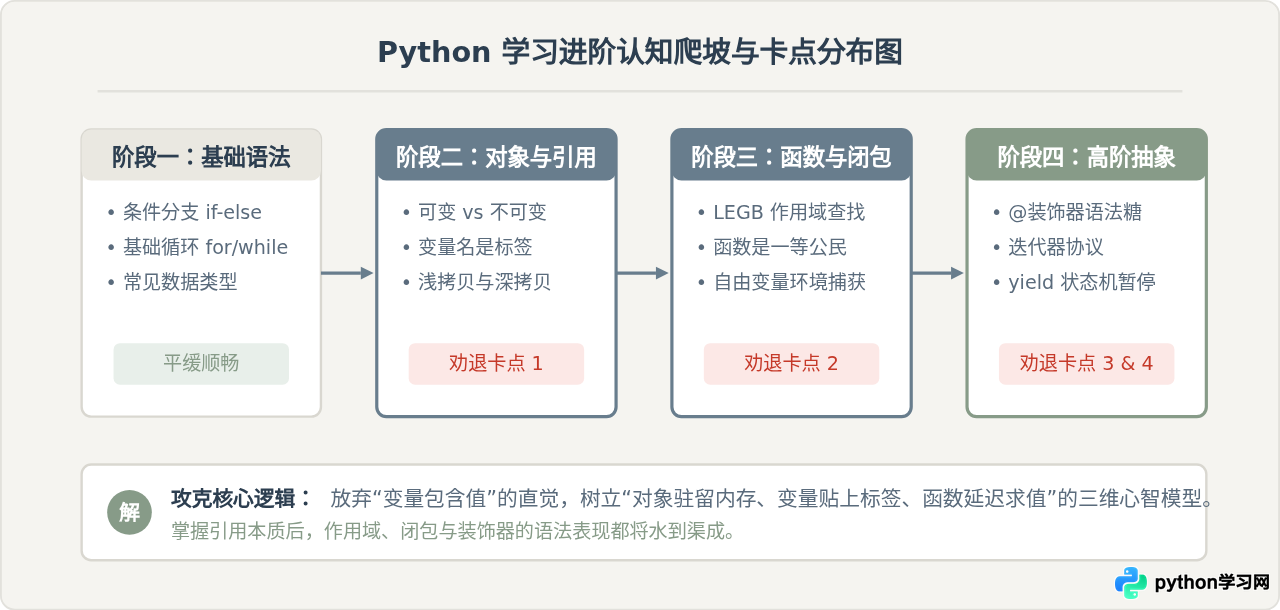
一、Python 学习曲线与关键卡点分布
在学习变量声明、条件分支与基础循环时,学习者依靠通用逻辑即可顺利写出可用代码。然而,当程序逻辑转向更具工程性与函数式特性的语法结构时,Python 的底层设计哲学便开始集中显现。
初学者的挫败感主要集中在四个阶段性跃迁点:从“盒子模型”跨越到“标签引用模型”;从“平铺逻辑”跨越到“高阶函数与闭包”;从“直接调用”跨越到“元编程与装饰器”;以及从“即时内存列表”跨越到“状态保留的生成器协议”。
二、变量与对象引用:为什么“修改 b 会影响 a”
在很多初学者的直觉中,变量就像一个个贴着名字的储物盒子,赋值语句 b = a 仿佛是将盒子 a 里的物品完整复制了一份,装入盒子 b 中。但在 Python 中,变量绝不是盒子,而是贴在对象上的标签。
1. 内存中的标签模型
Python 所有的实体(整数、字符串、列表、字典、函数)都作为对象存在于堆内存中。执行 a = [1, 2] 时,Python 先在内存中开辟空间创建列表对象 [1, 2],然后将名为 a 的标签系在该对象上。当紧接着执行 b = a 时,并没有复制任何列表数据,而是把名为 b 的标签也系在同一个内存对象上。
此时,如果调用 b.append(3),修改的是标签所指向的那个底层共享对象。因此通过 a 查看时,内容同样变成了 [1, 2, 3]。
# 示例:就地修改(In-place Mutation)与重新绑定(Rebinding)
a = [1, 2]
b = a
b.append(3)
print("a:", a)  # 示例输出:a: [1, 2, 3],a 和 b 指向同一对象

# 对比:不可变对象的重新绑定
x = 10
y = x
y = y + 1
print("x:", x)  # 示例输出:x: 10
print("y:", y)  # 示例输出:y: 11,y 指向了新生成的整数对象 11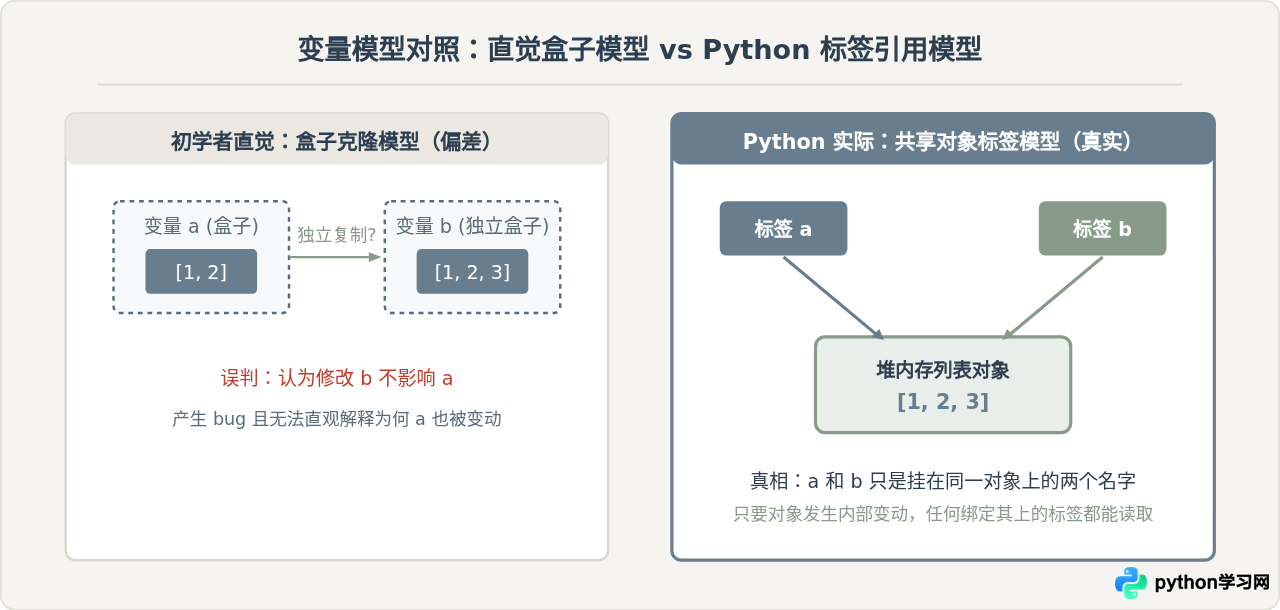
2. 常见连带陷阱:默认参数陷阱
理解了“引用”概念,就能瞬间看透 Python 著名的“可变默认参数”陷阱。函数的默认参数是在 def 语句执行(即函数定义时)被求值并创建的,而非在每次调用时重新生成。
# 常见错误:将可变对象作为默认参数
def append_element(val, target_list=[]):
    target_list.append(val)
    return target_list

print(append_element(1))  # 示例输出:[1]
print(append_element(2))  # 示例输出:[1, 2] —— 并非重新从空列表开始!

# 标准解法:使用 None 作为占位符
def safe_append_element(val, target_list=None):
    if target_list is None:
        target_list = []
    target_list.append(val)
    return target_list
三、作用域与闭包:嵌套函数中的变量归属
当程序开始编写嵌套函数或回调逻辑时,初学者经常遭遇 UnboundLocalError: local variable referenced before assignment。
1. LEGB 查找原则与局部覆盖
Python 确定变量的作用域采用静态词法作用域,按 LEGB 顺序查找:
- L (Local):当前函数内部局部作用域;
- E (Enclosing):外层嵌套函数的闭包命名空间;
- G (Global):当前模块文件顶层全局命名空间;
- B (Built-in):内置函数与常量(如
len、range)。
count += 1 包含 count = count + 1),Python 在编译字节码阶段就会直接将 count 标记为“局部变量”。若在赋值前尝试读取该变量,就会直接抛出 UnboundLocalError,而绝不会自动退回读取全局变量。
2. 闭包:延续外部函数的生命周期
闭包是指一个内层函数记住了其诞生时所在的封闭作用域(Enclosing Scope),即使外层函数已经执行结束并返回,内层函数依然可以访问并持久化这些变量。
def make_counter(start=0):
    count = start
    def counter():
        nonlocal count  # 明确声明使用的是外层封闭作用域的变量,而非新建局部变量
        count += 1
        return count
    return counter

c1 = make_counter(10)
print(c1())  # 示例输出:11
print(c1())  # 示例输出:12
四、装饰器:被语法糖遮蔽的包装过程
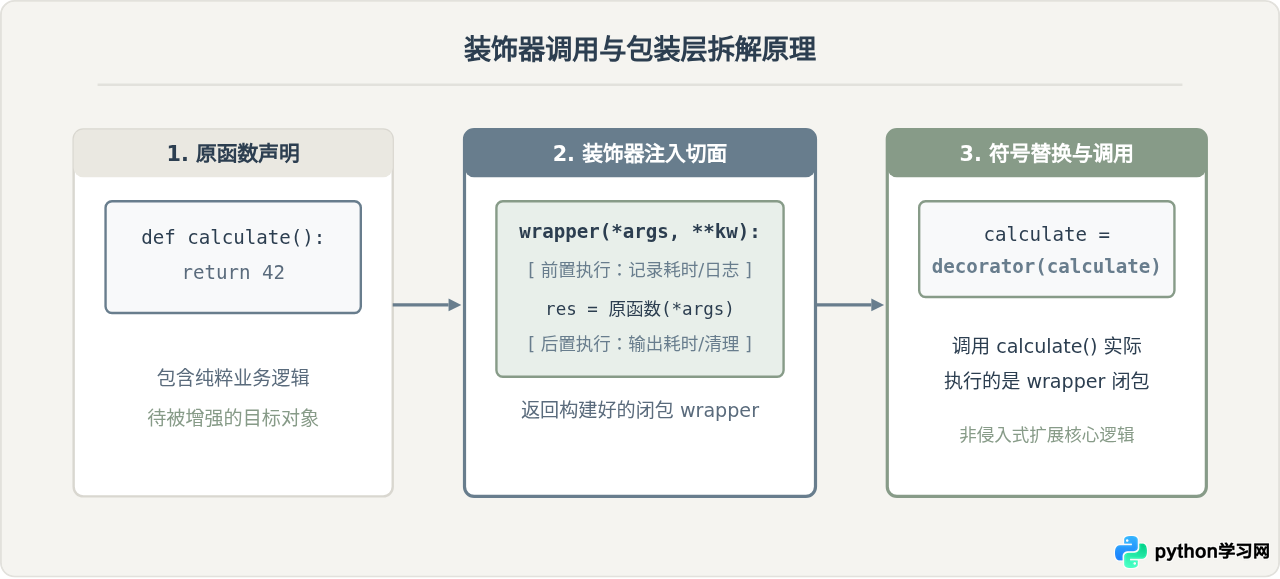
装饰器语法糖 @decorator 常被误认为某种特殊的黑魔法。实际上,它只是高阶函数调用的等价简写。
1. 语法糖的等价展开
在 Python 中,函数是一等公民(First-class Citizen),这意味着函数可以作为参数传递给另一个函数,也可以由另一个函数构造并返回。
当在函数前书写 @my_decorator 时,Python 解释器在完成函数定义后,实际上执行了一条简单的赋值重绑定语句:
func = my_decorator(func)
2. 编写装饰器的标准范式
为了保持被装饰函数的函数签名、文档说明和函数名不丢失,工程中必须配合 functools.wraps 使用:
import functools
import time

def timing_decorator(func):
    @functools.wraps(func)  # 保留 func 的 __name__、__doc__ 等元数据
    def wrapper(*args, **kwargs):
        start_time = time.time()
        result = func(*args, **kwargs)
        cost = time.time() - start_time
        print(f"[{func.__name__}] 执行耗时: {cost:.4f} 秒")
        return result
    return wrapper

@timing_decorator
def sample_task(count):
    """计算列表推导式总和"""
    return sum(i * 2 for i in range(count))

sample_task(1000000)
# 示例输出:[sample_task] 执行耗时: 0.0482 秒
五、迭代协议与生成器:从全量加载到按需流转
许多初学者习惯了列表等序列结构的“全量存储”特性,一旦接触到生成器(Generator)与 yield 关键字,便容易对执行流程的“暂停与恢复”产生困惑。
1. 可迭代对象(Iterable)与迭代器(Iterator)
这是两组经常被混淆但分工清晰的接口协议:
- 可迭代对象(Iterable):实现了
__iter__()方法,每次调用时返回一个独立的迭代器。如list、dict、str。可多次用于for循环遍历。 - 迭代器(Iterator):除了实现
__iter__()返回自身外,必须实现__next__()方法。它是有状态的单向游标,读取完一个值后游标前进,到达末尾抛出StopIteration,无法逆向或重复使用。
2. yield 的状态冻结机制
普通函数通过 return 彻底结束并释放栈帧中的局部变量。而在函数体内只要包含 yield 关键字,该函数就不再是普通函数,而是一个生成器工厂。
调用该函数不会执行函数体代码,而是返回一个生成器对象。只有当调用 next() 时,代码才执行到 yield 处,产生一个值并将当前栈帧、局部变量与执行进度完整“冻结”。当下一次调用 next() 时,程序从冻结位置无缝恢复并继续往下执行。
def data_stream_reader(total_items):
    print(">> 开始生成数据流...")
    for i in range(total_items):
        print(f">> 即将产出第 {i} 个元素")
        yield i
        print(f">> 第 {i} 个元素产出后恢复执行")

gen = data_stream_reader(2)
print("获取第一个值:", next(gen))
# 示例输出:
# >> 开始生成数据流...
# >> 即将产出第 0 个元素
# 获取第一个值: 0

print("获取第二个值:", next(gen))
# 示例输出:
# >> 第 0 个元素产出后恢复执行
# >> 即将产出第 1 个元素
# 获取第二个值: 1[x for x in range(10_000_000)] 会一次性申请数百兆甚至数吉字节内存存储所有对象;而改用圆括号生成器表达式 (x for x in range(10_000_000)) 时,常驻内存仅数十字节,数据按需逐个计算并立即被垃圾回收,彻底杜绝内存溢出。
六、易混淆概念与心智模型总结
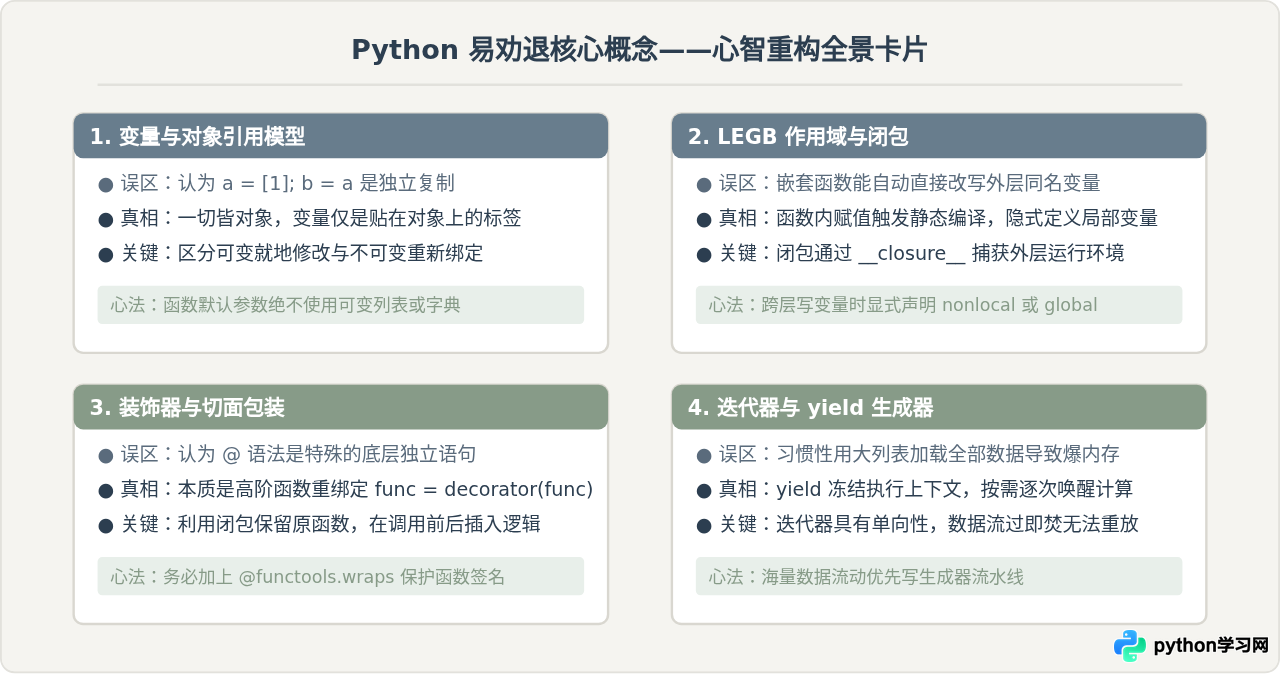
为了帮助初学者系统理清这四大核心概念,下表归纳了它们最易踩坑的表现形式与对应的心智模型法则:
| 难点概念 | 初学者常见直觉误区 | 底层本质机理 | 一句话避坑原则 |
|---|---|---|---|
| 对象与引用 | 赋值即复制独立的盒子 | 变量是挂在堆内存对象上的标签 | 可变对象做传参或默认参数必用 None 防御 |
| 作用域与闭包 | 内层函数能随意修改外层变量 | 赋值即标记局部;闭包捕获封闭环境变量 | 修改外层变量必须明确添加 nonlocal |
| 装饰器机制 | 被装饰函数被添加了特殊标志位 | 高阶函数重绑定:f = dec(f) |
三层嵌套按需写,外层用 @wraps 守住原函数元信息 |
| 迭代与生成器 | 迭代器等同于列表,能随意回退 | yield 状态机冻结当前运行上下文 |
大数据量管道流优先用生成器实现惰性求值 |
七、总结:跨越从“能写代码”到“理解运行机制”的门槛
Python 学习过程中出现的挫折,并非智力或理解力层面的阻碍,而是编程直觉未能随着语言特性的深入而及时更新。初学者容易把日常物理世界的习惯投射到代码中,认为“写在前面的就代表物理存在”、“给变量起个名字就拥有了独立数据”。
只要建立起“对象常驻堆区、变量提供指针标签、环境通过闭包驻留、求值按需惰性推进”的稳定心智模型,面对看似玄妙的装饰器、生成器或变量污染问题时,就能迅速定位到语言底层协议的交互点,写出稳健、优雅且高效的 Python 程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









