

Python嵌套字典怎么遍历和修改?多层数据处理指南
全面讲解Python多层嵌套字典的遍历、读取、就地修改与安全更新方法。通过树状结构解析、递归与迭代实现、混合列表字典处理及工程防坑指南,帮助开发者彻底掌握复杂字典数据的高效操作。
for 循环不仅捉襟见肘,还极易引发 KeyError 或对象被意外覆盖的副作用。处理多层字典的核心思想在于将“树形层级”转化为“路径或递归单元”:已知固定层级时依赖链式安全读取,未知深层时采用深度优先搜索(DFS)递归或栈遍历,就地修改时通过中间指针沿路径推进赋值。
一、理解嵌套字典的本质:多叉树结构
在深入编码前,必须建立一个清晰的心理模型:Python 中的嵌套字典本质上是一棵以根字典为起点的多叉树(Multi-way Tree)。每个外层键对应的值既可能是标量(如整数、字符串),也可能是包含分支的子字典,甚至是包含字典的列表。
当我们试图获取深层某个具体字段时,本质上是在树上根据一组连续的键执行“路径查找(Path Traversal)”。如果路径中的任何一个中间节点不存在或类型不符合预期,Python 解释器就会直接抛出异常中断执行。
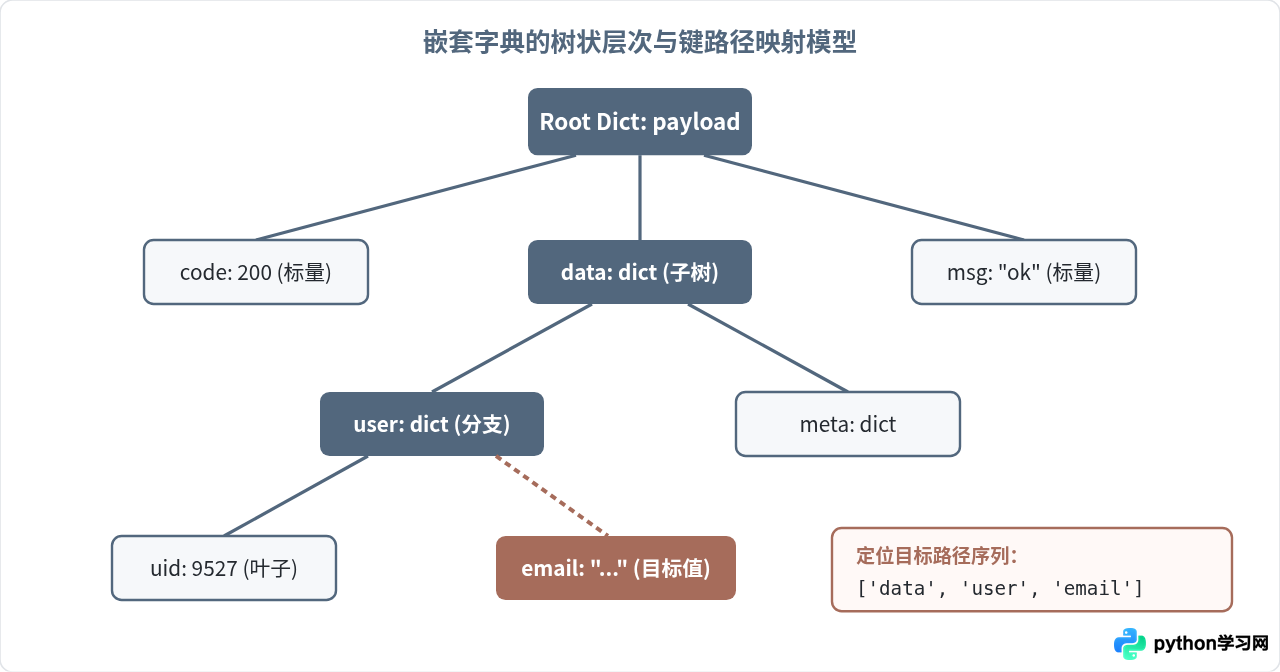
以下面这段典型的用户数据为例,我们可以直观看到多层嵌套的表现形式:
user_data = {
    "status": "active",
    "info": {
        "profile": {
            "name": "李雷",
            "contact": {
                "email": "lilei@example.com",
                "phone": "13800138000"
            }
        },
        "tags": ["developer", "python"]
    }
}
二、多层字典的遍历方法
遍历嵌套字典通常有两种业务目标:一种是全量扁平化遍历(列出树上每一个叶子节点的完整路径与取值),另一种是目标键搜索(找出所有名为 email 的值,无论它藏在第几层)。
1. 全量递归遍历(DFS 生成扁平路径)
使用递归是处理未知层级最自然的方式。在访问字典时,若当前值仍然是字典,就将当前键追加到路径中继续递归调用;若遇到叶子节点,则输出该完整路径。
def walk_nested_dict(d, parent_path=()):
    """递归遍历嵌套字典,生成所有叶子节点的 (路径元组, 值)"""
    for key, value in d.items():
        current_path = parent_path + (key,)
        if isinstance(value, dict):
            # 子节点是字典,继续递归下探
            yield from walk_nested_dict(value, current_path)
        else:
            # 遇到叶子节点,产出结果
            yield current_path, value

# 示例:执行遍历
for path, val in walk_nested_dict(user_data):
    path_str = " -> ".join(path)
    print(f"路径: {path_str:<32} 值: {val}")
运行结果将清晰展示整个树的遍历路线:
路径: status                           值: active
路径: info -> profile -> name          值: 李雷
路径: info -> profile -> contact -> email 值: lilei@example.com
路径: info -> profile -> contact -> phone 值: 13800138000
路径: info -> tags                     值: ['developer', 'python']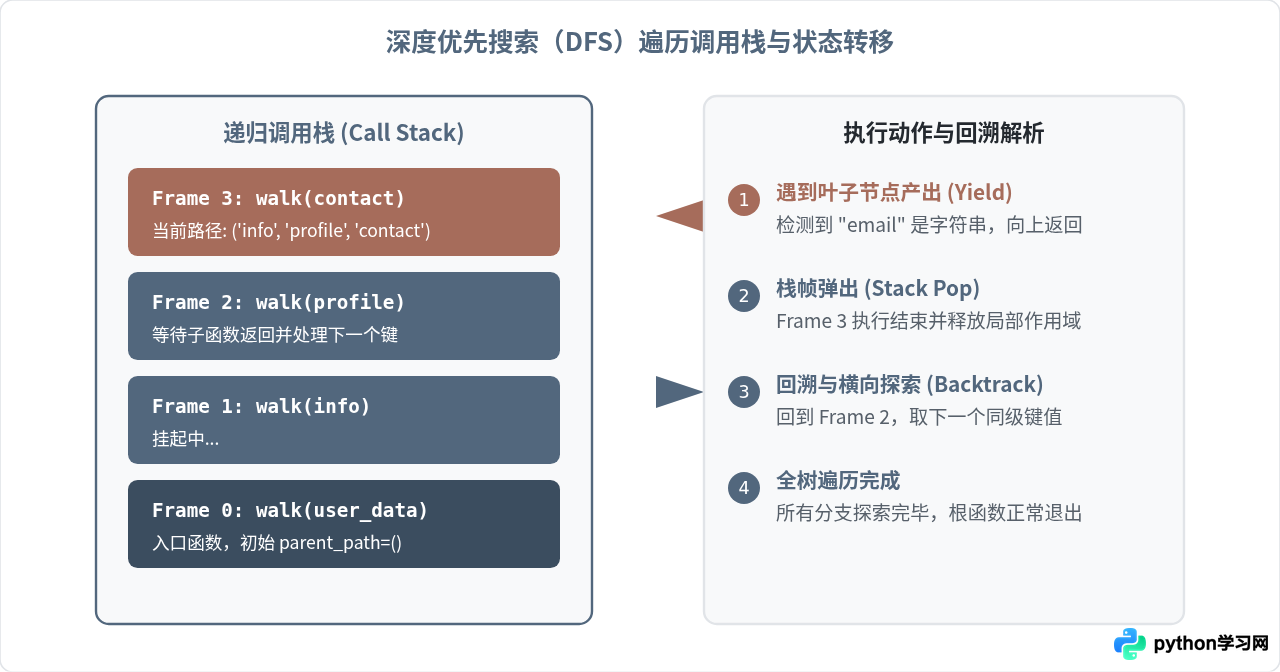
2. 显式栈实现的迭代遍历(防止 RecursionError)
Python 默认的递归调用栈深度通常限制为 1000 左右。如果面对层级极其庞大或深度不可控的异常数据,递归可能会触发 RecursionError。此时使用自定义栈(Stack)进行迭代遍历是更稳健的工程实践:
def walk_dict_iterative(d):
    """基于显式栈的迭代遍历,无需担心递归深度限制"""
    # 栈中元素格式:(当前字典/数据, 当前累积路径)
    stack = [(d, ())]

    while stack:
        current_data, current_path = stack.pop()

        for key, value in current_data.items():
            new_path = current_path + (key,)
            if isinstance(value, dict):
                stack.append((value, new_path))
            else:
                yield new_path, value
三、深层字典的查找与修改
很多初学者在需要修改深层字典时,最先想到的是硬编码链式赋值:
# 脆弱的高风险写法:
user_data["info"]["profile"]["contact"]["email"] = "new@example.com"
这种写法的前提是每层节点都必然存在。一旦 profile 或 contact 某个键是 None 或者根本不存在,程序就会立刻因为 KeyError 或 TypeError 崩溃。
1. 安全读取指定路径的值
可以使用循环推进或者 Python 标准库中的 functools.reduce,逐层提取值并在中途断裂时优雅返回默认值:
from functools import reduce

def get_nested_value(d, keys, default=None):
    """根据键路径安全读取深层值
    :param d: 源字典
    :param keys: 键序列,如 ['info', 'profile', 'contact', 'email']
    :param default: 路径不存在时的缺省返回值
    """
    curr = d
    for k in keys:
        if isinstance(curr, dict) and k in curr:
            curr = curr[k]
        else:
            return default
    return curr

# 示例调用
email = get_nested_value(user_data, ["info", "profile", "contact", "email"])
print(email) # 输出: lilei@example.com

# 访问不存在的路径不会抛出异常
phone = get_nested_value(user_data, ["info", "setting", "timezone"], default="UTC")
print(phone) # 输出: UTC
2. 就地修改与自动建树(Set Deep)
如果要在指定深层路径上修改某个值,若中途有任何一级子字典缺失,最优雅的逻辑应当是自动补齐中间的空字典,并最终定位到最深层容器赋予新值。
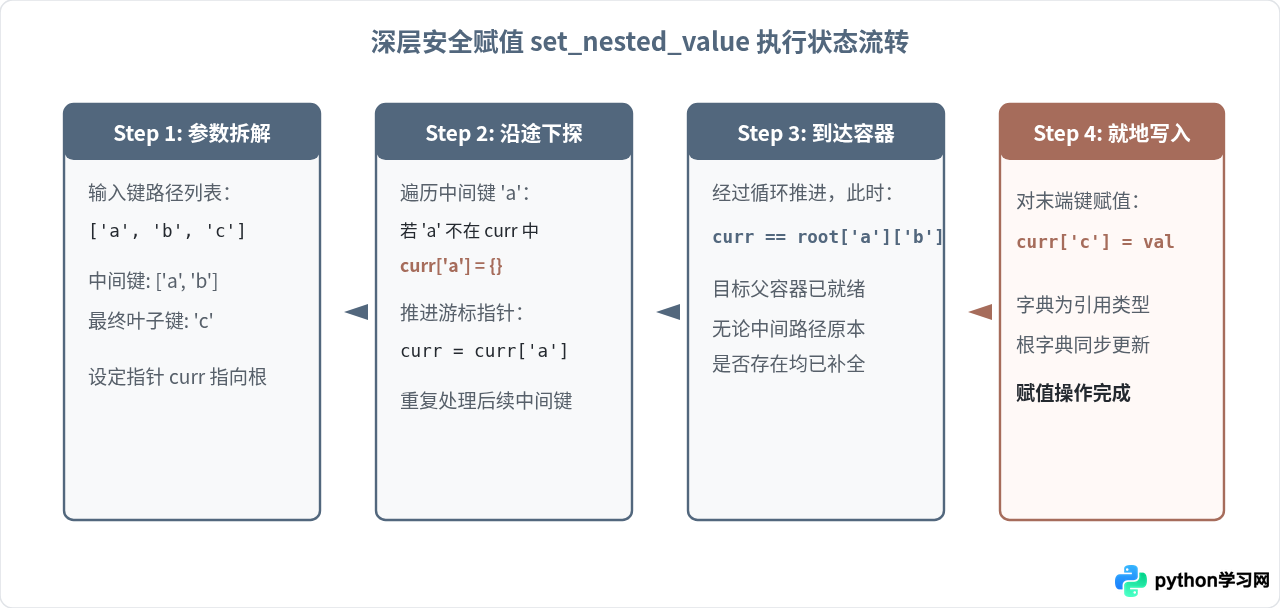
按照上述逻辑实现的代码如下:
def set_nested_value(d, keys, value):
    """沿键路径就地更新字典。若中间路径不存在,自动创建字典结构
    :param d: 目标字典
    :param keys: 路径列表或元组,如 ["info", "profile", "contact", "wechat"]
    :param value: 待赋予的新值
    """
    if not keys:
        return

    curr = d
    # 推进到倒数第二级节点
    for k in keys[:-1]:
        if k not in curr or not isinstance(curr[k], dict):
            curr[k] = {}
        curr = curr[k]

    # 在目标容器内赋值
    curr[keys[-1]] = value

# 测试:即使原来没有 setting 和 theme,也能直接建立并赋值
set_nested_value(user_data, ["info", "setting", "theme"], "dark")
print(user_data["info"]["setting"]["theme"]) # 输出: dark
3. 按键名全树递归修改与键重命名
在某些数据清洗场景中,我们需要把所有出现的 password 键替换为星号,或者把所有的蛇形命名(snake_case)改成驼峰命名(camelCase)。这时需要对整棵树进行后序/递归替换:
def transform_nested_dict(d, match_key, update_func):
    """递归扫描字典,遇到指定键名则通过 update_func 计算并更新新值"""
    for key, value in list(d.items()):
        if key == match_key:
            d[key] = update_func(value)
        elif isinstance(value, dict):
            transform_nested_dict(value, match_key, update_func)
        elif isinstance(value, list):
            # 处理列表中嵌套字典的情况
            for item in value:
                if isinstance(item, dict):
                    transform_nested_dict(item, match_key, update_func)

# 示例:把所有的 email 字符串统一转为小写脱敏格式
def mask_email(email_str):
    name, domain = email_str.split("@")
    return f"{name[:2]}***@{domain}"

transform_nested_dict(user_data, "email", mask_email)
print(user_data["info"]["profile"]["contact"]["email"]) # 输出: li***@example.com
四、避坑指南:必须警惕的边界问题
Python 默认的 dict.copy() 或 dict(d) 仅执行浅拷贝。外层键虽然生成了新字典,但深层的内层字典依然共享同一个内存地址。如果您修改了拷贝后的深层子字典,原始字典的数据也会被一并篡改!
import copy

# 错误示范:浅拷贝无法隔离深层修改
shallow = user_data.copy()
shallow["info"]["profile"]["name"] = "韩梅梅"
print(user_data["info"]["profile"]["name"]) # 输出: 韩梅梅(原始数据被污染!)

# 正确姿势:需要隔离修改时必须使用 deepcopy
deep = copy.deepcopy(user_data)
deep["info"]["profile"]["name"] = "李雷重新命名"
print(user_data["info"]["profile"]["name"]) # 依然是: 韩梅梅(原对象安全)
处理混合结构:字典套列表,列表套字典
真实的 JSON 数据往往不是纯粹的“字典套字典”,而是伴随着大量的数组结构,例如 {"items": [{"id": 1}, {"id": 2}]}。编写通用遍历函数时,必须同时考虑 list 类型的分支:
def universal_walk(obj, path=()):
    """支持字典和列表互嵌的通用遍历器"""
    if isinstance(obj, dict):
        for k, v in obj.items():
            yield from universal_walk(v, path + (k,))
    elif isinstance(obj, list):
        for idx, item in enumerate(obj):
            yield from universal_walk(item, path + (idx,))
    else:
        yield path, obj
五、方案选型与技术总结
在实际项目开发中,处理嵌套字典应当根据数据复杂度和工程规模,合理选择最简洁、维护成本最低的技术路线:
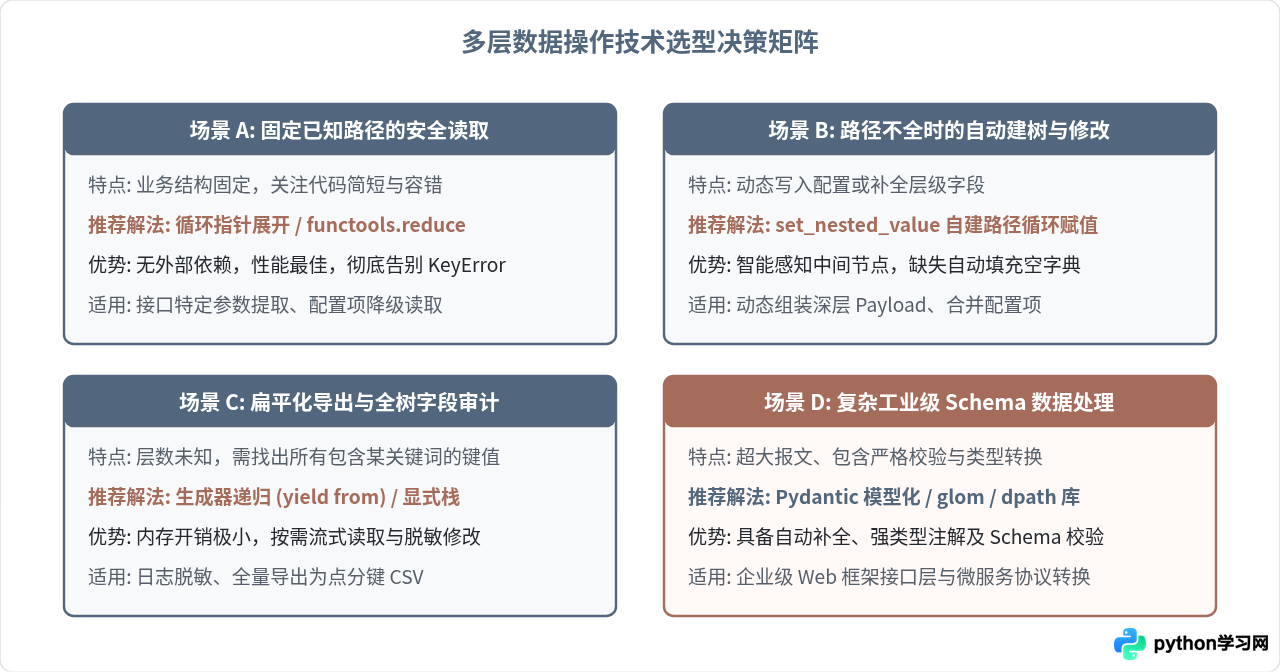
| 处理目标 | 核心技术要点 | 典型使用场景 | 避坑与注意事项 |
|---|---|---|---|
| 深层安全读取 | 循环指针推进 / get_nested_value |
读取特定配置、获取接口详情 | 切忌链式 ["k1"]["k2"] 硬编码,必加类型检查 |
| 深层就地修改 | 切分中间键与叶子键,自动补全缺失层级 | 更新深层设置、构建目标 Payload | 涉及副本操作时务必使用 copy.deepcopy() |
| 全树遍历提取 | 生成器递归 (yield from) 或栈迭代 |
全树打平转成扁平表、键名模式匹配 | 层级过深(>1000)时改用显式栈防止递归溢出 |
| 全局过滤脱敏 | 深度优先遍历 + 条件替换函数 | 数据落库前字段脱敏、批量时间戳转换 | 注意混合列表中的字典元素,需递归覆盖 |
掌握嵌套字典的本质在于理解“数据树”的拓扑逻辑。不管是遍历查找还是按路径修改,只要守住路径推进与类型安全检查两个关卡,多层复杂数据处理就会变得简洁、清晰且无懈可击。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









