

为什么Python成为现代软件技术栈的主流选择
深入解析Python成为现代软件技术栈核心选择的深层原因,探讨其在胶水架构、跨领域生态协同、开发迭代效率以及与底层高性能编译语言配合中的工程实践与选型边界。
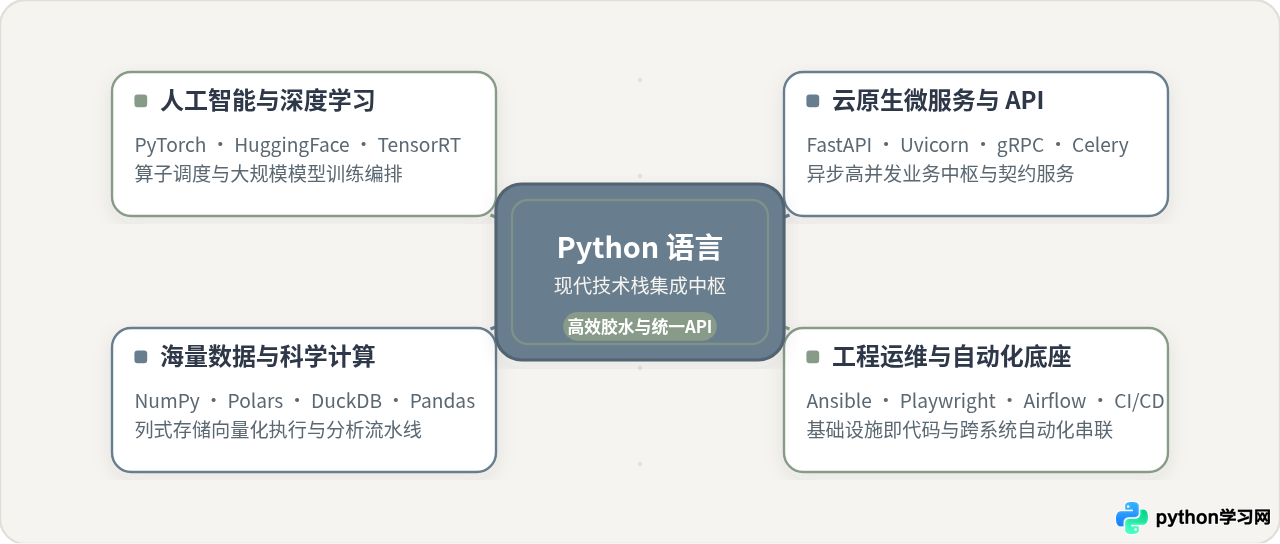
一、架构分层演进:“胶水语言”向控制中枢的蜕变
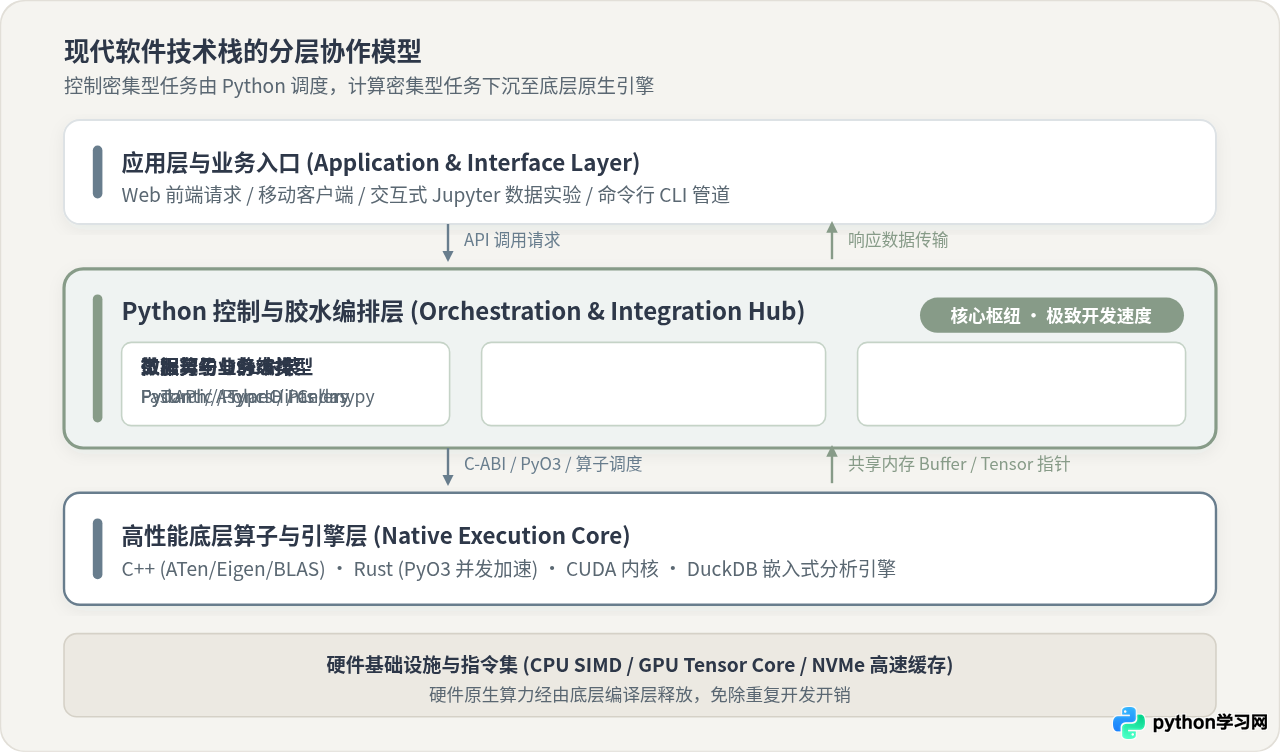
在早期的软件系统中,技术栈往往倾向于使用单一语言贯穿全局:要么全盘使用 C/C++ 追求极限性能,要么使用 Java 构建庞大的企业级单体应用。然而随着计算硬件多样化(如多核 CPU、GPU 集群、专用 TPU)以及数据规模的爆炸式增长,现代软件系统的内在结构发生了一次根本性的解耦:计算密集型(Compute-Bound)与控制密集型(Control-Bound)逻辑的分离。
控制密集型逻辑包括接收外部网络请求、解析数据格式、组织参数、验证业务规则、装配微服务调用链路等。这些任务的核心诉求是接口直观、语法表达精炼、排错透明,对指令级运行耗时不敏感。相反,计算密集型逻辑(如矩阵张量相乘、大规模列式数据过滤、图像频域变换)则严格受制于 CPU 缓存命中率与 SIMD 指令并行度。
Python 正是在这种分层架构中找到了不可替代的位置。它拥有清晰的 C-API 与跨语言互操作能力,能够直接将复杂的高性能底层运算库映射为符合直觉的高阶函数调用,成为全系统的“调度中枢”。
代码层面的分层调度示例:纯解释循环与底层向量化分发
为了直观理解这种分层调度的工程差异,我们可以观察以下两段同样用于计算一组浮点数平方和的代码逻辑。第一种采用纯 Python 原生解释循环,第二种通过 NumPy 调度底层经过 AVX-512 优化的 C 动态库:
import time
import numpy as np

# 生成包含 5,000,000 个双精度浮点数的测试数据
size = 5_000_000
data_list = [float(i) for i in range(size)]
data_array = np.arange(size, dtype=np.float64)

# 方式 A:纯解释器逐行循环(控制与计算混杂在解释器内部)
start_a = time.perf_counter()
total_a = 0.0
for val in data_list:
    total_a += val * val
duration_a = time.perf_counter() - start_a

# 方式 B:Python 仅作为调度指令,底层 C 算子执行连续内存向量化运算
start_b = time.perf_counter()
total_b = np.dot(data_array, data_array)
duration_b = time.perf_counter() - start_b

print(f"[方式 A] 纯 Python 解释循环耗时: {duration_a:.4f} 秒")
print(f"[方式 B] 底层 C 向量化调度耗时: {duration_b:.6f} 秒")
print(f"性能比率: 提升约 {duration_a / duration_b:.1f} 倍")[方式 A] 纯 Python 解释循环耗时: 0.2854 秒
[方式 B] 底层 C 向量化调度耗时: 0.0021 秒
性能比率: 提升约 135.9 倍在方式 B 中,Python 仅作为调度语句执行了微秒级的指令分发,实际的乘累加运算由底层高度优化的 BLAS 库直接接管。这种“表面上写的是 Python,骨子里跑的是硬件级 C/CUDA 代码”的模式,构成了 PyTorch、TensorFlow、Polars 等几乎所有主流 AI 与大数据框架的基石。
二、研发范式对比:全栈单一编译 vs 双层混合架构
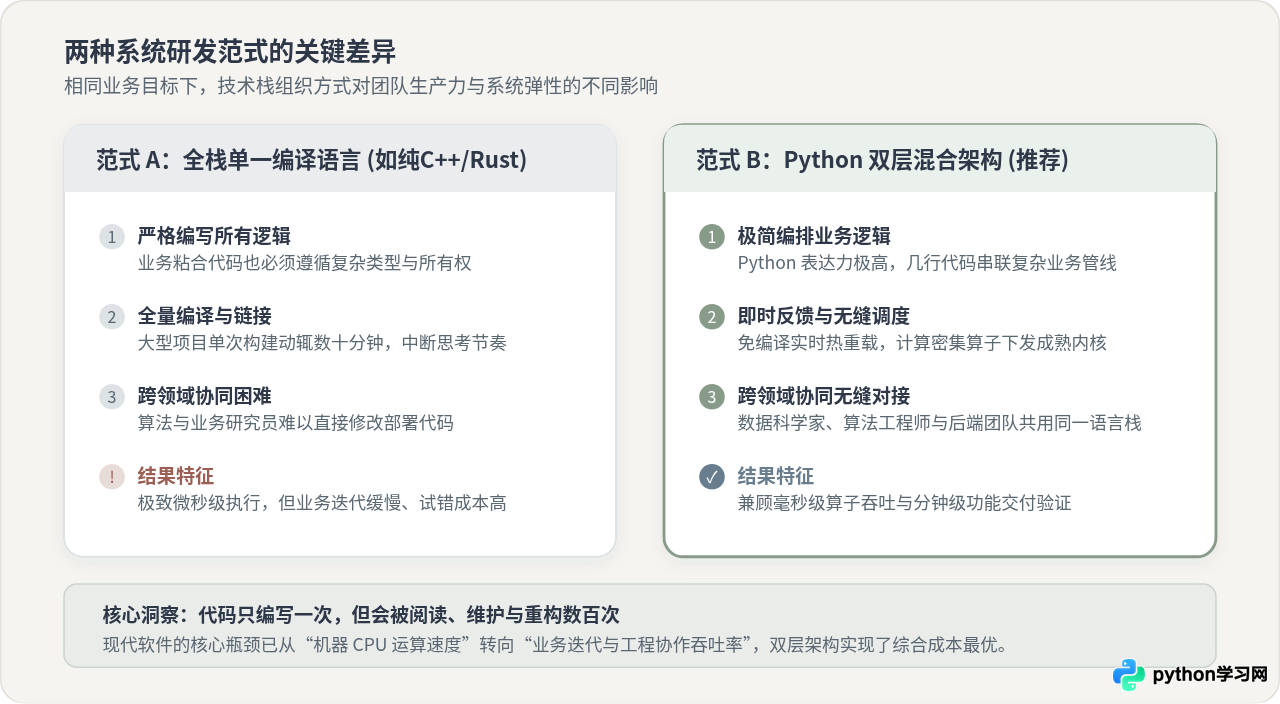
选择某种语言进入团队的技术栈,本质上是对团队研发模式的选择。我们通过对比两种典型做法来剖析关键差异:
| 对比维度 | 全栈单一底层编译语言 (如纯 C++ / Rust) | Python + 底层引擎双层混合架构 |
|---|---|---|
| 核心关注点 | 关注机器内存管理、生命周期与所有权 | 关注业务模型抽象、数据流动与验证 |
| 开发反馈循环 | 改动代码后需经历较长编译、链接与打包等待 | 即改即测,支持 REPL 与动态热重载探索 |
| 跨团队协作门槛 | 要求所有成员(算法、分析师、业务后端)精通底层系统编程 | 领域专家使用高级 Python API,工程团队沉淀底层插件 |
| 运行时吞吐极限 | 系统所有环节均拥有极高执行效率与内存紧凑度 | 核心计算由底层保障,网络编排层耗时在毫秒内可控 |
| 重构与试错代价 | 调整业务主流程涉及大量底层接口与生命周期改动 | 解耦程度高,调整编排逻辑通常只需数十分钟 |
这种差异为什么至关重要?因为在绝大多数现代业务形态中,需求的不确定性远高于计算的复杂度。如果每次探索新算法或验证新业务规则都需要承受庞大的编译周期和严格的所有权生命周期约束,团队的创新试错频率就会被严重压制。双层混合架构把稳定性要求极高的通用算子沉淀到底层,将频繁变动的编排逻辑留在 Python 层,从而在工业界形成了良性的正向循环。
三、从原型验证到工程交付的标准流水线
很多人曾对 Python 产生“只能写小脚本,无法做大型严谨系统”的偏见。这一偏见在现代 Python 工程体系中已被彻底打破。现代 Python 技术栈通过明确的三阶段工程流水线,实现了从快速验证到生产级高可用交付的平滑演进。
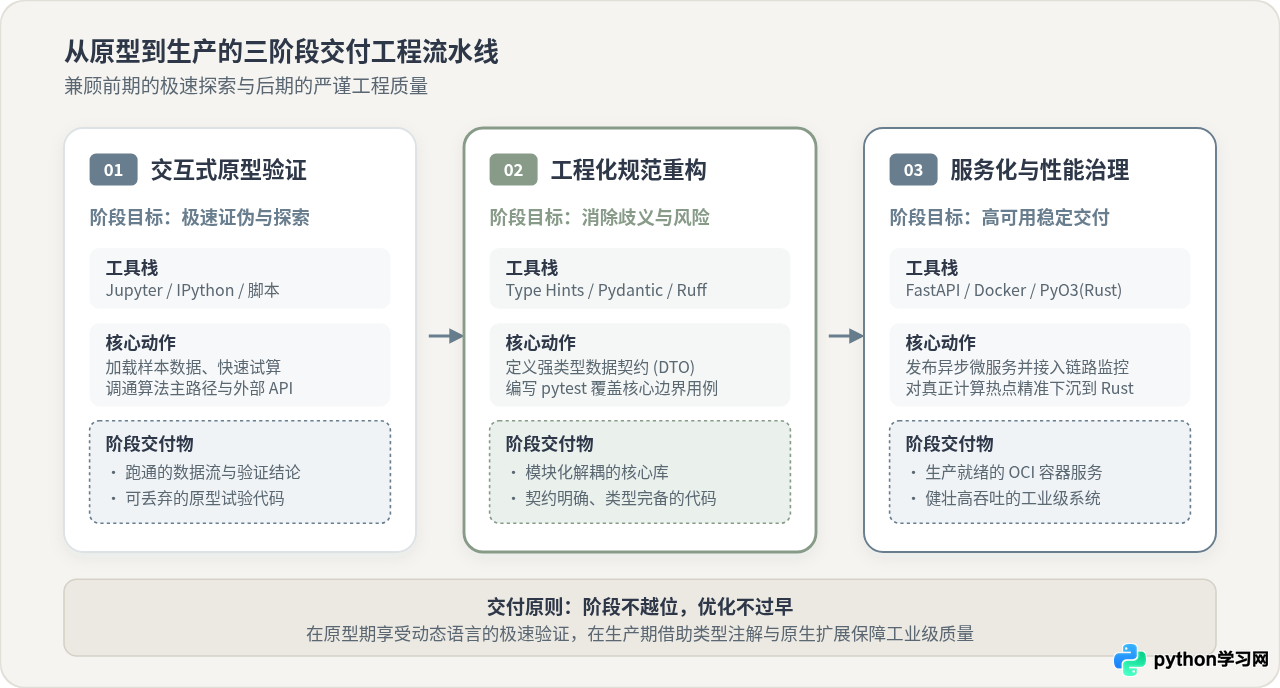
阶段一:交互式探索与可行性验证(0 到 1)
在这个阶段,目标是尽快验证算法假设或业务可行性。开发者通常借助 Jupyter Notebook 或 IPython 终端,直接加载真实环境的数据快照,使用 Pandas、Polars 或 Requests 快速调用第三方 API。此时不需要编写完备的测试或类抽象,代码以高灵活度为主,不可行的方案可以在数小时内迅速被识别并丢弃。
阶段二:工程规范化与契约重构(1 到 10)
当原型逻辑被证实具备商业价值后,代码必须脱离单文件脚本状态,进入工程化重构:
- 引入严格的类型注解(Type Hints):自 Python 3.10 起,内置联合类型(
A | B)与类型别名让函数签名变得严密明确,配合静态分析工具mypy可以在构建期拦截 80% 以上的空指针与参数传递错误。 - 使用 Pydantic 定义声明式数据契约:替代不可控的裸字典(
dict),在系统输入边界实现强类型转换与结构自校验。 - 完善自动化测试:使用
pytest编写针对核心业务逻辑与异常边界条件的单测套件,通过ruff统一代码规范与风格。
from typing import Annotated
from pydantic import BaseModel, Field, PositiveFloat
from fastapi import FastAPI, HTTPException, status

app = FastAPI(title="生产级推理与计算调度服务", version="2.1.0")

class InferencePayload(BaseModel):
    batch_id: str = Field(..., description="批次唯一追踪标识符")
    input_vector: list[float] = Field(..., min_length=1, max_length=1024, description="高维特征向量")
    threshold: PositiveFloat = Field(default=0.85, description="决策判定置信度阈值")

class InferenceResult(BaseModel):
    batch_id: str
    prediction_score: float
    is_positive: bool
    latency_ms: float

@app.post("/api/v1/predict", response_model=InferenceResult, status_code=status.HTTP_200_OK)
async def handle_predict(payload: InferencePayload) -> InferenceResult:
    # 静态类型检查器和 Pydantic 运行时已在入口确保了 payload 的完整与合法性
    if len(payload.input_vector) % 4 != 0:
        raise HTTPException(
            status_code=status.HTTP_422_UNPROCESSABLE_ENTITY,
            detail="输入向量维度必须为 4 的整数倍以满足底层 SIMD 对齐要求"
        )

    # 此处调用底层计算核心(或异步分发给 GPU 推理引擎)
    mock_score = sum(payload.input_vector) / len(payload.input_vector)

    return InferenceResult(
        batch_id=payload.batch_id,
        prediction_score=round(mock_score, 4),
        is_positive=mock_score >= payload.threshold,
        latency_ms=1.42
    )
阶段三:服务化封装与性能分层治理(10 到 100)
系统进入生产运行环境时,重点转向高可用、可观测性与精准性能治理:
- 异步并发网络服务:借助基于 ASGI 标准的异步网络框架(如 FastAPI、Uvicorn),单个应用实例能够轻松维持上万个长连接 IO。
- 容器化标准化交付:通过精简的 Docker 基础镜像(如
python:3.12-slim或 Distroless 镜像)封装依赖,接入 Kubernetes 集群实现自动扩缩容。 - 精准算子下沉(Performance Offloading):遇到真正的 CPU 计算瓶颈时,不要推翻整个 Python 架构,而是借助
PyO3将该特定函数用 Rust 编写并编译为.so / .pyd原生模块供 Python 无感导入调用。
cProfile 或 py-spy 采集真实的生产采样火焰图,准确定位瓶颈后再针对性下沉算子,避免过早进行底层语言全盘重写的过度设计。
四、选型边界与技术栈权衡考量
没有一种语言能包揽所有场景。理性地将 Python 纳入技术栈,必须清晰认识其物理局限与适用边界:
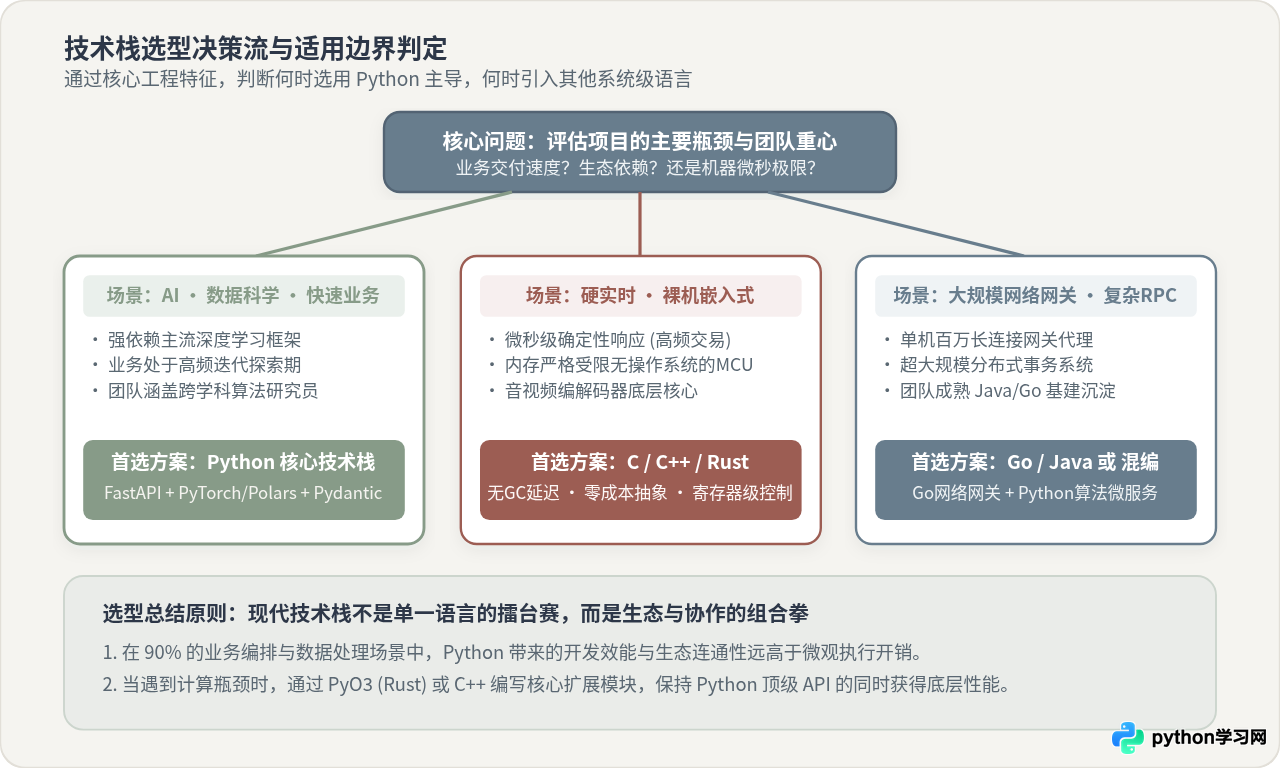
不推荐使用纯 Python 的特定场景
- 微秒级超低延迟硬实时系统:在高频交易撮合引擎、工业机械控制系统或自动驾驶底层规控中,必须要求内存无垃圾回收(GC)停顿、响应时间具有微秒级严格确定性。纯 Python 的自动引用计数与分代垃圾回收机制不满足此类条件,应使用 C++ 或 Rust。
- 极度受限的嵌入式无 OS 环境:在仅有几十 KB 运行内存的微控制器(MCU)裸机上,即使是 MicroPython 也存在一定开销,通常直接使用 C/C++。
- 海量短连接网络网关中枢:如果是单纯的超大流量协议转发代理(如 Envoy、Traefik),Go 或 Rust 提供的静态轻量级二进制文件在冷启动、内存基线占用和线程并发上更具成本优势。
关于全局解释器锁(GIL)的客观认识
在历史长河中,CPython 的全局解释器锁(GIL)常被提及。在多核时代,处理并发主要有两种模式:
- I/O 密集型并发:网络调用、数据库读取、微服务转发。Python 通过
asyncio单线程事件循环与协程机制,已经完全规避了 GIL 的阻碍,性能主要受限于网络和内核链路。 - CPU 密集型并发:数据挖掘、模型推理、视频分析。工程实践中普遍采用多进程(
multiprocessing/ProcessPoolExecutor)、Celery 分布式任务队列,或者直接将并发交给底层 C 线程池(NumPy 和 PyTorch 在进入原生计算时会主动释放 GIL)。 - 自由线程(Free-threaded)演进:Python 3.13 正式引入了实验性的无 GIL 构建版本(PEP 703),正在系统性解决解释器多线程并行瓶颈。
总结:人月成本与硬件成本的最佳平衡点
回顾现代软件工业的发展历程,技术的演进从未停止。Python 之所以能够成为横跨人工智能、数据平台、自动化基础设施与微服务后端的主流选择,是因为它精准契合了软件工程的基本规律:硬件算力成本逐年下降,而优秀的研发人才与时间成本始终高昂。
通过“高级语言表达意图,底层编译核心执行重载”的协作机制,Python 成功扮演了连接算法科学家、后端工程师与底层芯片算力的统一界面。在未来相当长的时间内,这种分层共存、各司其职的工程架构,仍将是构建复杂软件系统时最具生产力与弹性的技术栈基石。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









