

Python爬虫实战:用Requests和BeautifulSoup抓取静态网页
本教程针对初学者与工程开发者,系统讲解如何使用 Python 标准库 Requests 与 BeautifulSoup4 抓取并解析静态网页。涵盖网络请求构造、DOM节点定位、数据清洗落盘及异常防御全流程。
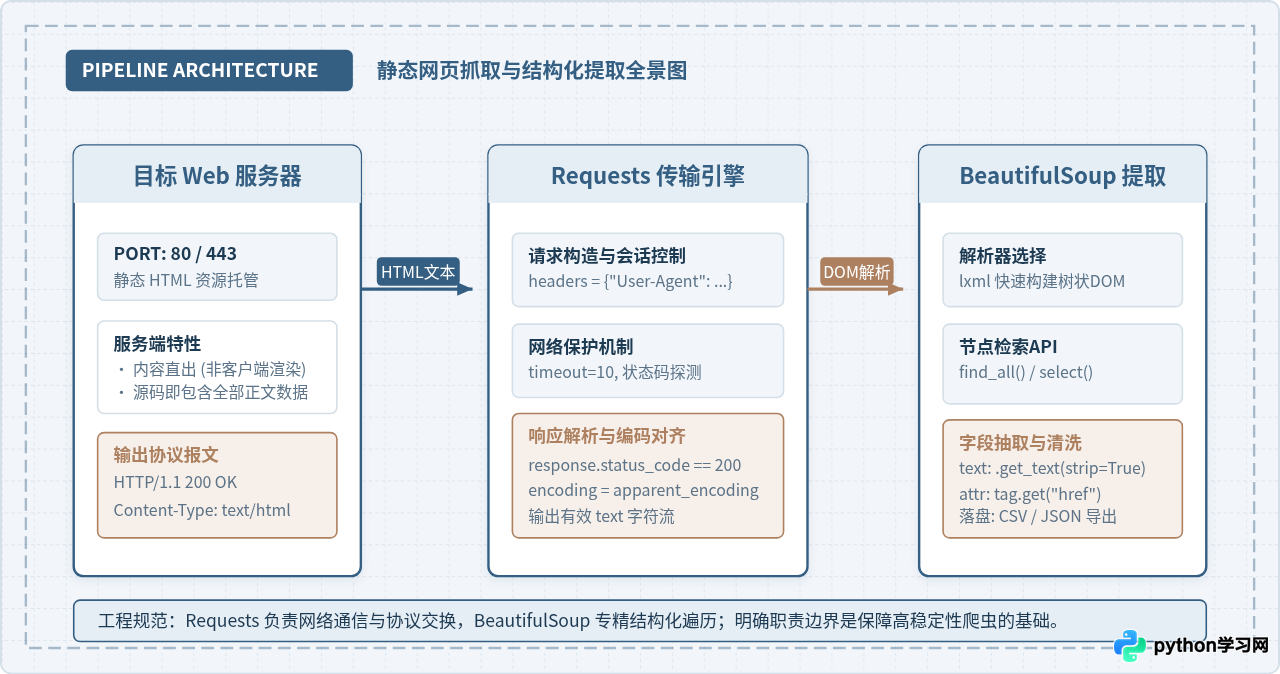
抓取静态网页是网络数据采集的基础环节。所谓静态网页,是指服务器在接收到客户端请求时,直接返回已经拼接好全部正文内容与结构的 HTML 源码,客户端无需运行前端 JavaScript 渲染即可获得完整信息。完成这项任务的核心技术链条非常纯粹:通过 requests 库模拟合规客户端发起 HTTP 请求并将服务器响应报文拉取到本地,再利用 beautifulsoup4 将 HTML 文本解析为层级 DOM 树,通过精确的节点选择器完成字段抽取与清洗。本文将从网络请求构造、DOM 节点定位、批量数据抽取到异常防御机制,完整讲解静态网页爬取的标准操作路径。
一、静态网页抓取的原理与工具分工
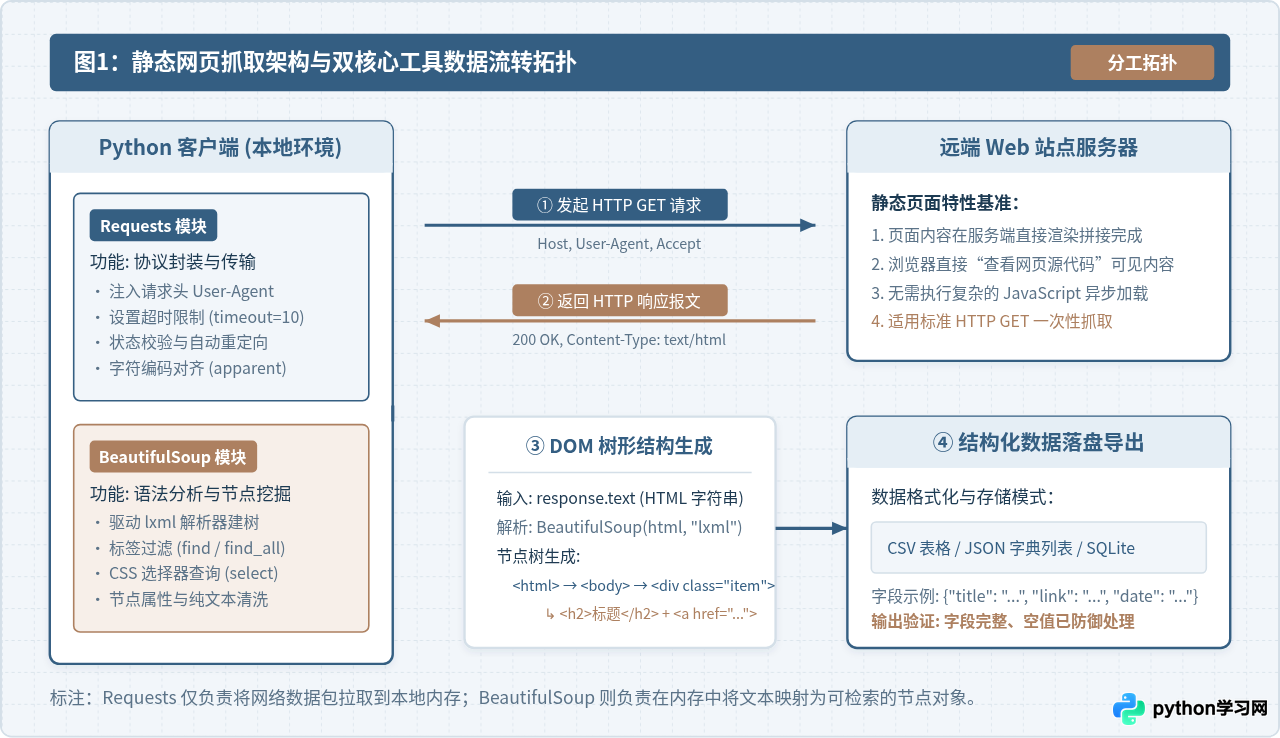
在编写爬虫代码前,必须先明确“静态网页”的判定标准以及 requests 与 beautifulsoup4 两者的职责边界。很多初学者容易将网络通信与文本解析混为一谈,导致在遇到内容缺失或解析报错时无从排查。
如何判断目标页面是否为静态网页? 最直接的验证方法是:在目标网页空白处右键点击“查看网页源代码”(快捷键 Ctrl+U 或 Cmd+Option+U),然后在打开的纯源码页面中按下 Ctrl+F 搜索你想要抓取的标题或数字。如果能直接搜到,说明该数据由服务端直接输出,属于标准静态内容;如果源码中完全搜不到,只有在浏览器 F12 的“元素(Elements)”面板中才能看到,说明数据是通过异步接口(如 AJAX / Fetch)加载并在前端渲染生成的动态内容,单纯抓取静态 HTML 无法直接获得目标数据。
在确认网页为静态结构后,爬虫开发采取明确的双层分工:
- 网络传输层(Requests): 充当客户端通信引擎。它只负责向指定的 URL 发送 HTTP GET 或 POST 请求,管理请求头(Headers)、Cookie、超时限制(Timeout)以及代理配置,并将目标服务器返回的状态码(Status Code)和原始响应字节流(
response.text或response.content)接收至本地内存。Requests 无法识别 HTML 的标签结构,也不具备筛选节点的能力。 - 语法分析层(BeautifulSoup): 充当数据提取解释器。它接收 Requests 提供的原始 HTML 字符串,通过底层的解析器(如
lxml)构建出完整的虚拟 DOM(文档对象模型)树,并提供诸如find()、find_all()以及 CSS 选择器select()等检索方法,让开发者能够精准提取特定标签下的文本或属性。BeautifulSoup 无法发起任何网络请求。
二、环境准备与依赖安装
进行静态网页抓取需要安装两个核心第三方库以及一个高性能解析器引擎。在终端或命令行工具中执行以下安装命令:
pip install requests beautifulsoup4 lxml各依赖项的作用如下:
requests:优雅且简洁的 Python HTTP 客户端库。beautifulsoup4:用于从 HTML 或 XML 文件中提取数据的解析库(代码中导入为bs4)。lxml:C 语言编写的底层解析器。相较于 Python 自带的html.parser,lxml的解析速度更快,且对存在语法瑕疵或未闭合标签的不规则 HTML 具备极强的容错修复能力,是工业级爬虫的首选解析后端。
安装完成后,可以在 Python 交互式环境中输入以下代码,验证模块是否正常加载:
import requests
from bs4 import BeautifulSoup

print(requests.__version__)
print(BeautifulSoup)
若无报错且输出版本号,即表明开发环境就绪。
三、静态网页爬取四步实战流程
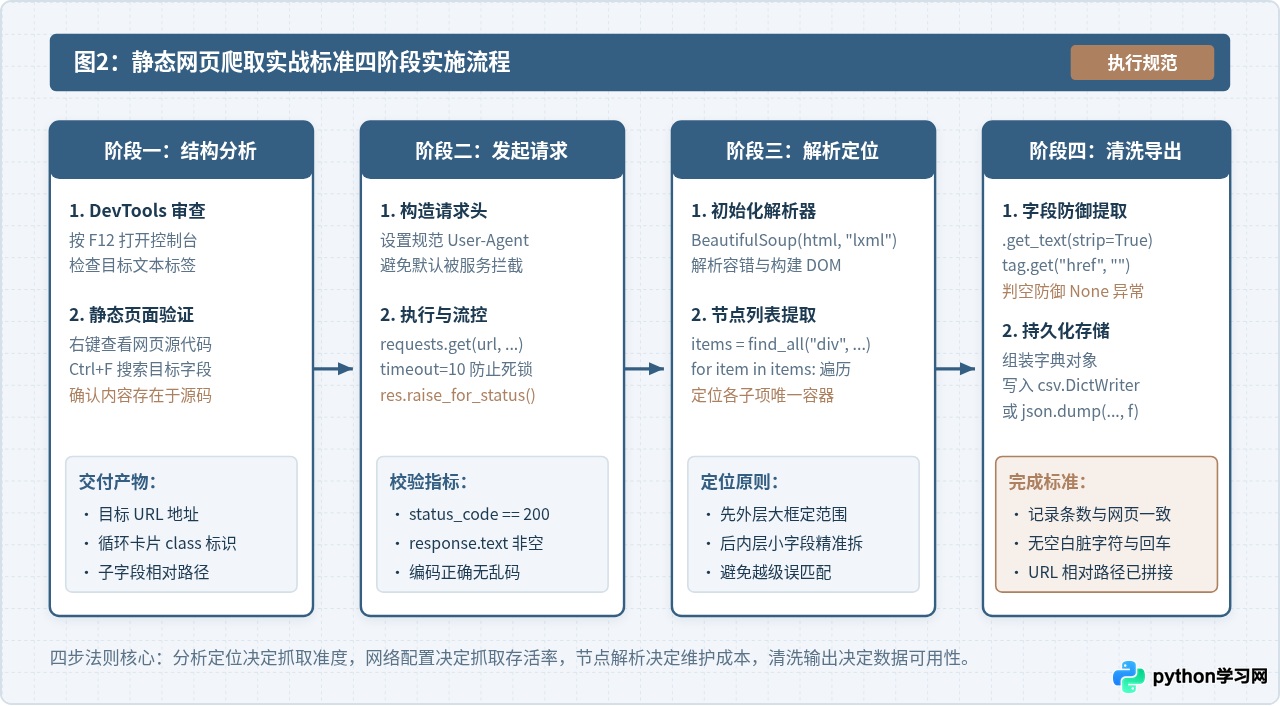
无论是抓取新闻列表、图书排行还是商品价格,规范的静态爬虫开发都应当遵循严格的四阶段工作流。清晰的流程拆解能够确保代码逻辑严谨,易于维护与排查问题。
第 1 步:分析目标页面与确定提取规则
打开 Chrome 或 Edge 浏览器,访问目标网页。按 F12 唤起开发者工具(DevTools),点击左上角的“检查元素”图标(快捷键 Ctrl+Shift+C / Cmd+Shift+C),鼠标悬停在要抓取的目标字段上:
- 观察列表卡片的公共外层父容器:通常为一个带有固定 class 的
<div class="item">、<article>或<tr>标签。 - 观察目标字段在容器内的相对标签:例如标题通常包裹在
<h3 class="title">或<a>内,价格通常位于<span class="price">内。 - 记下这些关键标签的标签名、class 名称或 id 标识。
第 2 步:构造合规请求并获取响应文本
直接使用 requests.get(url) 时,默认的请求头中 User-Agent 会显示类似 python-requests/2.x.x 的标识。许多 Web 服务器配置了基础安全过滤,识别到该标识会直接返回 403 Forbidden。因此,必须在请求头中显式传入常见的浏览器 User-Agent。
同时,网络请求必须配置 timeout 参数。若服务器由于负载过高或网络丢包未响应,缺少超时的请求会导致程序永久阻塞挂起。
import requests

url = "https://example.com/books"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

try:
    response = requests.get(url, headers=headers, timeout=10)
    # 状态码若非 200 系列,主动抛出 HTTPError 异常
    response.raise_for_status()
    # 自动对齐编码,防止中文出现乱码
    response.encoding = response.apparent_encoding
    html_content = response.text
except requests.exceptions.RequestException as e:
    print(f"请求发生异常: {e}")
html_content = Noneresponse.status_code == 200,且 len(response.text) 包含实质性内容。通过调用 response.raise_for_status(),可以在遇到 404 或 500 等错误时立刻中断后续无意义的解析。
第 3 步:初始化 BeautifulSoup 并定位节点列表
拿到 HTML 文本后,创建 BeautifulSoup 实例,传入 "lxml" 作为解析器。先找到所有的外层条目卡片,再在循环体内遍历每个卡片,逐一提取内部子字段:
from bs4 import BeautifulSoup

if html_content:
    soup = BeautifulSoup(html_content, "lxml")
    # 定位所有的卡片容器
    items = soup.find_all("div", class_="book-item")
    print(f"成功定位到 {len(items)} 个数据卡片")
第 4 步:字段清洗与结构化导出
对每个节点提取文本时,应使用 get_text(strip=True) 剥离前后空白与换行符;提取跳转链接时,使用 tag.get('href')。最后组装成字典,写入 CSV 文件或以 JSON 格式输出。
四、BeautifulSoup 核心提取方法与 DOM 导航
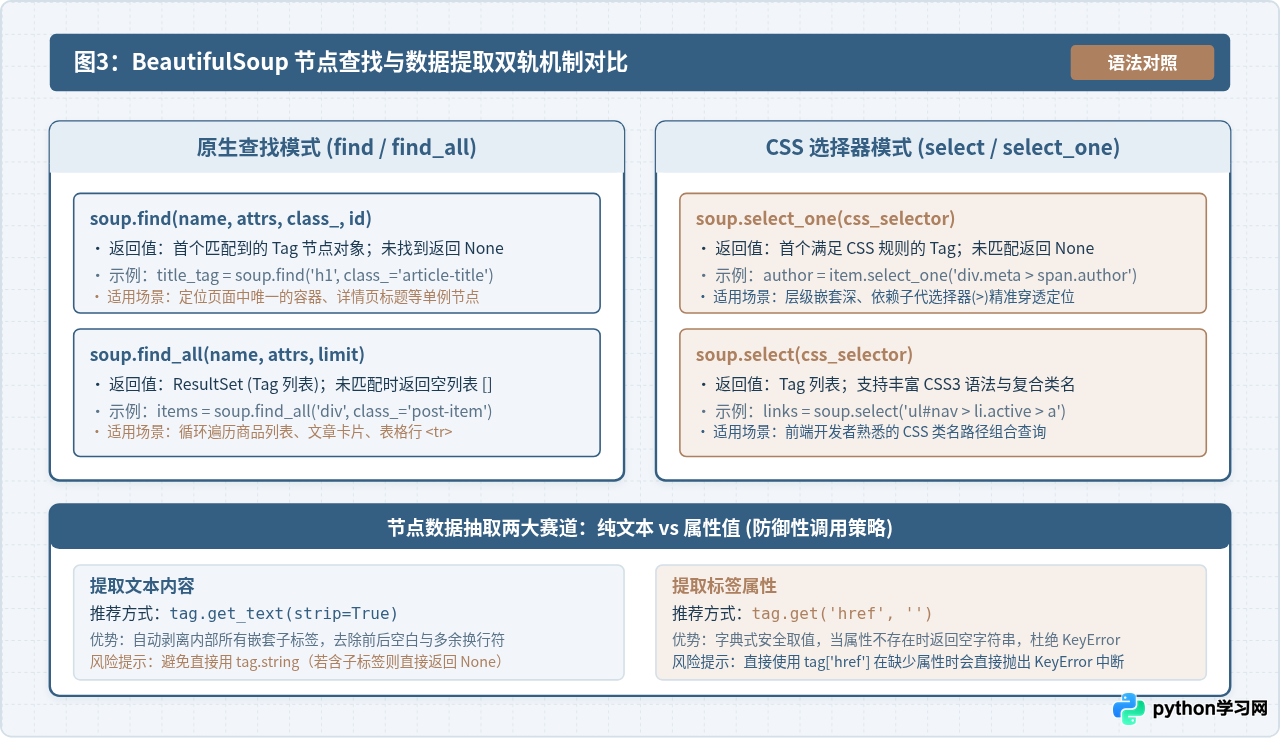
BeautifulSoup 提供了两套常用的节点定位机制:基于方法名称的原生查找 API(find / find_all),以及兼容前端开发习惯的 CSS 选择器 API(select / select_one)。两者底层构建的 DOM 树完全一致,但适用场景各具优势。
1. 原生 API:find 与 find_all
find() 用于检索符合条件的首个标签,匹配到即停止搜索,返回 bs4.element.Tag 对象;若未匹配到任何内容,返回 None。
find_all() 用于检索符合条件的所有标签,返回包含多个 Tag 对象的 ResultSet 列表;若未匹配到,返回空列表 []。
# 按标签名与 class 筛选
main_title = soup.find("h1", class_="page-title")

# 按多个属性组合筛选
featured = soup.find("div", attrs={"id": "main-content", "data-category": "tech"})

# 批量提取所有链接
all_links = soup.find_all("a", class_="nav-link")class 是 Python 的保留关键字,在使用 BeautifulSoup 参数时,必须写作 class_="your-class-name"(带有下划线),或者使用 attrs={"class": "your-class-name"}。
2. CSS 选择器 API:select 与 select_one
如果你熟悉 CSS 样式表或前端选择器语法,select() 和 select_one() 往往更加简洁直观,尤其在处理层级较深的嵌套结构时:
# 类选择器与后代穿透
titles = soup.select(".card-body > h2.card-title")

# ID 选择器与属性筛选
external_links = soup.select("#menu a[target='_blank']")

# 选取首个匹配项
first_book = soup.select_one("div.books-list div.item")
3. 提取文本与属性时的防御性写法
在提取数据时,必须预防两种常见的运行时崩溃:
- 文本提取安全原则: 优先使用
tag.get_text(strip=True),它会自动提取标签内所有嵌套文字并去除两端空格。切勿随意使用tag.string,因为当标签内部还包含其他子标签(如<p>这是<span>强调</span>文本</p>)时,tag.string会直接返回None。 - 属性提取安全原则: 提取
href、src等属性时,必须使用字典的tag.get("href", ""),而不是通过下标字典访问tag["href"]。若网页中某条标签恰好丢失了该属性,下标访问会直接引发KeyError异常中断整个抓取任务。 - 空节点判空原则: 在调用
.get_text()前必须确认节点不为None,即title_tag.get_text(strip=True) if title_tag else "无标题"。
五、完整实战代码:抓取静态列表并保存为 CSV
下面是一个工业级规范的完整可运行代码示例。该脚本模拟抓取一个标准的静态图书列表,包含请求头配置、HTTP 状态检测、编码对齐、DOM 遍历、数据清洗、相对路径补全以及将最终数据保存到 CSV 文件的完整流程。
import csv
import os
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

def scrape_static_catalog(base_url, output_csv_path):
    # 1. 规范请求头定义
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/120.0.0.0 Safari/537.36"
        ),
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
    }

    print(f"[1/4] 正在请求目标页面: {base_url}")
    try:
        response = requests.get(base_url, headers=headers, timeout=12)
        response.raise_for_status()
        # 自动识别字符集,防止中文乱码
        response.encoding = response.apparent_encoding
    except requests.exceptions.RequestException as err:
        print(f"[-] 网络请求失败: {err}")
        return False

    # 2. 构建 BeautifulSoup DOM 树
    print("[2/4] 网络响应成功 (200 OK),初始化 lxml 解析器...")
    soup = BeautifulSoup(response.text, "lxml")

    # 3. 定位商品/内容卡片容器列表
    # 假设页面中每个书籍卡片位于 <article class="product_pod"> 中
    cards = soup.find_all("article", class_="product_pod")
    if not cards:
        # 兼容 CSS 选择器备选方案
        cards = soup.select(".product_pod")

    print(f"[3/4] 成功匹配到 {len(cards)} 条数据卡片,开始提取字段...")
    extracted_records = []

    for index, card in enumerate(cards, start=1):
        # 提取标题与详情相对链接
        title_tag = card.find("h3")
        a_tag = title_tag.find("a") if title_tag else None

        # 安全获取标题文本
        if a_tag and a_tag.get("title"):
            title = a_tag.get("title").strip()
        elif a_tag:
            title = a_tag.get_text(strip=True)
        else:
            title = "未知标题"

        # 提取链接并转换为绝对路径
        relative_link = a_tag.get("href", "") if a_tag else ""
        full_link = urljoin(base_url, relative_link) if relative_link else "无链接"

        # 提取价格字段
        price_tag = card.find("p", class_="price_color")
        price = price_tag.get_text(strip=True) if price_tag else "N/A"

        # 提取库存状态
        avail_tag = card.find("p", class_="instock availability")
        availability = avail_tag.get_text(strip=True) if avail_tag else "未知"

        # 记录清洗后结构化条目
        record = {
            "id": index,
            "title": title,
            "price": price,
            "availability": availability,
            "url": full_link
        }
        extracted_records.append(record)

    # 4. 持久化存储至 CSV
    print(f"[4/4] 提取完成,共 {len(extracted_records)} 条有效记录,开始落盘...")
    fieldnames = ["id", "title", "price", "availability", "url"]

    try:
        with open(output_csv_path, mode="w", encoding="utf-8-sig", newline="") as csvfile:
            writer = csv.DictWriter(csvfile, fieldnames=fieldnames)
            writer.writeheader()
            writer.writerows(extracted_records)
        print(f"[+] 数据已成功写入文件: {output_csv_path}")
        return True
    except IOError as io_err:
        print(f"[-] 文件写入失败: {io_err}")
        return False

# 执行入口示例说明 (按需配置目标地址及输出路径)
if __name__ == "__main__":
    target_site = "https://books.toscrape.com/"
    target_output = "scraped_books.csv"
    # scrape_static_catalog(target_site, target_output)
print("代码示例就绪。使用时调用 scrape_static_catalog(target_site, target_output) 即可。")utf-8-sig? 在 Windows 系统下,如果直接使用 utf-8 写入 CSV,Excel 软件打开时可能由于缺少 BOM 标记而出现中文字符乱码。使用 utf-8-sig 能完美兼容 Excel 与各平台文本编辑器。
六、常见问题排查与防御性策略
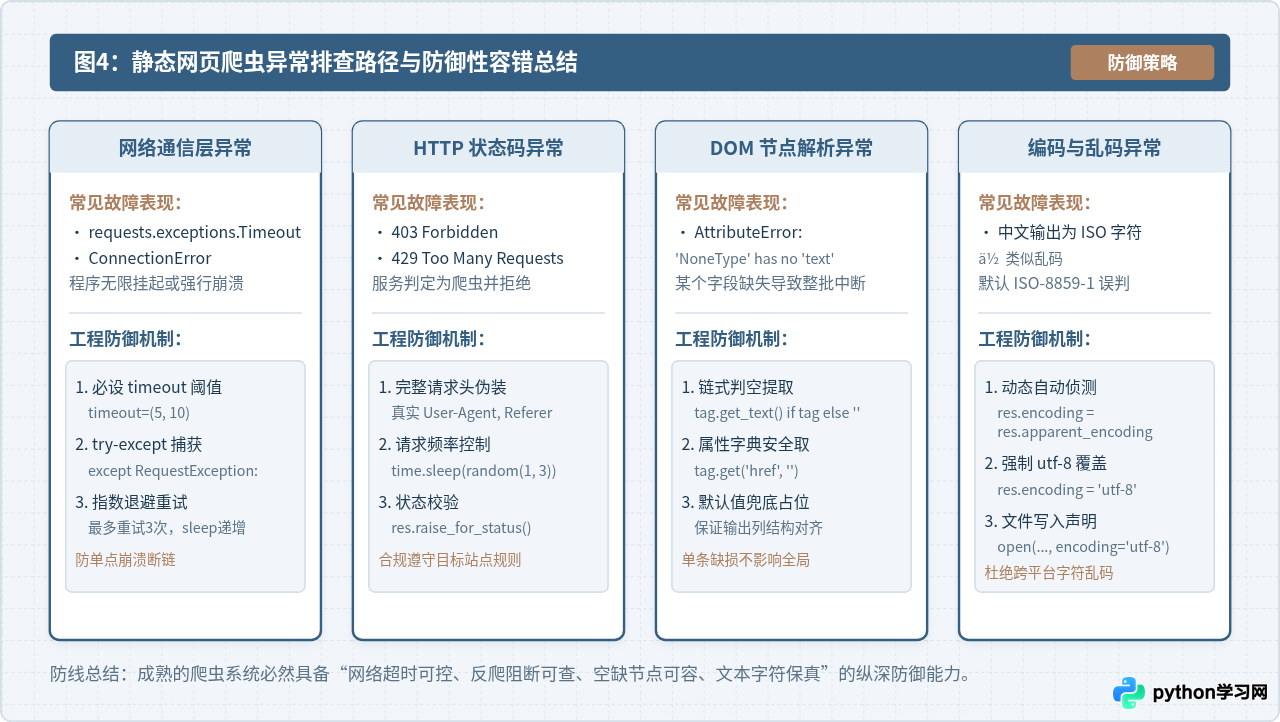
在实际抓取过程中,网络波动、目标站点的反爬措施、页面改版以及字段空缺是不可避免的。建立完善的防御性排查机制,是保证爬虫长期稳定运行的核心要求。
1. 遇到 403 Forbidden 或被风控拦截
原因: 目标站点检测到非浏览器行为。
解决方法:
- 检查
headers是否完整配置了真实的User-Agent。 - 增加
Referer请求头,指明是从哪个上级页面跳转而来。 - 在多次请求之间增加随机延迟,例如
import time, random; time.sleep(random.uniform(1.0, 3.0)),严禁高并发强行刷取导致服务器过载。
2. AttributeError: 'NoneType' object has no attribute 'get_text'
原因: 调用 tag.find(...) 未能在 DOM 中找到匹配节点,返回了 None,随后直接调用 None.get_text() 引发 Python 致命异常。
解决方法: 绝不对未经验证的节点直接链式提取。必须通过三元运算符或条件分支先判空:
# 错误写法(极端危险)
content = soup.find("div", class_="article-body").find("p").get_text()

# 正确写法(防御性编程)
body_div = soup.find("div", class_="article-body")
if body_div:
    p_tag = body_div.find("p")
    content = p_tag.get_text(strip=True) if p_tag else ""
else:
    content = ""
3. 抓取到的中文字符显示为乱码
原因: 目标服务器响应头中的 Content-Type 没有指定编码或错误指定了 ISO-8859-1,导致 Requests 采用了错误的解码方案。
解决方法: 在调用 response.text 前,执行 response.encoding = response.apparent_encoding,让 Requests 底层的 chardet / charset_normalizer 模块通过分析实际字节流自动推测真实字符集。
4. 页面存在分页时的翻页处理机制
对于多页静态内容,通常可以通过 URL 参数进行翻页(如 page=1、page=2)或者从页面底部的“下一页”按钮中提取下一页的相对链接:
next_btn = soup.find("li", class_="next")
if next_btn and next_btn.find("a"):
    next_relative_url = next_btn.find("a").get("href")
    next_full_url = urljoin(current_url, next_relative_url)
    # 继续请求下一页...
七、实战总结
静态网页抓取的核心本质在于“网络通信对齐协议,数据解析面向层级,代码编写面向防御”。利用 Requests,我们以最小的系统开销完成了 HTTP 通信与报文拉取;借助 BeautifulSoup 与 lxml,我们在内存中精确重现了 DOM 树形层次并完成高效提取。
在实际工程项目中,务必保持良好的网络礼仪:合理控制采集频率、避免对目标站点造成服务冲击、遵守 robots.txt 协议,并通过完善的异常捕获与字段兜底,编写出稳定、健壮且易于扩展的数据抓取脚本。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









