

Python 3在数据分析、Web开发和人工智能中的主要应用场景

Python 3在当今软件工程中并非通用全能的万能钥匙,其真正的工程优势建立在高度专业化的生态粘合能力上:在数据分析中承担表格清洗与探索性建模,在Web开发中支撑业务API与胶水层集成,在人工智能中则作为底层C/C++与GPU算力调度的事实标准前端。本文围绕这三大领域的真实工程边界,解析主流应用场景、选型条件及落地实现路径。
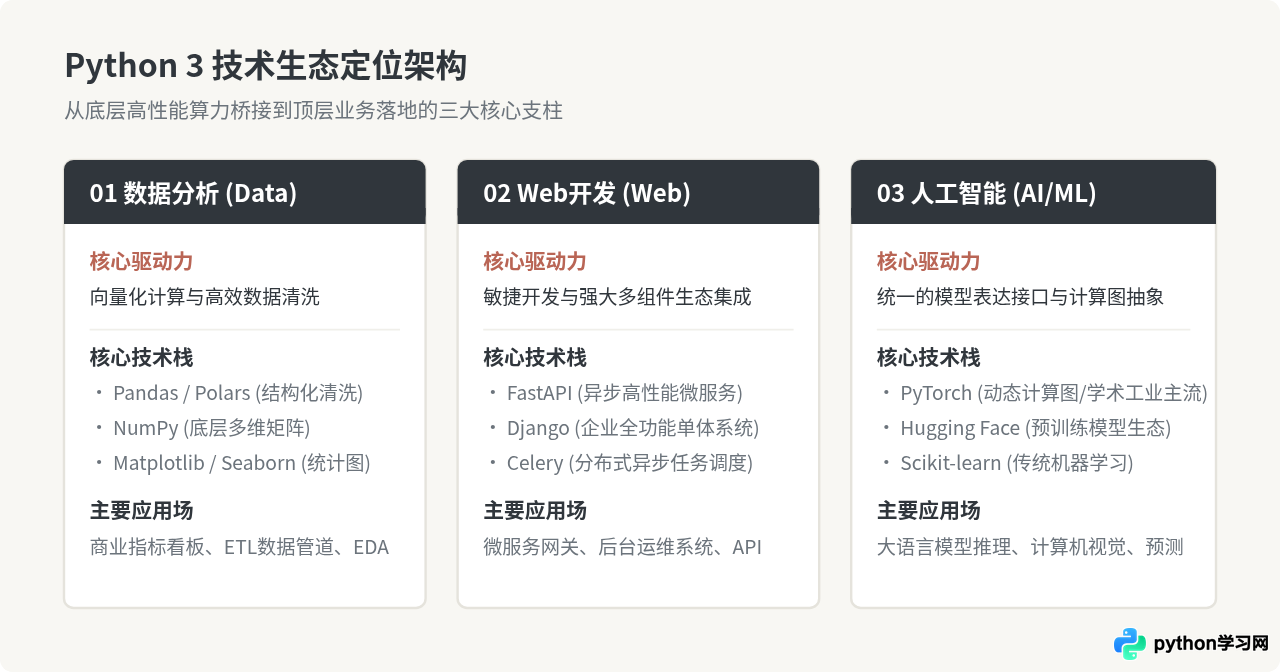
一、数据分析:从非结构化清洗到指标建模
在数据分析领域,Python 3的核心价值在于将混乱的原始数据转化为可行动的商业洞察。与静态脚本语言不同,Python拥有以NumPy内存连续数组为基石的底层体系,结合Pandas的DataFrame抽象,让分析人员可以在单机环境下完成数百万行记录的交互式排查与统计建模。
1. 核心应用场景
- 探索性数据分析(EDA): 在产品上线或模型训练前,使用Jupyter Notebook配合Pandas进行字段分布统计、缺失值填补、异常偏离值排查。
- 轻量级ETL数据管道: 定期从关系数据库(MySQL/PostgreSQL)、三方API及日志文件中拉取数据,完成聚合运算与格式转换,并写回数据仓库或报表库。
- 自动化统计报表输出: 结合OpenPyXL或XlsxWriter,将分析结果自动格式化为带高亮告警的多工作表Excel报表,并自动推送业务方。
2. 数据清洗与指标聚合实操流程
以电商日常交易明细为例,数据分析的标准流程包括:加载原始CSV、转换日期类型、过滤无效订单、按维度计算营收与复购指标。
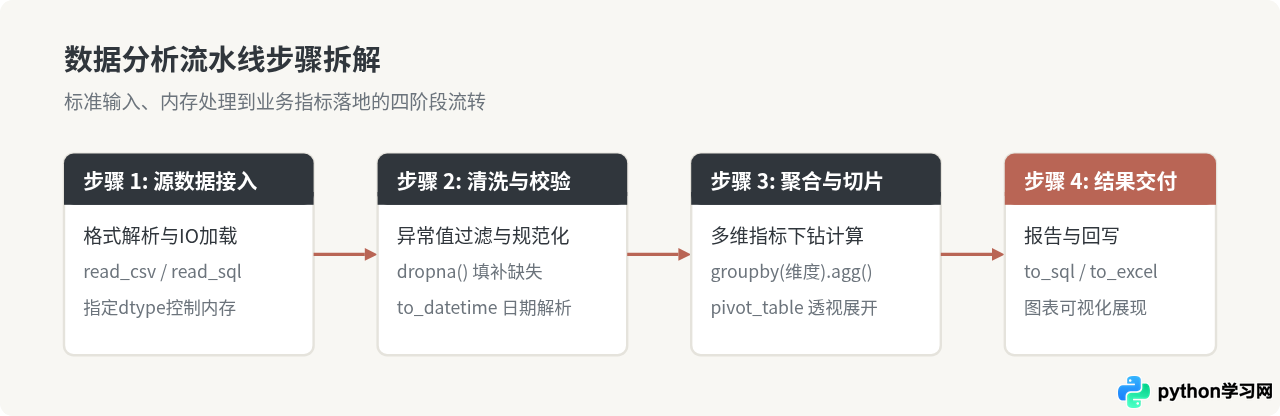
以下代码演示如何在本地使用Pandas高效清洗订单并统计各品类的销售总额与客单价:
import pandas as pd

# 1. 模拟原始订单数据(通常源自 pd.read_csv 或数据库查询)
data = {
    "order_id": ["A101", "A102", "A103", "A104", "A105"],
    "category": ["办公设备", "电子数码", "办公设备", "图书文具", None],
    "amount": [128.5, 3499.0, -10.0, 45.0, 210.0],  # 包含脏数据 -10.0
    "pay_time": ["2026-03-01 10:20:00", "2026-03-01 11:05:00", "2026-03-02 09:12:00", "2026-03-02 14:00:00", "2026-03-03 16:30:00"]
}
df = pd.DataFrame(data)

# 2. 清洗操作:剔除品类为空的数据,过滤金额异常值(负数退款需另存通道)
clean_df = df.dropna(subset=["category"]).copy()
clean_df = clean_df[clean_df["amount"] > 0]

# 3. 类型转换与分组聚合
clean_df["pay_time"] = pd.to_datetime(clean_df["pay_time"])
summary = clean_df.groupby("category").agg(
    total_sales=("amount", "sum"),
    order_count=("order_id", "count")
).reset_index()

summary["avg_ticket"] = summary["total_sales"] / summary["order_count"]
print(summary)
执行结果说明(示例):
   category  total_sales  order_count  avg_ticket
0      图书文具         45.0            1        45.0
1      办公设备        128.5            1       128.5
2 电子数码 3499.0 1 3499.0Polars,或者转向分布式计算框架如 PySpark。避免在Pandas中使用 for 循环逐行遍历(iterrows),优先使用矢量化算子或 apply。
二、Web开发:高并发API与企业级管理后台
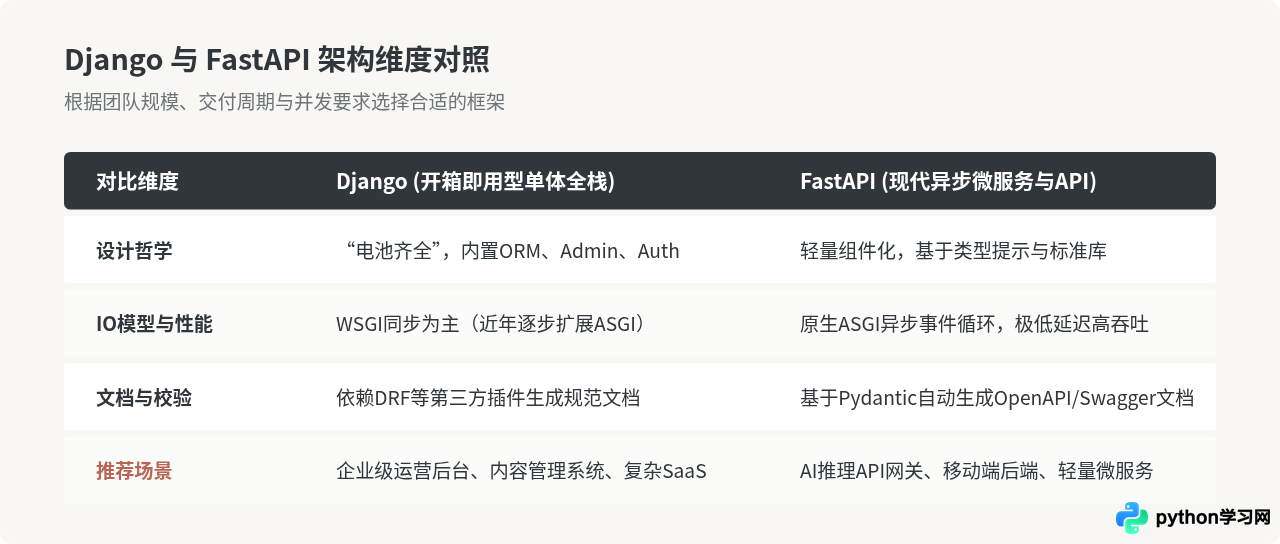
Python在Web开发中并不追求极端的纯计算吞吐(该领域属于Go或Rust),其核心竞争力在于极短的交付周期、健全的ORM封装以及对异步IO(asyncio)的原生支持。现代Python Web开发已高度分化为两类主流架构:以Django为代表的全功能单体系统,以及以FastAPI为代表的现代高性能异步微服务。
1. 选型对比:Django vs FastAPI
2. 典型实操:构建异步RESTful API
在涉及AI模型调度或高并发第三方Webhook对接时,使用FastAPI能以极简语法保证类型安全与自动参数校验:
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field
import uvicorn

app = FastAPI(title="任务分配与派发服务")

# 请求体结构定义与字段校验
class JobRequest(BaseModel):
    task_name: str = Field(..., min_length=2, max_length=50, description="任务名称")
    priority: int = Field(default=1, ge=1, le=5, description="优先级1-5")

@app.post("/api/v1/jobs")
async def create_job(job: JobRequest):
    # 模拟业务逻辑验证
    if job.task_name == "invalid_test":
        raise HTTPException(status_code=400, detail="保留名称,不可作为业务任务")

    # 模拟异步持久化或消息入队
    return {
        "status": "success",
        "job_id": 9527,
        "task_name": job.task_name,
        "priority": job.priority
    }

if __name__ == "__main__":
    # 本地启动测试服务器
    uvicorn.run(app, host="127.0.0.1", port=8000)
验证方式: 启动脚本后,访问 http://127.0.0.1:8000/docs,系统已自动根据Pydantic声明生成可交互的Swagger文档,支持直接发送JSON Payload并实时校验类型合规性。
三、人工智能:从模型训练到服务化推理
在人工智能领域,Python 3扮演着“顶层调度指挥官”的角色。深度学习背后的矩阵乘法与微分自动求导计算运行于底层由CUDA或C++编写的算子库中,但Python提供了无可替代的高层表达抽象,使研究人员能够以直观的面向对象代码定义复杂的神经网络拓扑。
1. 核心应用场景
- 大语言模型(LLM)微调与推理落地: 使用Hugging Face生态的
transformers、peft(LoRA)库对开源基础模型进行参数微调,并结合vLLM构建高吞吐流式推理网关。 - 传统机器学习特征工程与分类预测: 使用
scikit-learn进行高维特征缩放、PCA降维以及Random Forest、LightGBM分类回归模型训练。 - 计算机视觉(CV)管道: 结合
OpenCV和PyTorch Vision构建工业质检缺陷识别、人脸识别或视频结构化解析。
2. 典型实操:基于PyTorch构建简单回归模型
以下示例展示如何利用PyTorch的核心抽象(nn.Module、损失函数、反向传播与优化器)完成从张量构建到梯度更新的完整生命周期:
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 构造训练数据 (y = 2.5 * x + 1.2 + 随机噪声)
torch.manual_seed(42)
x_train = torch.randn(100, 1)
y_train = 2.5 * x_train + 1.2 + torch.randn(100, 1) * 0.1

# 2. 定义线性网络模型
class LinearRegressionModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.linear = nn.Linear(in_features=1, out_features=1)

    def forward(self, x):
        return self.linear(x)

model = LinearRegressionModel()

# 3. 定义损失函数与优化算法
criterion = nn.MSELoss()
optimizer = optim.SGD(model.parameters(), lr=0.05)

# 4. 迭代训练闭环
for epoch in range(100):
    model.train()
    optimizer.zero_grad()      # 清空前一步累加的梯度
    predictions = model(x_train)
    loss = criterion(predictions, y_train)
    loss.backward()            # 自动微分反向传播
    optimizer.step()           # 更新参数权重

# 5. 查看收敛后的参数拟合结果
weight = model.linear.weight.item()
bias = model.linear.bias.item()
print(f"拟合权重 Weight: {weight:.4f} (期望: 2.5000), 偏置 Bias: {bias:.4f} (期望: 1.2000)")
运行输出(示例):
拟合权重 Weight: 2.4938 (期望: 2.5000), 偏置 Bias: 1.2051 (期望: 1.2000)四、三大领域融合:端到端工业架构总结
在真实的现代软件系统构建中,这三大领域很少孤立存在。最典型的产业形态是以数据分析为模型训练提供干净的标注语料;在人工智能环境中完成模型微调与量化评估;最后借助Web开发(如FastAPI或Triton Server)将其封装为标准化对外服务,并在Web后台仪表板中实时监控调用量与延迟指标。
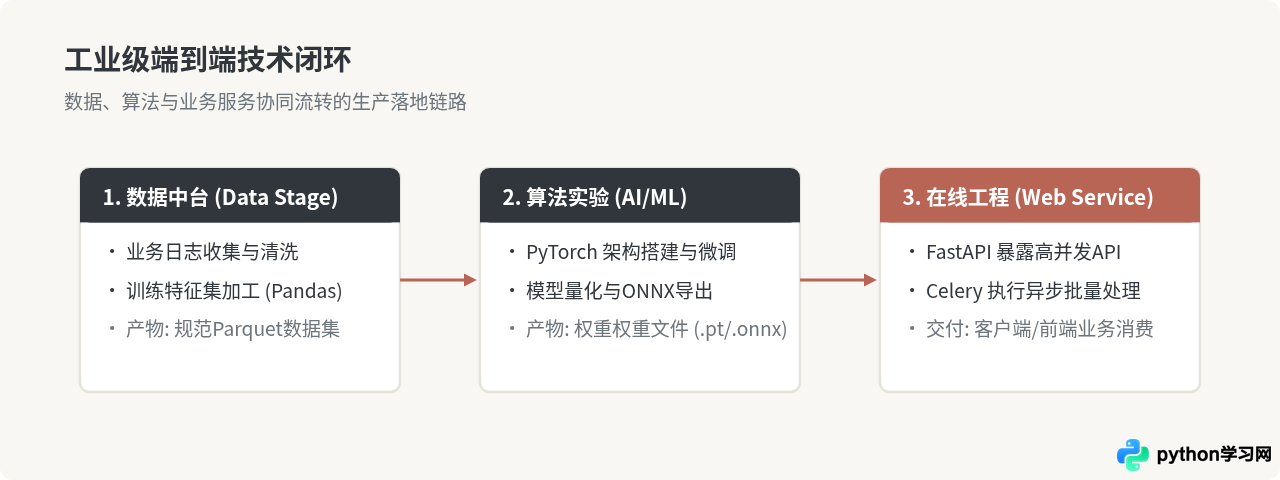
理解这三大场景的关键在于认识到 Python 3 在各个环节的角色边界:在数据密集阶段利用其简洁的表达式降低逻辑转换成本,在算力核心阶段借助其胶水特性调用底层高效运行时,在服务交互阶段以异步标准保障业务吞吐。通过结合具体场景做出合理的技术选型,才能真正发挥 Python 生态在工程实践中的效能优势。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









