

Python主要用来做什么:AI、数据分析与Web后端应用场景
一、人工智能与机器学习:算法研发与工程落地基石
在人工智能领域,Python 占据绝对主导地位。这一地位并非源于 Python 本身的运算执行速度,而是得益于其高度成熟的底层封装生态。PyTorch、TensorFlow 和 JAX 等主流深度学习框架,核心算子均采用 C++ 和 CUDA 编写,Python 在其中承担了高效模型构建、超参数调优、计算图定义和执行调度的控制角色。
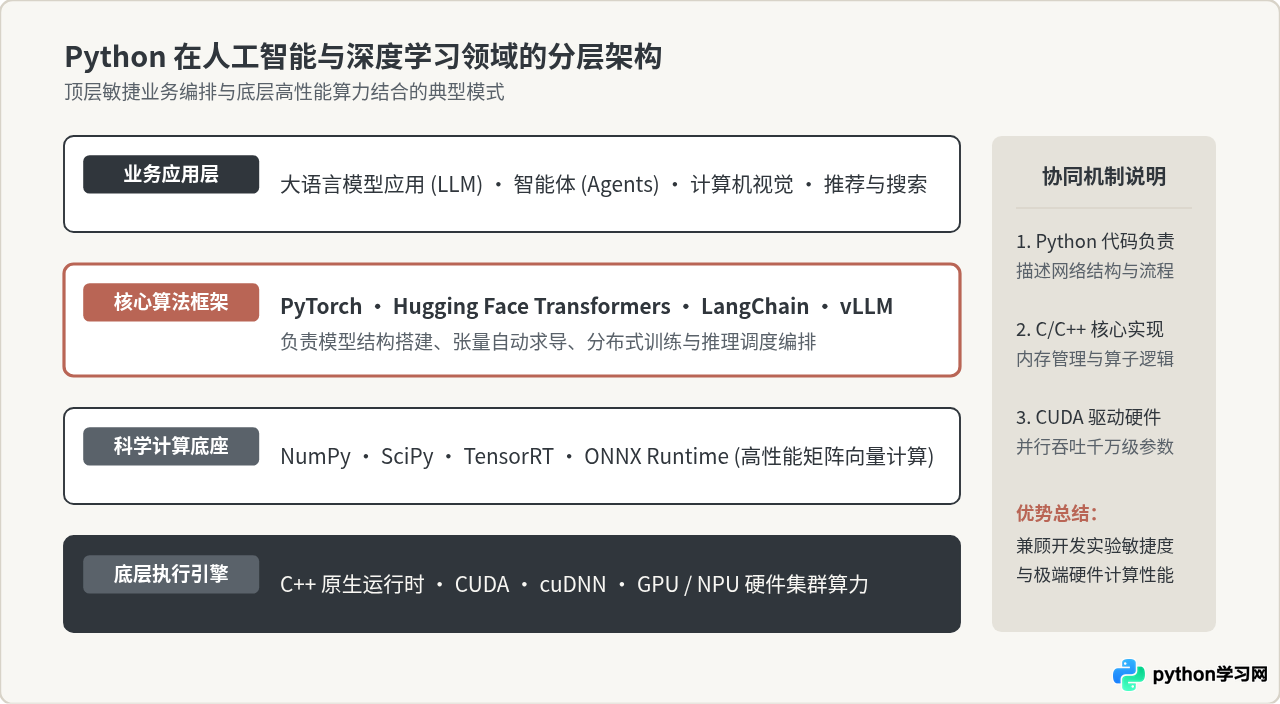
在实际生产环境中,算法工程师通常使用 Python 完成数据标注处理、模型预训练、微调(Fine-tuning)和轻量验证。例如使用 Hugging Face 库加载大语言模型并执行特定任务推理的典型代码如下:
from transformers import pipeline

# 初始化情感分析或文本分类管道
classifier = pipeline(
    task="sentiment-analysis",
    model="distilbert/distilbert-base-uncased-finetuned-sst-2-english"
)

# 输入测试语句并获取推理结果
samples = [
    "Python enables rapid prototyping with production-grade efficiency.",
    "The CPU bottleneck makes raw loops slow."
]
results = classifier(samples)

for text, res in zip(samples, results):
    print(f"Text: {text}\nResult: {res['label']} (Score: {res['score']:.4f})\n")
二、数据分析与科学计算:从原始数据到决策洞察
数据分析是 Python 最广泛落地的通用场景之一。在企业数字化运营、金融量化交易、生物信息分析等领域,分析师使用 Python 完成“数据抽取、异常清洗、聚合统计、建模挖掘、图表可视化”全链路闭环。
该生态的核心支柱是 Pandas 与 NumPy。NumPy 提供了连续内存布局的高维数组操作与向量化运算;Pandas 在其上构建了面向二维表格结构的 DataFrame,能够以直观的声明式语法完成原本需要繁琐 SQL 或循环才能实现的复杂多维数据变换。
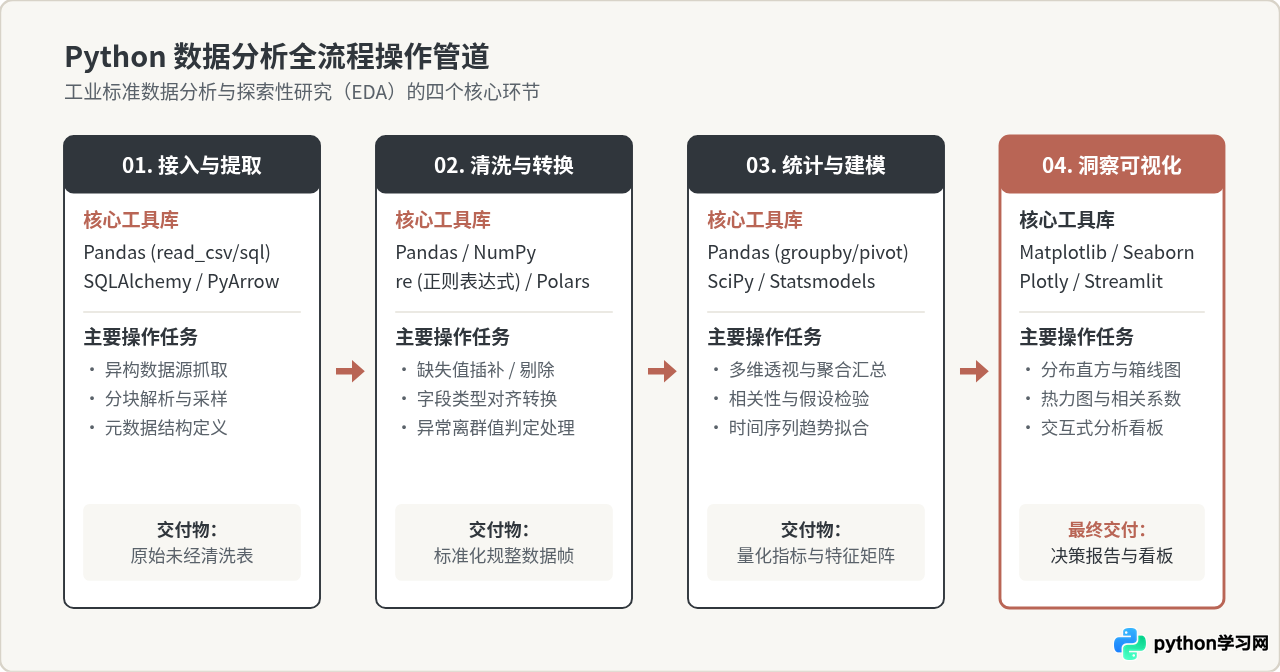
下面是一段典型的多阶段销售分析脚本示例。演示了如何加载数据、处理缺失值并按区域分类汇总客单价与总销售额:
import pandas as pd
import numpy as np

# 1. 模拟数据集构建
raw_data = {
    "region": ["East", "North", "East", "South", "North", "West", "East"],
    "sales": [1200, np.nan, 3400, 2100, 1800, np.nan, 2900],
    "orders": [12, 5, 28, 15, 14, 3, 22]
}
df = pd.DataFrame(raw_data)

# 2. 清洗阶段:使用中位数填充异常/缺失销售额
median_sales = df["sales"].median()
df["sales"] = df["sales"].fillna(median_sales)

# 3. 计算衍生指标:计算客单均价 (AOV)
df["avg_order_value"] = df["sales"] / df["orders"]

# 4. 分组聚合统计:按大区汇总指标
summary = df.groupby("region").agg(
    total_sales=("sales", "sum"),
    total_orders=("orders", "sum"),
    avg_ticket=("avg_order_value", "mean")
).reset_index()

print("区域销售汇总统计表:")
print(summary.to_string(index=False))
三、Web 后端与 API 服务开发:现代微服务与全栈系统
在 Web 开发领域,Python 并不用于浏览器端(前端)的界面渲染交互,而是专注于服务端业务逻辑、RESTful / GraphQL 接口定义、数据库持久化集成以及异步后台任务分发。
根据业务规模和性能要求,Python Web 生态形成了三大主流分工:
- FastAPI:基于类型提示(Type Hints)与 Starlette 的现代异步 ASGI 框架。自带自动生成 OpenAPI 交互文档与 Pydantic 数据验证,高并发吞吐表现优异,已成为微服务和 AI 接口开发的首选。
- Django:功能完整的“大而全”框架。内置强安全性 ORM、后台管理系统(Admin)、用户鉴权模块与表单处理,极适合快速构建中大型企业级管理后台或全功能 Web 应用。
- Flask:轻量级 WSGI 微框架。只提供核心路由与请求上下文,其他扩展组件自由组合,适合小巧的原型验证或极简服务。
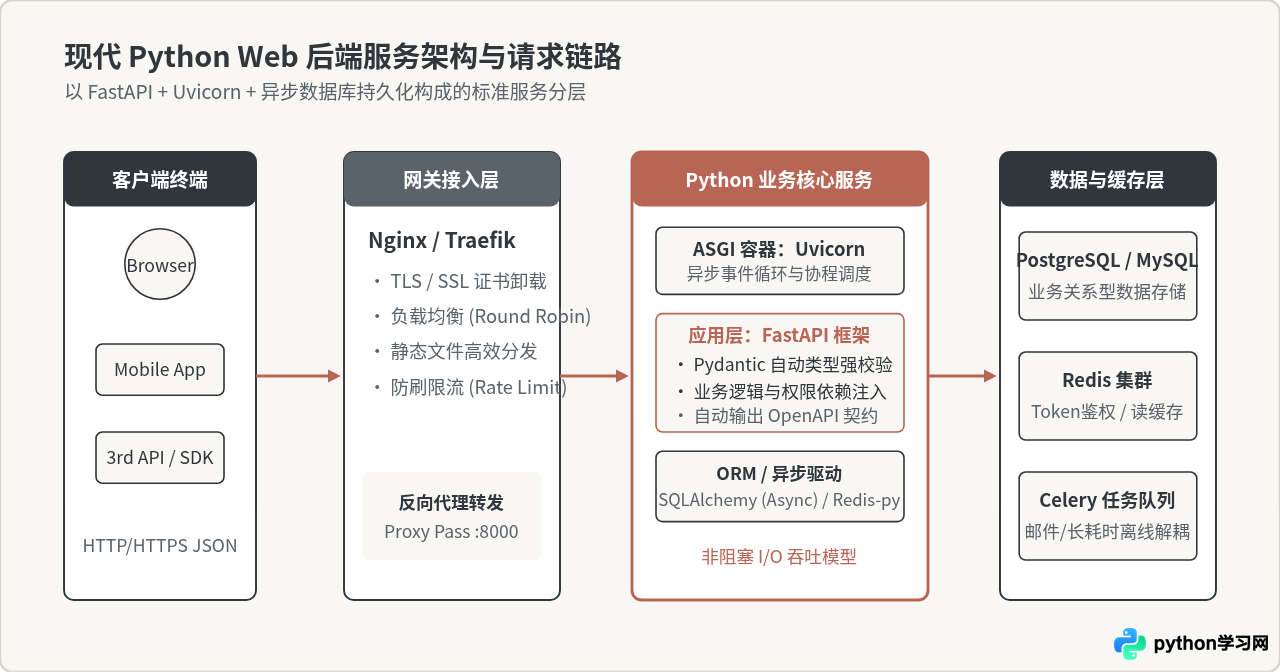
以常见的商品库存查询接口为例,FastAPI 能够以极简的代码定义带有严格入参校验和异步非阻塞查询的 API 服务:
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field

app = FastAPI(title="Inventory Service", version="1.0.0")

class ItemQuery(BaseModel):
    item_id: int = Field(gt=0, description="商品唯一ID,必须为正整数")
    currency: str = Field(default="CNY", max_length=3)

class ItemResponse(BaseModel):
    item_id: int
    stock: int
    price: float
    currency: str

# 模拟异步数据库查询
@app.post("/api/v1/item/check", response_model=ItemResponse)
async def check_item_stock(payload: ItemQuery):
    if payload.item_id > 10000:
        raise HTTPException(
            status_code=status.HTTP_404_NOT_FOUND,
            detail="Specified item does not exist"
        )

    # 模拟从数据库或缓存中异步读取
    return ItemResponse(
        item_id=payload.item_id,
        stock=42,
        price=199.50,
        currency=payload.currency.upper()
    )
四、核心局限与选型反思:Python 不适合用来做什么
理性的技术选型不仅需要了解工具的优势,同样需要清晰认识其不可逾越的边界。在以下场景中,Python 通常不是最佳选择:
- CPU 密集型纯算法计算:Python 的动态解释机制和原生 GIL(全局解释器锁)使得纯 Python 代码无法有效利用多核 CPU 进行并行数值计算。如果业务不涉及现成的 C/Fortran 底层库加速(如纯手工遍历大数组),其性能相比 Go、C++ 或 Rust 会有 10 到 100 倍的差距。
- 移动端原生开发(iOS / Android):尽管有 Kivy、BeeWare 等尝试,但移动应用开发的主流依然是 Swift/SwiftUI、Kotlin 以及 Flutter/React Native。Python 无法产出符合现代移动应用生态体积与启动速度要求的二进制包。
- 高实时与系统级嵌入式软件:Python 的垃圾回收(GC)机制会产生非受控的 STW(Stop-The-World)暂停,无法满足工业自动化控制、汽车电子和操作系统内核级别的硬实时(Hard Real-Time)要求。
五、三大场景综合选型与能力对照
为了在项目启动时做出客观决策,下表总结了 Python 在三大核心场景中的生态定位、关键工具链与选型判定准则:
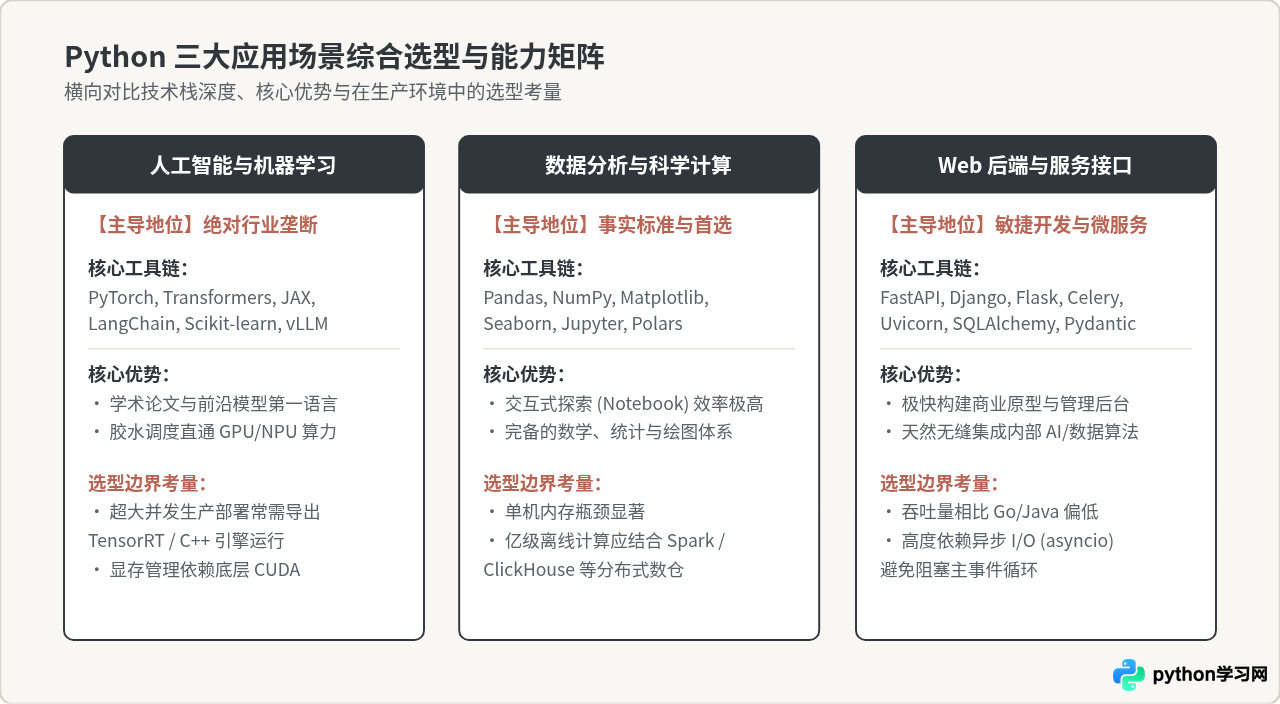
| 应用场景 | 主力框架 / 核心库 | 典型业务需求 | 主要优势 | 限制与替代方案 |
|---|---|---|---|---|
| 人工智能与大模型 | PyTorch, Hugging Face, LangChain, vLLM | 大语言模型应用、模型微调、智能体构建、CV/NLP | 学术界事实标准,生态庞大,底层硬件加速生态完善 | 超高并发纯推理时需转换为 TensorRT/C++ 部署 |
| 数据分析与统计 | Pandas, NumPy, Matplotlib, Seaborn | 商业 BI 指标计算、探索性分析 (EDA)、特征清洗 | 表格处理表达力极强,Jupyter 交互式体验极佳 | 单机内存易溢出;超大数据需结合 Polars 或 Spark |
| Web 后端开发 | FastAPI, Django, Flask, SQLAlchemy | 企业内部系统、RESTful API、微服务网关、数据中台 | 开发效率极高,类型安全校验完备,与 AI 资产直接打通 | 高密集并发吞吐逊于 Go/Java,受限于 GIL 与解释开销 |
六、结论
Python 的核心竞争力并不在于单纯的语言执行性能,而在于其无与伦比的生态黏合力与极高的工程开发效率。在人工智能与数据分析领域,Python 是毫无争议的基石语言;而在 Web 后端领域,Python 是快速交付高质量 API 与承载算法服务的高效利器。
在实际技术选型时,认清各场景的技术边界,将 Python 用在敏捷表达、流程调度与高维矩阵运算的统一调度接口上,配合底层的专用加速技术,才能充分发挥其最大价值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









