

Python列表与集合的核心区别:有序性、唯一性与底层实现
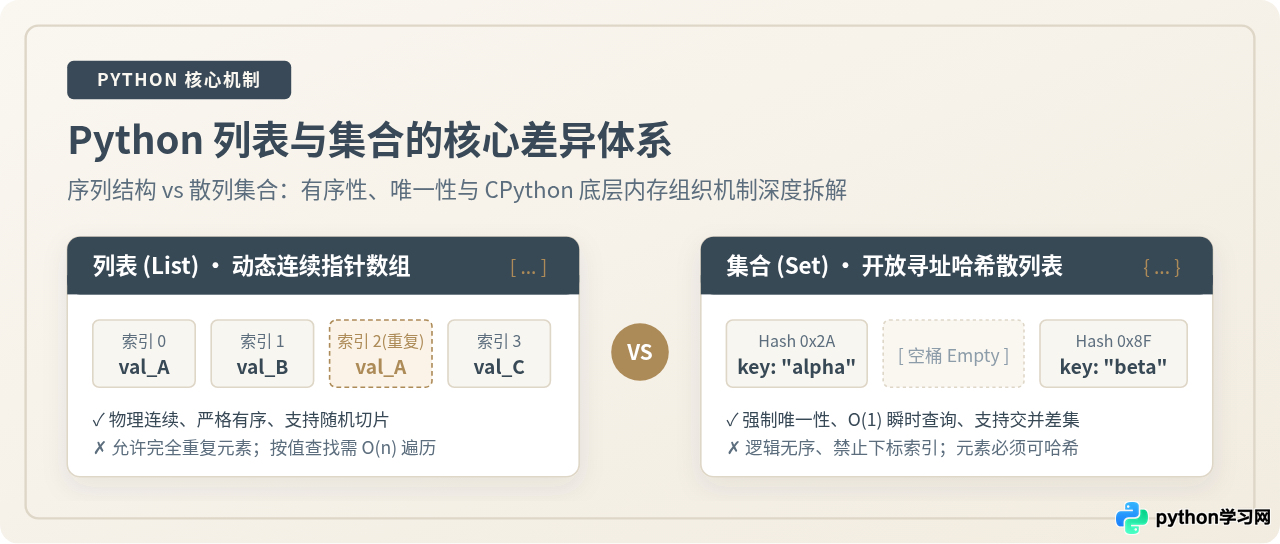
深入解析Python中列表(list)与集合(set)的核心差异,从有序性、唯一性与元素可哈希约束入手,剖析CPython底层动态数组与开放寻址哈希表的实现机制及性能权衡。
list)与集合(set)是最常用的两种内置集合类型。它们的核心分歧体现在三个维度:列表是基于物理内存连续分配的有序序列,严格按插入次序存储,允许存在重复元素,支持下标随机访问;集合则是基于散列查找的无序数学集合,内部强制元素唯一且必须可哈希,不支持下标与切片。从底层架构来看,列表由CPython的动态指针数组(PyListObject)驱动,按值查找耗时呈 $O(n)$ 线性增长;而集合依托开放寻址哈希表(PySetObject),通过空间冗余换取平均 $O(1)$ 的瞬时查找能力。
一、有序性与访问方式的本质差异
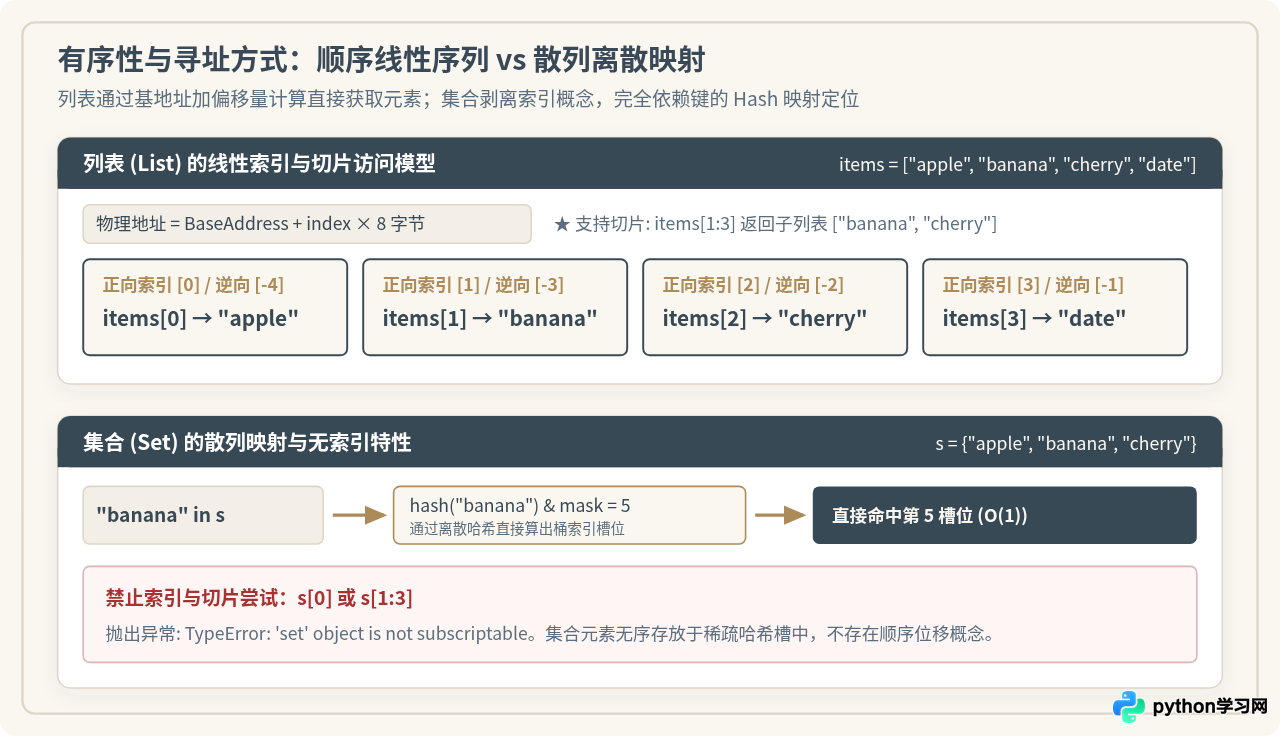
在Python中,“有序”具有明确的数据结构含义:容器是否保证元素位置与插入顺序严格对齐,并提供基于自然数索引的随机寻址接口。
列表属于序列(Sequence)协议的典型实现。每个元素在列表中都有一个固定的非负整数下标(从 0 到 len(list)-1)以及对应的负数下标。由于底层内存按槽位连续排列,Python可以通过基地址与索引偏移直接计算出目标内存地址,实现 $O(1)$ 时间复杂度的正反向索引访问与范围切片。
相比之下,集合是数学概念中集合的编程映射。虽然在 Python 3.7+ 的标准CPython实现中,集合由于底层键值存储细节表现出特定的遍历顺序,但在语法规范与抽象逻辑上,集合始终被定义为无序容器。集合内部并不分配“第0个”、“第1个”这样的序号,因此禁止任何索引或切片操作。
# 列表支持索引访问与多步长切片
languages = ["Python", "Rust", "Go", "C++"]
print(languages[0])       # 获取第一个元素
print(languages[1:3])     # 切片获取区间子列表

# 集合尝试下标索引
lang_set = set(languages)
try:
    print(lang_set[0])
except TypeError as e:
print("捕捉到异常:", e)['Rust', 'Go']
捕捉到异常: 'set' object is not subscriptable
如运行结果所示,对集合执行 lang_set[0] 会直接触发 TypeError: 'set' object is not subscriptable 报错。如果业务流程中需要通过位置提取第 $k$ 个元素或依赖严格的前后次序,列表是唯一合法的选择。
二、唯一性与元素可哈希协议约束
唯一性是区分列表与集合的第二道分水岭。列表是包容性容器,同一个对象可以在不同索引位置出现任意多次;集合则严格捍卫元素的互异性,任何重复项在加入时都会被静默丢弃。
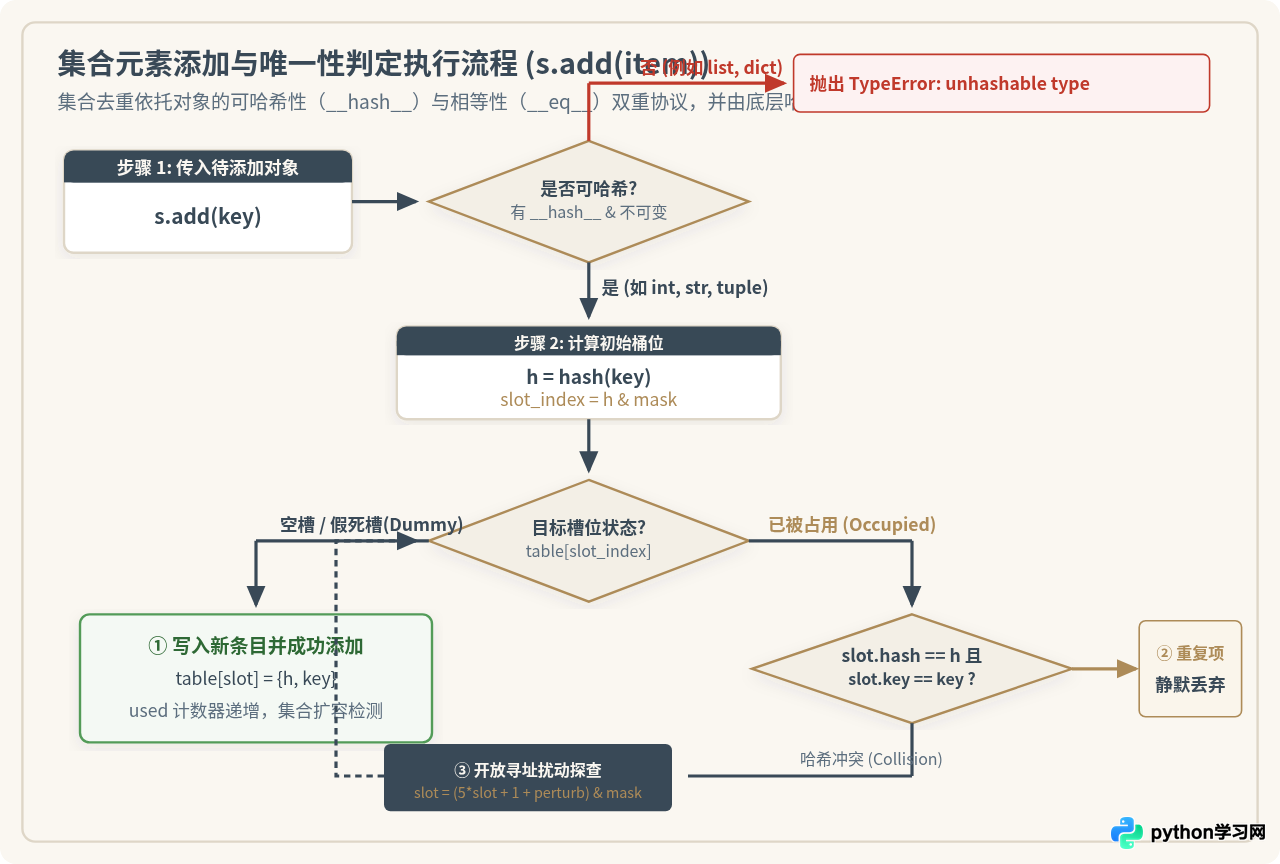
集合实现自动去重的关键在于可哈希协议(Hashable Protocol)。向集合存入一个对象时,该对象必须满足两个基本条件:
- 在对象的生命周期内,其哈希值(由
__hash__()魔术方法计算)保持不变; - 对象必须能够与其他对象比较是否相等(实现了
__eq__()方法)。
Python中的数值、字符串、布尔值、元组(其内部子项也必须均可哈希)以及 frozenset 均属不可变对象,原生支持哈希;而列表(list)、字典(dict)和集合(set)本身是可变对象,其内部内容允许动态修改,因此没有 __hash__ 方法(即 __hash__ = None)。
# 1. 列表允许重复元素,按需追加
nums_list = [10, 20, 10, 30, 20]
print("列表长度:", len(nums_list))

# 2. 集合自动过滤重复项
nums_set = set(nums_list)
print("集合内容:", nums_set)
print("集合长度:", len(nums_set))

# 3. 集合对不可哈希元素的限制
try:
    invalid_set = ([1, 2], [3, 4])  # 元素为可变列表
except TypeError as e:
print("非法元素异常:", e)集合内容: (10, 20, 30)
集合长度: 3
非法元素异常: unhashable type: 'list'
去重判定的具体执行链条非常精密:当执行 s.add(x) 时,底层并非简单地全表扫描比较对象,而是先计算 hash(x),定位到指定槽位。如果槽位上已有元素 existing,解释器会首先比对 hash(existing) == hash(x);若哈希值吻合,再调用 existing == x 进行深度等值判定。只有当两者哈希相等且值相等时,才认定为重复元素并不予写入。若哈希冲突但值不同,则通过二次扰动探查寻找下一个候选槽位。
三、底层实现与时间复杂度剖析
表面行为的差异完全源自 CPython 解释器底层的 C 语言结构体设计。理解底层的内存模型,是预测其性能表现与合理选型的关键。
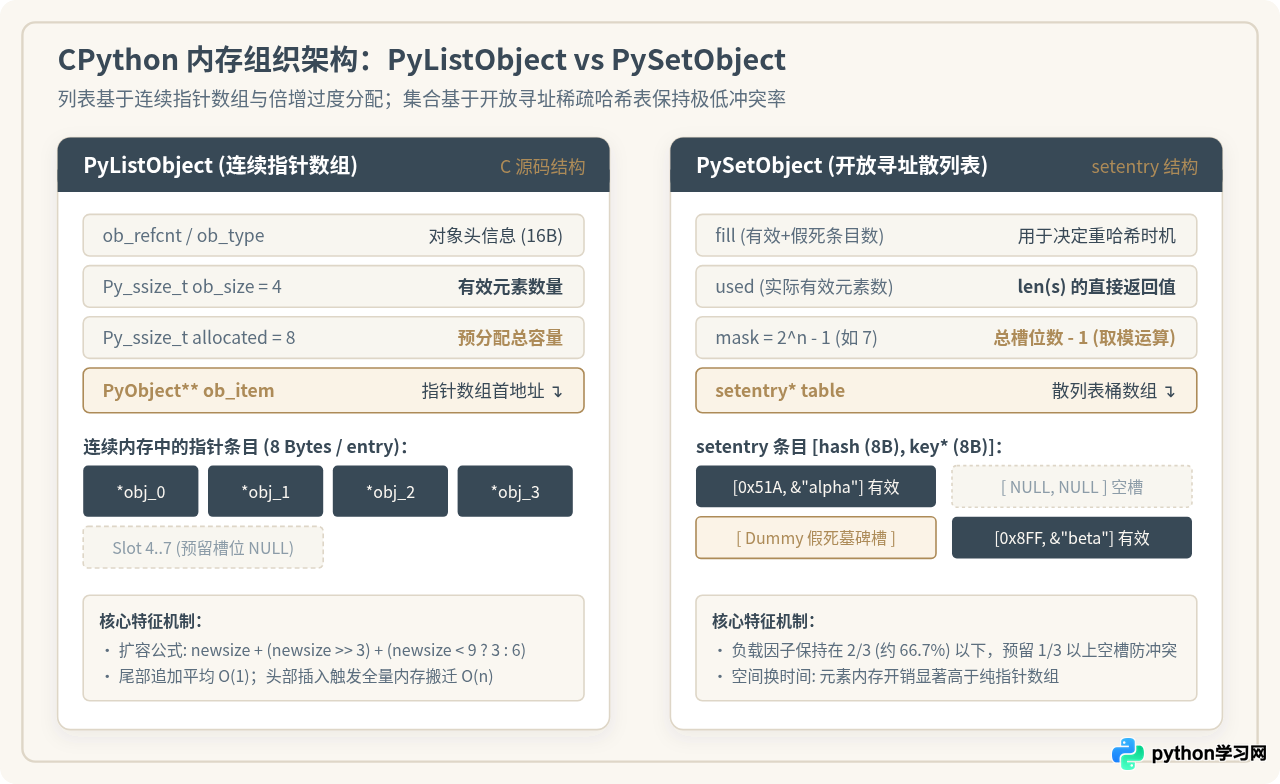
1. 列表底层:连续指针数组(PyListObject)
在 CPython 源码中,列表对应 PyListObject 结构体。该结构体包含三大核心要素:对象头部、有效长度 ob_size、分配容量 allocated 以及指向连续指针数组的二级指针 ob_item。
- 内存布局:
ob_item在内存中是一段紧凑平铺的数组,存储的是指向各个 Python 对象的指针(在64位机器上每个指针占8字节)。 - 过度分配机制(Over-allocation):为了避免每次调用
append()时都向操作系统申请内存并重新拷贝数组,Python 采用了倍增扩容策略。当前容量耗尽时,解释器会按照公式new_allocated = (newsize >> 3) + (newsize < 9 ? 3 : 6) + newsize超额申请内存,将单次尾部追加的平摊时间复杂度控制在 $O(1)$。 - 按值查找的劣势:当执行
item in my_list时,由于列表没有任何按内容排序或散列的先验条件,解释器必须从第0个指针开始逐个取出对象,调用==进行比较,时间复杂度为严格的 $O(n)$。在包含百万量级元素的列表中,高频使用in会带来严重性能瓶颈。
2. 集合底层:开放寻址散列表(PySetObject)
集合的底层实现结构体为 PySetObject,其核心是一个由 setentry 构成的哈希槽数组(每个 entry 包含 hash 字段与 key 对象指针)。
- 哈希离散定位:集合定位元素无需逐项遍历,而是直接利用掩码运算
slot = hash(key) & mask计算桶位。在没有严重哈希冲突的情况下,只需一步即可完成寻址,查询、插入和删除的平均时间复杂度均为 $O(1)$。 - 开放寻址与假死槽(Dummy):当不同键计算出相同的槽位时,Python 不使用链地址法(拉链法),而是采用扰动开放寻址法(Perturbation Probing)在数组内部跳跃探测下一个空槽。在删除集合元素时,为了避免截断探查链路,被删除的槽位会被标记为特殊常数
dummy(墓碑标记),保证后续具有相同散列前缀的键仍能顺利被检索到。 - 空间换时间的代价:为了保持低冲突率,集合将负载因子严格限制在约 66.7% 以下(即表内有效条目加 Dummy 槽超过容量的三分之二时立即触发扩容重哈希)。因此,集合内部总有三分之一以上的槽位处于闲置状态,再加上每个槽位额外记录哈希值,其单位元素的内存开销往往是列表的 3 到 5 倍。
四、关键操作耗时与工程选型决策
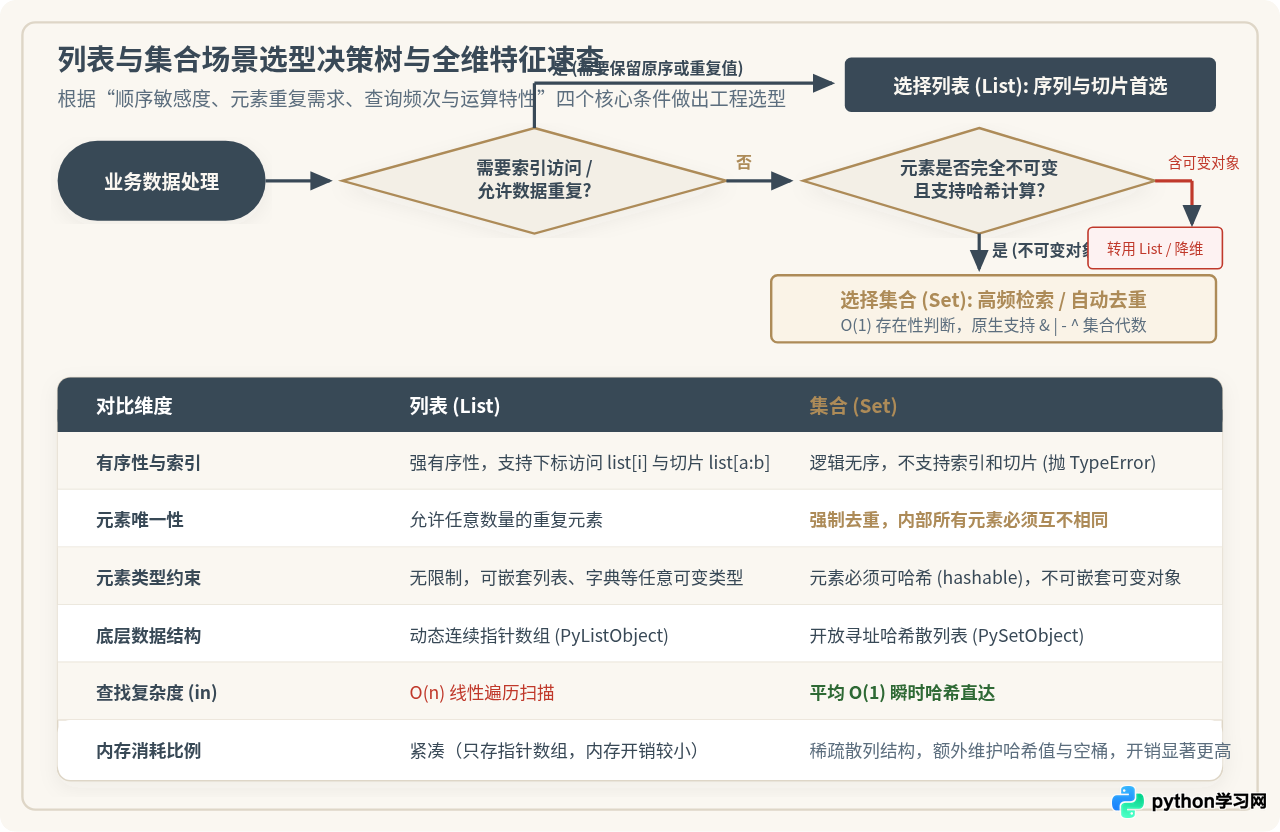
在工程实践中,列表与集合并非替代关系,而是互补的两种基础构件。选择哪种结构取决于核心操作的频次侧重。
| 操作类型 | 列表 (List) 复杂度 | 集合 (Set) 复杂度 | 机制解释与工程注意事项 |
|---|---|---|---|
按索引读取 c[i] |
O(1) | 不支持 (TypeError) | 列表通过内存偏移直接寻址;集合无顺序与索引 |
尾部添加 append / add |
O(1) 平摊 | O(1) 平摊 | 列表追加触发倍增扩容;集合添加触发槽位探查与重哈希 |
头部插入 insert(0, val) |
O(n) | O(1) 平均 | 列表需将后续所有指针后移一个位置;集合无位置概念,直接散列入槽 |
成员检测 x in c |
O(n) | O(1) 平均 | 数据量达到10万以上时,集合检索速度可比列表快数百至数千倍 |
删除指定值 remove(x) |
O(n) | O(1) 平均 | 列表需先查找到元素再移动后续元素;集合定位后直接标记 Dummy |
| 数学运算 (交集/并集/差集) | 需手动嵌套循环 O(n*m) | 原生支持 & | - ^ | 集合原生使用哈希表求交并差,性能呈线性 O(len(s1) + len(s2)) |
1. 如果需要保持固定的流水顺序(例如事件时序日志、FIFO批处理队列),或需要使用切片提取窗口数据,请选用 列表(List)。若需要极高效的头部弹出,可配合标准库
collections.deque。
2. 如果核心诉求是过滤白名单/黑名单、高频判断某个 ID 是否存在、或者从大规模数据中剔除重复项,请毫不犹豫地使用 集合(Set)。
3. 集合去重虽快,但会丢失原始顺序。如果既需要元素唯一,又必须严格保留输入顺序,在 Python 3.7+ 中推荐直接使用字典的键去重:
list(dict.fromkeys(raw_data)),既能享受哈希的高性能,又能锁定元素首次出现的次序。
五、总结
列表与集合的本质差异可以概括为三种取舍:
在有序性上,列表用连续存储锁定了元素的位置和先后顺序,赋予了基于整数下标的随机访问特权;集合则抛弃了顺序负担,专心提供纯粹的成员归属关系。在唯一性上,列表作为通用容器无条件保留所有记录,而集合建立在可哈希协议之上,借助等值比对天然防重。在底层实现上,列表是紧凑高效的连续指针数组,擅长按序遍历与末端操作;集合是稀疏但迅速的开放寻址哈希表,通过更多的内存冗余换取了常数级别的极速检索与代数集合运算能力。
在实际编码中,明确区分“需要顺序保真还是成员快速排查”,即可在二者之间做出最清晰、最高效的技术抉择。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









