

Python能做什么:Web开发、数据分析与人工智能等核心应用场景

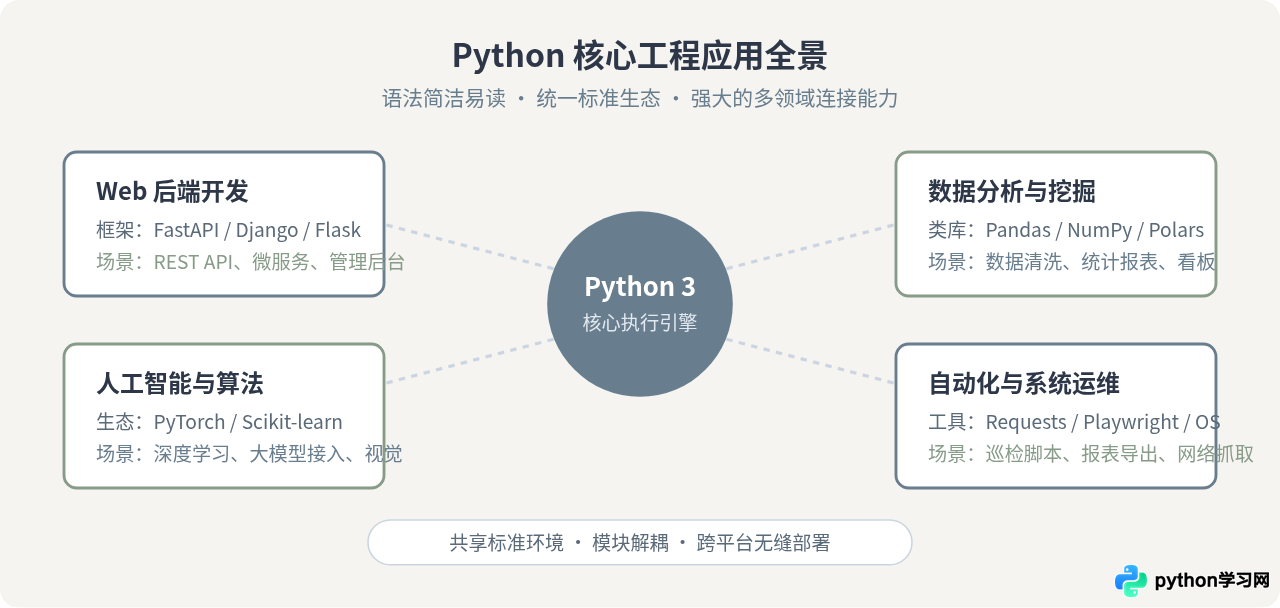
Python 是一门通用型的高级解释语言,其核心价值在于语法直观、表达能力强,以及拥有由数以万计高质量开源库构成的完整工程生态。对于初学者或评估技术栈的开发者而言,Python 最核心的落地领域主要集中在四个方向:构建后台接口与网站服务的 Web开发、执行数据清洗与商业挖掘的 数据分析、支撑算法研究与模型工程的 人工智能与机器学习,以及日常系统维护与重复劳动作业的 自动化脚本。本文将具体梳理这些核心场景中的工作方式、典型工具栈、实操代码与选型边界。
一、Web开发:构建高效稳定的后台接口与业务系统
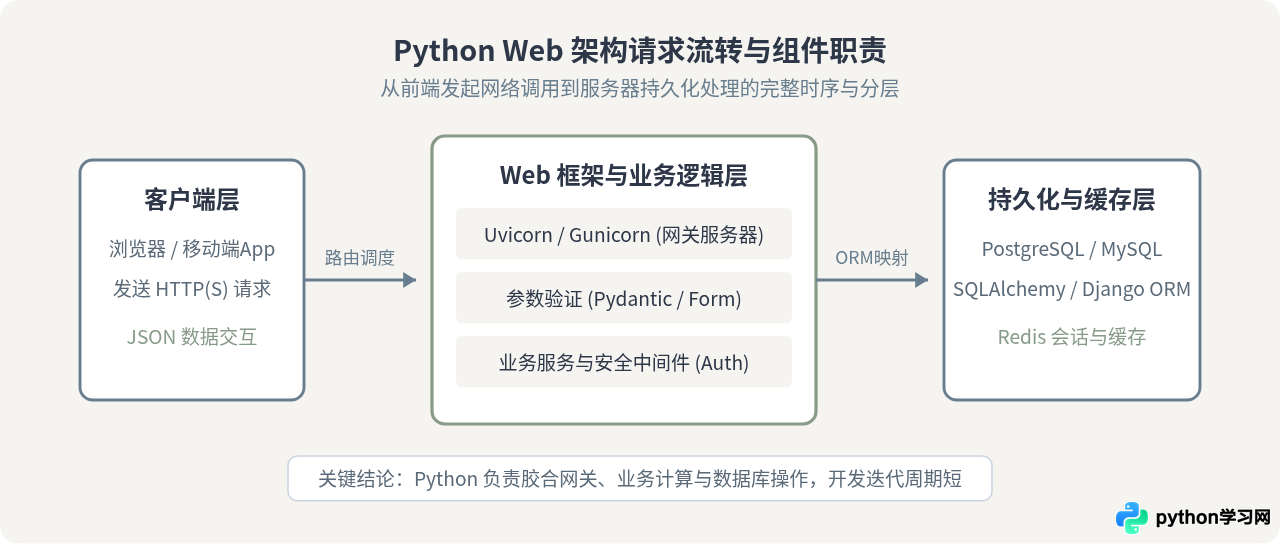
在网络应用领域,Python 主要运行在服务器后端,承担解析客户端 HTTP 请求、执行业务逻辑、读写数据库以及输出 JSON 数据或 HTML 页面的任务。现代 Python Web 开发已形成清晰的技术梯队:全栈型框架以 Django 为代表,轻量与现代化异步框架则以 FastAPI 和 Flask 为代表。
1. 轻量异步 API 与企业级全栈的路线差异
开发者在进入 Web 领域时常面临选型分歧,理解以下两者的工作方式差异至关重要:
- FastAPI(现代化异步微服务):基于 Python 原生类型注解(Type Hints)与 ASGI 异步规范构建。它通过 Pydantic 自动完成请求参数校验、数据序列化并即时生成 OpenAPI(Swagger)交互式文档。对于需要高并发处理 I/O 阻塞(如高频数据库读写、调用第三方外部 API)的微服务场景,异步运行机制能显著减少等待线程消耗。
- Django(全功能一站式后台):遵循“电池已备齐(Batteries Included)”设计哲学。开箱即带强大的对象关系映射(ORM)、原生用户认证系统、表单校验机制以及开箱即用的后台管理界面(Admin)。适合业务模型复杂、需要快速搭建完整中后台管理系统的企业团队。
2. 编写轻量 RESTful API 示例
以下示例展示使用 FastAPI 声明一个商品信息查询与创建端点,代码中包含明确的数据验证模型与返回结构:
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field
from typing import Optional

app = FastAPI(title="商品管理服务示例")

# 定义输入数据校验规范
class ItemSchema(BaseModel):
    name: str = Field(..., min_length=1, description="商品名称")
    price: float = Field(..., gt=0, description="单价,必须大于0")
    in_stock: bool = Field(default=True, description="库存状态")
    description: Optional[str] = Field(None, max_length=200)

# 内存模拟持久化数据
db_items = {
    1: {"name": "无线机械键盘", "price": 399.0, "in_stock": True, "description": "87键蓝牙双模"}
}

@app.get("/api/items/{item_id}")
async def get_item(item_id: int):
    if item_id not in db_items:
        raise HTTPException(status_code=404, detail="指定商品不存在")
    return {"status": "success", "data": db_items[item_id]}

@app.post("/api/items", status_code=201)
async def create_item(item: ItemSchema):
    new_id = max(db_items.keys(), default=0) + 1
    db_items[new_id] = item.model_dump()
    return {"status": "created", "item_id": new_id, "data": db_items[new_id]}
运行该程序时,在终端执行命令:uvicorn main:app --reload --port 8000。访问 http://127.0.0.1:8000/docs 即可直接获得可交互的在线接口调试页面,无需手写接口文档。
二、数据分析:从海量杂乱数据到结构化商业洞察
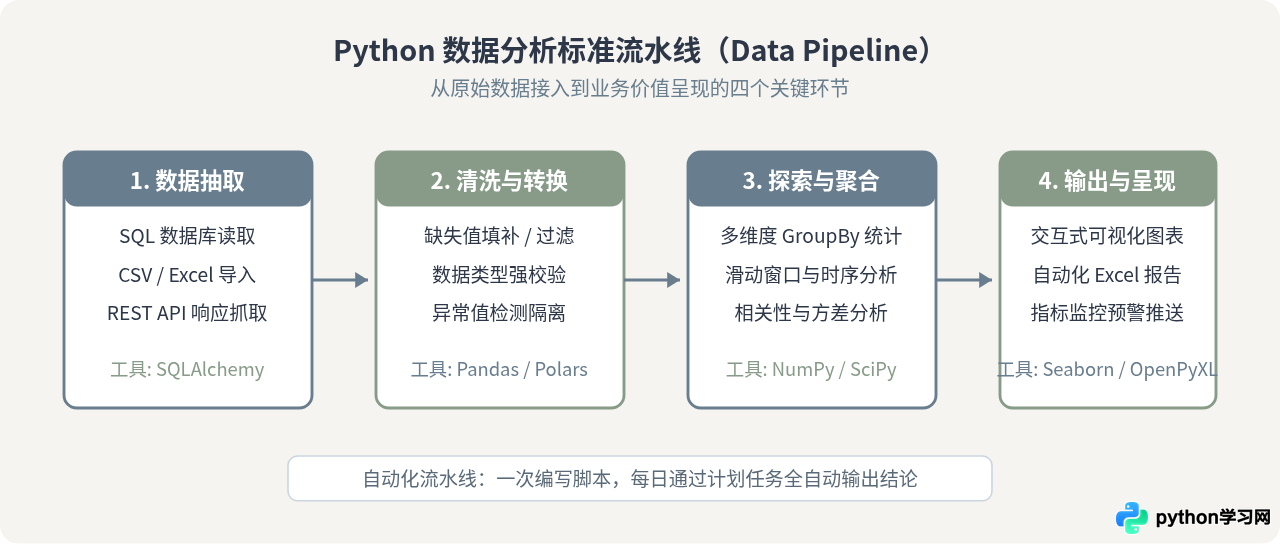
在数据处理领域,Python 已成为工业界的通用事实标准。真实业务环境中的原始数据往往存在格式不一、字段缺失、异常输入等问题,无法直接用于决策支持。Python 通过 NumPy(底层 C 优化的多维数组运算)、Pandas(强大的带标签表格化数据结构 DataFrame)以及 Matplotlib / Seaborn(图表绘制与可视化),提供了高度连贯的端到端解决方案。
1. 为什么用 Pandas 代替传统电子表格工具
对于百行到几千行的数据,传统桌面电子表格工具直观便利;然而一旦数据量进入几十万行甚至更大级别,或者数据清洗逻辑需要每天随批处理定时执行时,两者的差异尤为鲜明:
- 逻辑可追溯与可复现:电子表格中的手工点选、单元格拖拽计算极易因为人为失误导致公式错位,且难以进行版本管理;Python 脚本则是纯文本代码,清洗流程严格可追溯,纳入 Git 管理后可长期安全演进。
- 无缝衔接上下游系统:Pandas 具备直接读取数据库(SQL 查询)、CSV 文件、JSON 接口与 Parquet 大数据格式的能力,清洗完毕后可立即写回数仓或触发报警邮件,无需人工中转导出。
2. 典型数据清洗与统计分析代码示例
下述代码演示处理一批销售订单记录:排查缺失值、剔除异常单价、按部门聚合汇总总销售额与平均订单金额:
import pandas as pd
import numpy as np

# 1. 模拟导入杂乱业务数据
raw_data = {
    "order_id": ["A101", "A102", "A103", "A104", "A105", "A106"],
    "department": ["华东区", "华北区", "华东区", np.nan, "华南区", "华北区"],
    "amount": [1280.0, -50.0, 3420.0, 890.0, 2150.0, np.nan],
    "quantity": [2, 1, 5, 1, 3, 2]
}

df = pd.DataFrame(raw_data)

# 2. 数据清洗阶段:处理异常与缺失
# 剔除部门为空的无效记录
df_clean = df.dropna(subset=["department"]).copy()
# 填充金额缺失为部门中位数或均值,此处剔除异常负数并过滤有效金额
df_clean = df_clean[df_clean["amount"] > 0]

# 3. 计算单品平均单价 (业务字段派生)
df_clean["unit_price"] = (df_clean["amount"] / df_clean["quantity"]).round(2)

# 4. 分组聚合统计各部门经营指标
summary = df_clean.groupby("department").agg(
    total_revenue=("amount", "sum"),
    order_count=("order_id", "count"),
    avg_order_value=("amount", "mean")
).reset_index()

print("清洗与汇总结果:")
print(summary.to_string(index=False))
department total_revenue order_count avg_order_value
华东区 4700.0 2 2350.0
华南区 2150.0 1 2150.0
三、人工智能与机器学习:算法研发到模型部署的胶水枢纽
提及现代人工智能与大语言模型,Python 处于毫无争议的生态核心地位。需要澄清的一个普遍误解是:“Python 运行速度慢,怎么可能承载计算量极其庞大的深度学习模型训练?”
1. Python 作为“顶层控制台”的运行本质
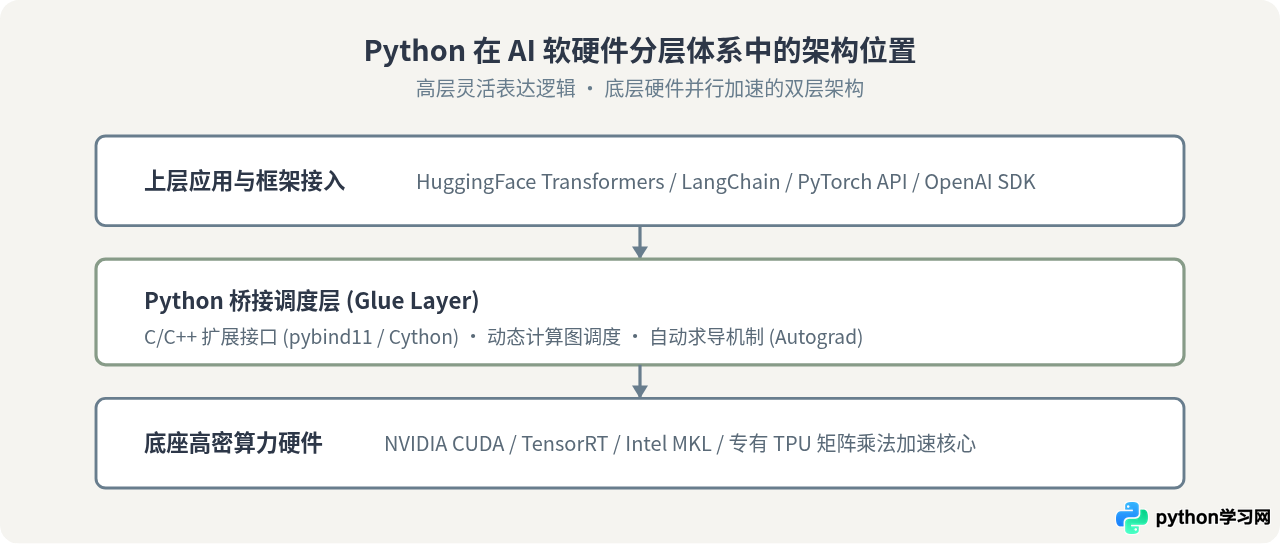
深度学习的算力瓶颈在于高维张量的矩阵乘法与微分求解。这部分运算实际上是由底层高度优化的 C/C++ 代码以及 NVIDIA CUDA、cuDNN 动态库直接在 GPU 硬件显存中执行的。Python 在其中的角色是 高阶调度与逻辑控制中心:
- 研究人员与工程师使用直观优雅的 Python 代码定义网络层、损失函数和学习率调度器。
- PyTorch 或 TensorFlow 在底层将这些指令编译为计算图,并直接交付 GPU 硬件集群进行原生矩阵运算。
- 这种模式兼顾了编写代码时的极高开发效率与运行计算时的硬件极致吞吐。
2. 机器学习预测模型示例(Scikit-learn)
以下示例使用业界标准的 scikit-learn 库构建一个经典的分类预测模型。代码涵盖数据集划分、标准化处理、模型训练与准确率评估的完整闭环:
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, classification_report

# 1. 载入标准样本数据
data = load_iris()
X, y = data.data, data.target

# 2. 划分训练集与测试集(80% 训练,20% 验证)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 3. 特征标准化处理(消除各维度量纲差异)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 4. 初始化并训练随机森林分类器
model = RandomForestClassifier(n_estimators=100, random_state=42)
model.fit(X_train_scaled, y_train)

# 5. 模型推理预测与效果评估
predictions = model.predict(X_test_scaled)
acc = accuracy_score(y_test, predictions)

print(f"测试集预测准确率: {acc * 100:.2f}%")
print("各类别评估报告:")
print(classification_report(y_test, predictions, target_names=data.target_names))
四、自动化脚本与系统运维:日常降本增效的实践方案
除了庞大的专业系统外,Python 在中小型自动化任务中应用极为普遍。由于 Python 自带丰富的标准库(如 pathlib、os、subprocess、json、csv、datetime),许多日常重复性劳动可以在数十行代码内实现全自动运行:
- 系统与服务巡检:定时轮询生产环境核心 API 的响应耗时与 HTTP 状态码,一旦发现异常立即调用企业微信或钉钉 Webhook 告警。
- 办公文件批量处理:对上千个格式不规范的 PDF、Word 或 Excel 报表执行统一重命名、字段抽取、合并与归档。
- 网络数据定向采集:使用
httpx、BeautifulSoup或无头浏览器Playwright定期爬取竞品公开报价或行业公开资讯。
以下为一个简洁可靠的服务器端口健康巡检脚本:
import socket
import sys

def check_service_health(host: str, port: int, timeout_sec: float = 3.0) -> bool:
    """验证目标服务器指定网络端口的连通性"""
    with socket.socket(socket.AF_INET, socket.SOCK_STREAM) as sock:
        sock.settimeout(timeout_sec)
        try:
            result = sock.connect_ex((host, port))
            return result == 0
        except socket.error as err:
            return False

# 待检测的基础服务列表
target_services = [
    {"name": "主数据库服务", "host": "127.0.0.1", "port": 5432},
    {"name": "缓存集群", "host": "127.0.0.1", "port": 6379},
    {"name": "Web 应用网关", "host": "127.0.0.1", "port": 8000}
]

for s in target_services:
    is_ok = check_service_health(s["host"], s["port"])
    status_label = "正常在线" if is_ok else "连接失败"
    print(f"[{s['name']}] {s['host']}:{s['port']} -> {status_label}")
五、技术选型与适用边界:什么时候该选Python,什么时候不该选
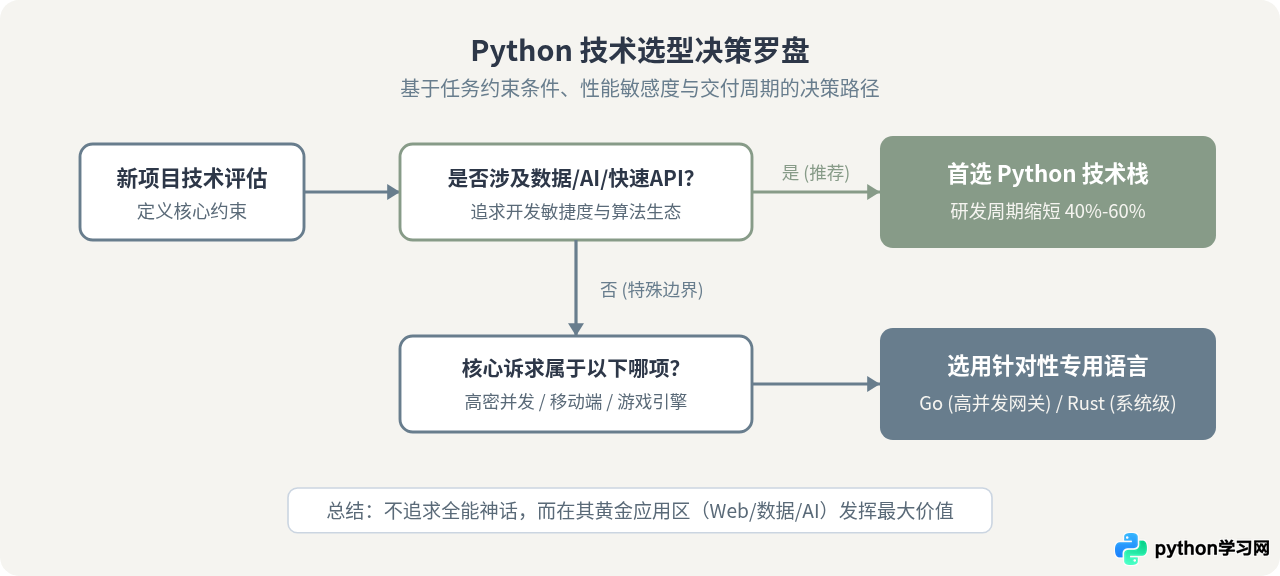
了解一门语言能做什么,同样必须清醒认识到它不能做什么,或者在哪些场景下属于次优解。技术决策的核心在于权衡:开发者的工时成本 与 计算机硬件的执行吞吐。
| 应用场景与目标 | Python 的匹配度 | 核心优势与适用原因 | 潜在限制与更佳替代方案 |
|---|---|---|---|
| 业务后端 API 与敏捷微服务 | 极高 | FastAPI 语法现代,研发迭代速度快,生态健全 | 若追求千万级 QPS 且极致压榨单机内存,Go / Rust 资源占用更低 |
| 商业数据探索、清洗与离线报表 | 绝对主流 | Pandas / NumPy 事实标准,各类库无缝协同 | 超单机内存的千亿级实时流计算需配合 ClickHouse / Spark |
| AI 模型研究、训练实验与推理服务 | 行业基石 | PyTorch、HuggingFace 深度绑定,新论文算法首发 | 端侧低功耗嵌入式部署常转为 C++ / ONNX Runtime 执行 |
| 大型 3D 游戏客户端 / 物理引擎 | 较低 | 不适合高频内存分配与纳秒级实时渲染循环 | C++ / C#(Unreal、Unity)占据主导地位 |
| 移动端原生应用(iOS / Android) | 较低 | 打包体积大、运行时复杂、平台生态契合度差 | 优先选择 Swift / Kotlin 或 Flutter / React Native |
六、实践建议与常见误区
对于准备将 Python 落地到实际工作或个人项目中的开发者,以下建议有助于规避常见工程陷阱:
- 必须使用虚拟环境隔离依赖:切勿直接在操作系统全局环境执行
pip install。请养成在项目初始即运行python -m venv .venv的习惯,使用uv或poetry进行确定性依赖版本锁定,避免依赖版本冲突导致的运行时崩溃。 - 重视现代静态类型提示(Type Hints):Python 3.9+ 提供了极其健全的类型注解支持(如
def calculate_tax(amount: float, rate: float = 0.05) -> float:)。配合 VS Code、PyCharm 或mypy静态检查工具,可以在代码运行前拦截 70% 以上的拼写与数据类型传递错误。 - 避免盲目滥用全局多线程解决 CPU 密集型任务:由于 CPython 解释器中全局解释器锁(GIL)的存在,计算密集型任务通过多线程无法有效利用多核 CPU。处理密集计算时应优先选择
multiprocessing多进程模块、底层的 C/C++ 向量化库(如 NumPy),或使用异步 I/O 处理并发网络请求。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









