

Web后端、数据分析与AI:不同方向Python开发者的技术栈差异

一、核心定位与链路全貌
很多刚接触Python的开发者常误以为掌握了基本语法、列表推导式和面向对象即可胜任各类岗位。然而在实际工业界,不同岗位的日常工作内容和使用的第三方生态几乎没有交集。一个熟练掌握Django的后端工程师面对Pandas的向量化切片可能无从下手;而擅长训练PyTorch模型的算法工程师,也未必清楚如何通过ASGI网关与连接池调优解决Web服务的Socket挂起问题。
三个方向最核心的差异在于数据在系统中的角色和流转形态:
- Web后端开发:数据是业务状态的载体,通常以结构化行记录或JSON对象形式存在。系统关注低延迟交互、数据持久化的一致性(ACID)以及并发读写下的锁机制与缓存更新。
- 数据分析与挖掘:数据是静态或半静态的分析样本,通常以多维表格(DataFrame)或列式存储加载到内存中。系统关注批处理计算效率、聚合统计精度以及探索性洞察的呈现。
- 人工智能与大模型:数据被转化为多维浮点数张量(Tensor)或高维特征向量。系统关注显存吞吐量、前向计算延迟、批量推理吞吐(Batch Throughput)以及向量相似度检索。
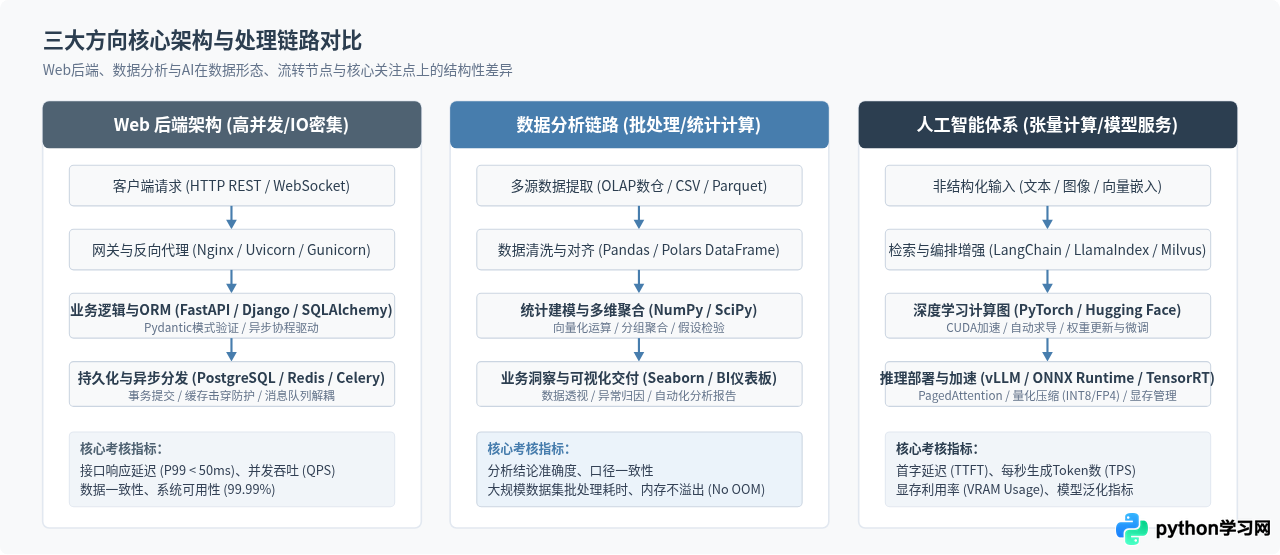
二、三大方向技术栈核心组件拆解
为了深入理解每个方向的日常开发场景,我们需要逐一剖析各自的核心库、依赖环境与典型编码范式。
1. Web后端开发技术栈
Web后端开发者主要构建对外部暴露的接口服务与内部中台。核心工作围绕网络协议解析、参数校验、数据库交互及状态同步展开。
- Web应用框架:现代项目普遍采用以类型提示(Type Hints)为核心的
FastAPI,或者传统全功能企业级框架Django。在微服务或轻量网关场景中,Flask依然占据一定份额。 - ASGI/WSGI服务器:如
Uvicorn、Gunicorn,负责将底层Socket事件解析为Python规范的HTTP/WebSocket请求对象。 - ORM与数据访问层:
SQLAlchemy 2.0、Tortoise-ORM或Django ORM。关键能力在于合理规划数据库索引、利用连接池控制连接开销,并规避ORM常见的N+1查询性能陷阱。 - 数据验证与序列化:
Pydantic是事实上的工业标准,利用Python类型注解在运行时完成严格的JSON反序列化、格式转换与异常拦截。 - 异步任务与中间件:
Celery、Redis、RabbitMQ,用于将发送邮件、生成报表、文件转码等耗时操作剥离出主HTTP请求生命周期。
# Web后端典型模式:FastAPI + Pydantic + 异步数据库查询
from fastapi import FastAPI, Depends, HTTPException, status
from pydantic import BaseModel, EmailStr
from sqlalchemy.ext.asyncio import AsyncSession
from sqlalchemy import select

app = FastAPI(title="User Service")

class UserCreate(BaseModel):
    username: str
    email: EmailStr

@app.post("/api/v1/users", status_code=status.HTTP_201_CREATED)
async def create_user(payload: UserCreate, db: AsyncSession = Depends(get_db_session)):
    query = select(UserModel).where(UserModel.email == payload.email)
    result = await db.execute(query)
    if result.scalar_one_or_none():
        raise HTTPException(status_code=400, detail="Email already registered")

    new_user = UserModel(username=payload.username, email=payload.email)
    db.add(new_user)
    await db.commit()
    await db.refresh(new_user)
    return {"id": new_user.id, "username": new_user.username}
2. 数据分析与挖掘技术栈
数据分析师与数据工程师的核心资产是数据集。他们的日常开发主要在交互式环境(如Jupyter Lab)与自动化离线调度脚本中完成。
- 核心计算引擎:
Pandas是传统分析基石,基于列式结构(Series/DataFrame)提供海量切片、关联与聚合API;近年来高性能列式计算库Polars凭借多线程Rust核心和低内存开销迅速普及。 - 底层数值计算:
NumPy提供高性能多维数组(ndarray)及广播机制,是整个科学计算生态的内存与计算协议标准。 - 探索性数据可视化:
Matplotlib提供底层像素级绘图控制,Seaborn提供封装良好的统计图表,Plotly则用于生成交互式HTML报表。 - 数据交换与数据湖集成:
PyArrow、Fastparquet用于读取海量Parquet/Feather文件,结合DuckDB进行单机嵌入式OLAP极速查询。
# 数据分析典型模式:向量化计算、数据聚合与清洗
import pandas as pd
import numpy as np

# 加载结构化交易数据
df = pd.read_parquet("sales_records_2025.parquet")

# 向量化清洗:处理缺失值并派生指标(避免使用for循环遍历)
df["unit_price"] = df["unit_price"].fillna(df.groupby("category")["unit_price"].transform("median"))
df["total_amount"] = df["quantity"] * df["unit_price"]

# 多维度分组透视分析
category_summary = (
    df.groupby(["region", "category"])
    .agg(
        total_revenue=("total_amount", "sum"),
        order_count=("order_id", "nunique"),
        avg_order_value=("total_amount", "mean")
    )
    .reset_index()
)

# 标记高价值异常交易分布(四分位距法)
q75 = category_summary["total_revenue"].quantile(0.75)
iqr = q75 - category_summary["total_revenue"].quantile(0.25)
category_summary["is_high_performer"] = category_summary["total_revenue"] > (q75 + 1.5 * iqr)
3. 人工智能与大模型技术栈
AI与算法工程师关注的是概率模型、特征表征与推理吞吐。随着大语言模型(LLM)的兴起,该方向已分化为底层模型预训练/微调与顶层模型推理/应用落地的完整体系。
- 深度学习底座:
PyTorch占据主导地位,开发者需要深入理解张量维度变换(Tensor Slicing/Reshaping)、动态计算图与反向传播(Autograd)。 - 模型库与权重生态:
Hugging Face (Transformers, Accelerate, PEFT),提供了现成的分词器(Tokenizer)、预训练骨干网络及参数高效微调(如LoRA、QLoRA)工具。 - 推理加速引擎:
vLLM(基于PagedAttention技术极大提升显存利用率)、ONNX Runtime、NVIDIA TensorRT-LLM,负责在生产环境中降低首字延迟并压榨GPU显存带宽。 - 向量检索与应用编排:
LangChain、LlamaIndex配合专业向量数据库Milvus、Chroma或Qdrant,实现检索增强生成(RAG)与智能体(Agent)工作流。
# AI/LLM典型模式:基于PyTorch与Transformers的文本表征与相似度计算
import torch
from transformers import AutoTokenizer, AutoModel
import torch.nn.functional as F

# 加载嵌入模型并指定GPU设备
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model_name = "BAAI/bge-small-zh-v1.5"

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModel.from_pretrained(model_name).to(device)

sentences = ["数据库连接池超时排查", "高并发Web接口调优", "深度学习模型显存不足"]
inputs = tokenizer(sentences, padding=True, truncation=True, return_tensors="pt").to(device)

# 禁用梯度计算以节省显存开销
with torch.no_grad():
    outputs = model(**inputs)
    # 取 [CLS] 标记的输出向量进行语义表征
    embeddings = outputs.last_hidden_state[:, 0]
    normalized_embeddings = F.normalize(embeddings, p=2, dim=1)

# 计算各文本间的余弦相似度矩阵
similarity_matrix = torch.matmul(normalized_embeddings, normalized_embeddings.T)
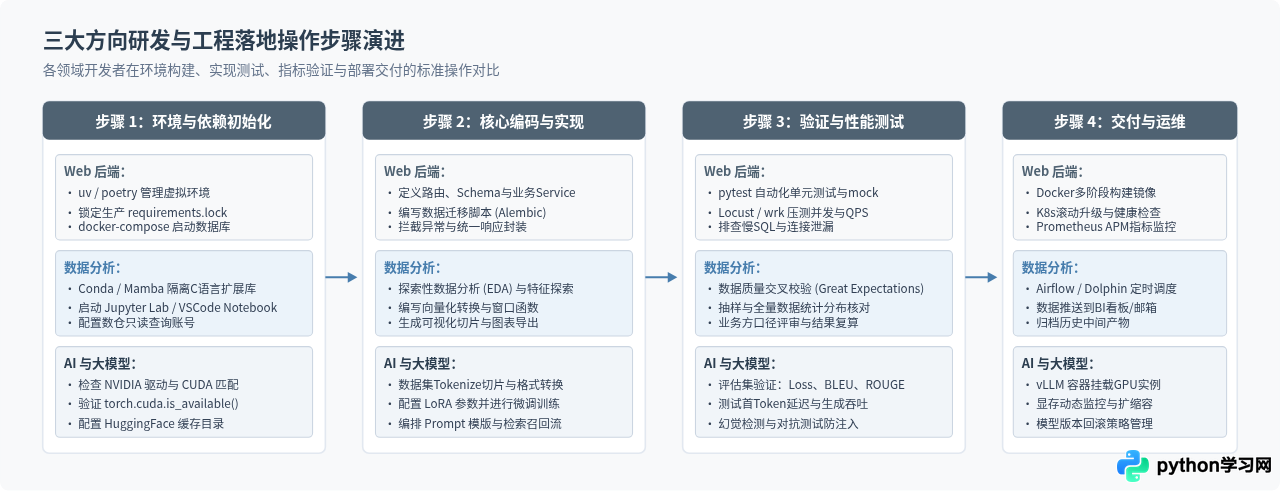
三、开发与验证环节的操作步骤差异
除了代码实现不同,三个方向在从立项到上线的工程全生命周期中,操作步骤和验收标准差异巨大。以下图表直观展示了各个方向的标准研发闭环。
四、底层运行机制与硬件资源瓶颈
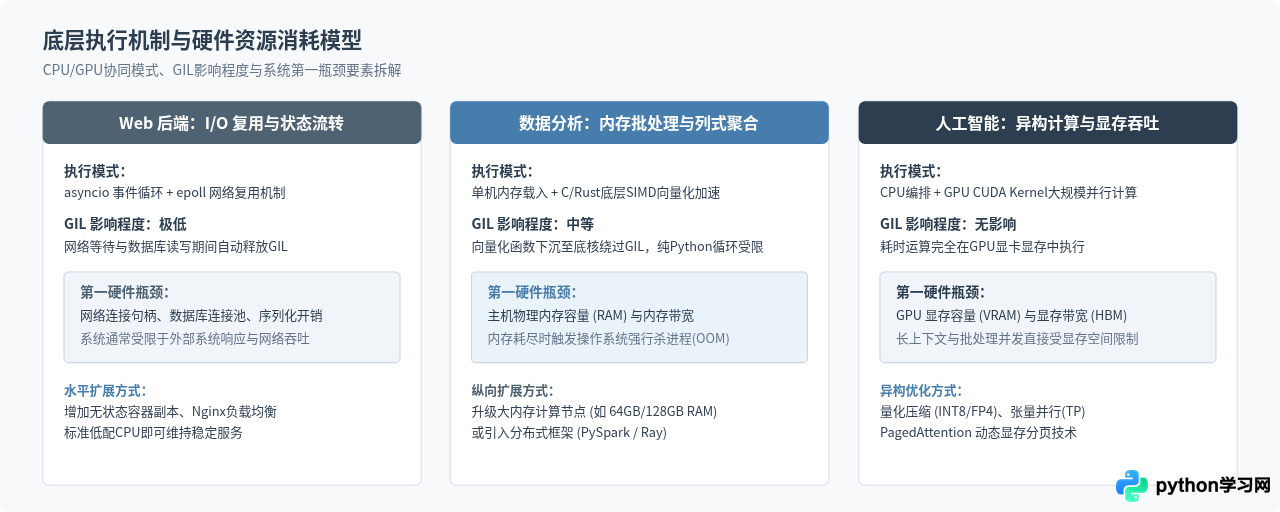
为什么同一个Python解释器,在三个方向会表现出完全不同的性能调优思路?这是因为不同方向在硬件资源的消耗类型上截然相反。
1. I/O密集型 vs 内存密集型 vs 显存带宽密集型
Python拥有全局解释器锁(GIL),但在不同场景下受GIL的影响程度完全不同:
- Web后端主要受限于网络与磁盘I/O:在等待PostgreSQL返回查询结果或等待下游HTTP微服务响应时,Python线程或协程主动让出CPU控制权。因此,通过
asyncio驱动的单线程事件循环(如FastAPI配合Uvicorn),单个CPU核心即可维持数千个高并发挂起连接。性能瓶颈极少在CPU算力本身,而是在数据库连接池耗尽、慢查询或外部接口抖动上。 - 数据分析主要受限于物理内存容量(RAM)与CPU缓存:Pandas执行合并(Merge)或分组(GroupBy)时,整个计算通常发生在单机内存中。由于DataFrame对象的内存膨胀效应,一个1GB的CSV文件加载后可能占用3~5GB的内存。一旦物理内存耗尽,系统就会发生Swap交换或被系统OOM Killer直接强行终止。计算密集度较高,但通常通过NumPy/Polars内部的C/Rust代码规避GIL。
- AI主要受限于GPU显存(VRAM)容量与通信带宽:模型训练和推理本质是高维浮点张量的矩阵乘法。Python在这里仅作为高级胶水语言负责组装计算图,真正的计算全部在NVIDIA GPU的Tensor Core中以CUDA C++形式并行运行。因此开发者日常痛苦的不是Python本身的运行速度,而是模型权重加载时发生的
CUDA out of memory,或者是分布式训练跨机通信时的PCIe/NVLink带宽瓶颈。
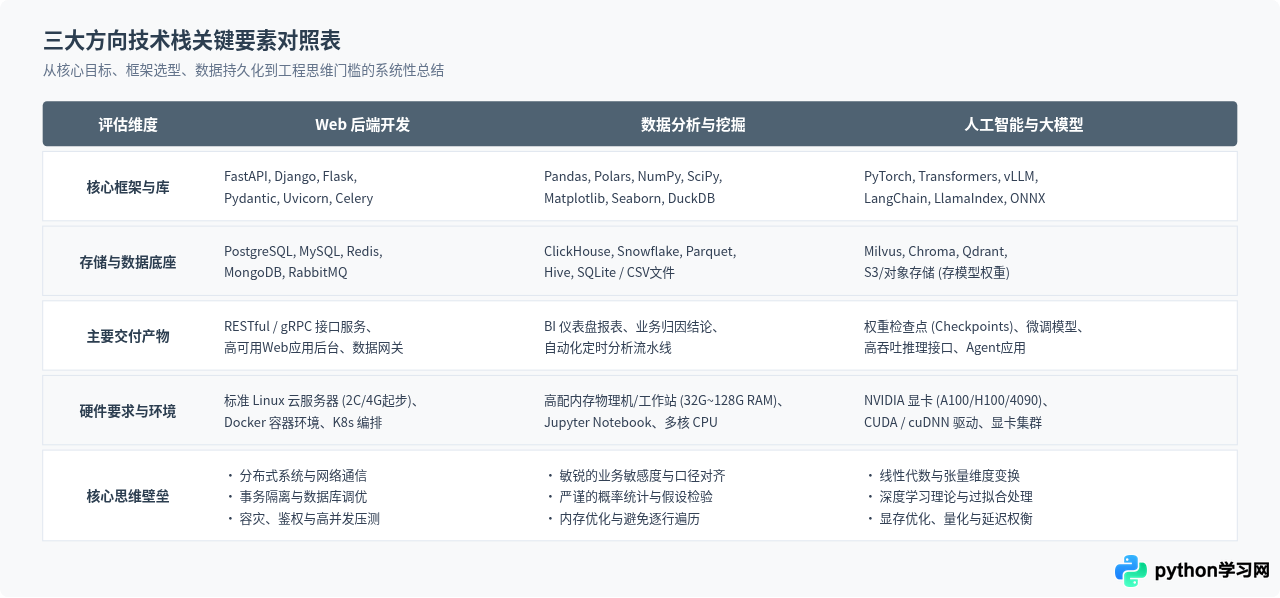
五、全维度技术栈要素对比总览
通过综合整理三大方向的技术栈生态与实际工作要求,以下总结表格为开发者提供了清晰的维度对照:
六、技能迁移建议与常见踩坑提醒
在实际职业发展中,不少开发者希望在这些方向之间转型。了解不同方向之间的转移阻力与思维陷阱至关重要。
1. 从Web后端转向AI应用开发的常见误区
许多Web工程师转型做AI应用时,最容易犯的错误是把大模型和向量数据库当成普通的第三方微服务处理。
- 超时时间陷阱:传统Web接口通常要求在200ms内返回,但大模型生成一个完整的长回复可能需要数秒甚至数十秒。直接使用传统的阻塞HTTP客户端会导致连接挂起或网关504超时。必须全面改用流式传输(Server-Sent Events, SSE)并处理客户端中断连接时的资源回收。
- 显存与并发不可同日而语:Web后端习惯了单机轻松承载几百上千并发,但在自建GPU推理服务时,单张GPU显卡的显存并发容量是极其受限的。如果不对并发推理请求进行动态队列调度(如vLLM的Continuous Batching),多个并发请求会迅速引发显存崩溃。
2. 从数据分析转向Web后端的常见误区
数据分析师转型后端时,最常遇到的问题在于状态管理、并发安全与面向对象模块化思维的缺失。
- 不要把Pandas带入Web核心请求链路:在Web接口中,有些开发者为了方便,直接用Pandas读取数据库并做简单的过滤或排序。Pandas加载数据集会带来巨大的瞬时内存开销,并且其初始化代价高昂。Web接口应优先将过滤和聚合下推到数据库层面(利用SQL索引和条件查询),保持Python内存轻量化。
- 环境管理不可依赖Jupyter式的隐式状态:分析工作习惯了Notebook中随时运行代码块、内存变量长期驻留的特性。但在后端工程中,必须建立严格的虚拟环境管理(通过
pyproject.toml或poetry.lock明确指定确定版本),编写健壮的单元测试,并理解请求无状态(Stateless)设计。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









