

Python基于GDP与人口数据绘制气泡图完整流程
详细讲解使用Python及Matplotlib基于国家/地区GDP与人口数据绘制气泡图的完整流程,涵盖多维数据映射、气泡面积感知归一化、对数轴处理与双图例构建技巧。
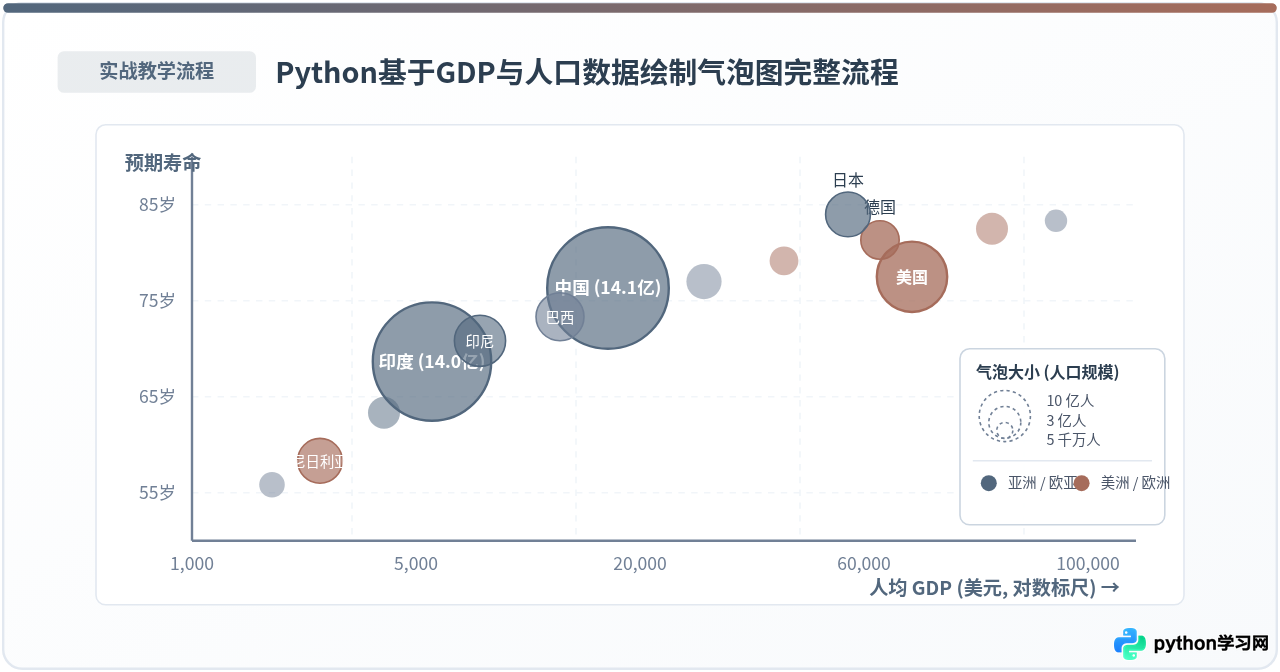
气泡图是在经典二维散点图的基础上,引入第三个(乃至第四个)维度的信息载体。在宏观经济与民生统计分析中,单纯使用折线或条形图往往难以直观揭示“人均富裕程度”、“国家总经济规模”与“人口体量”之间的非线性关联。基于国家或地区的统计数据,将人均GDP置于横轴、人均预期寿命或产业指标置于纵轴,并将人口总数映射为气泡的大小,辅以大洲色彩分类,能够在一个画面内呈现四维数据格局。本文将以直接、实操的方式,从数据组织、气泡物理面积转换原理、对数坐标处理到双图例构建,完整阐明在Python中使用Matplotlib绘制高质量气泡图的全套实现方案。
一、气泡图的四维视觉通道设计
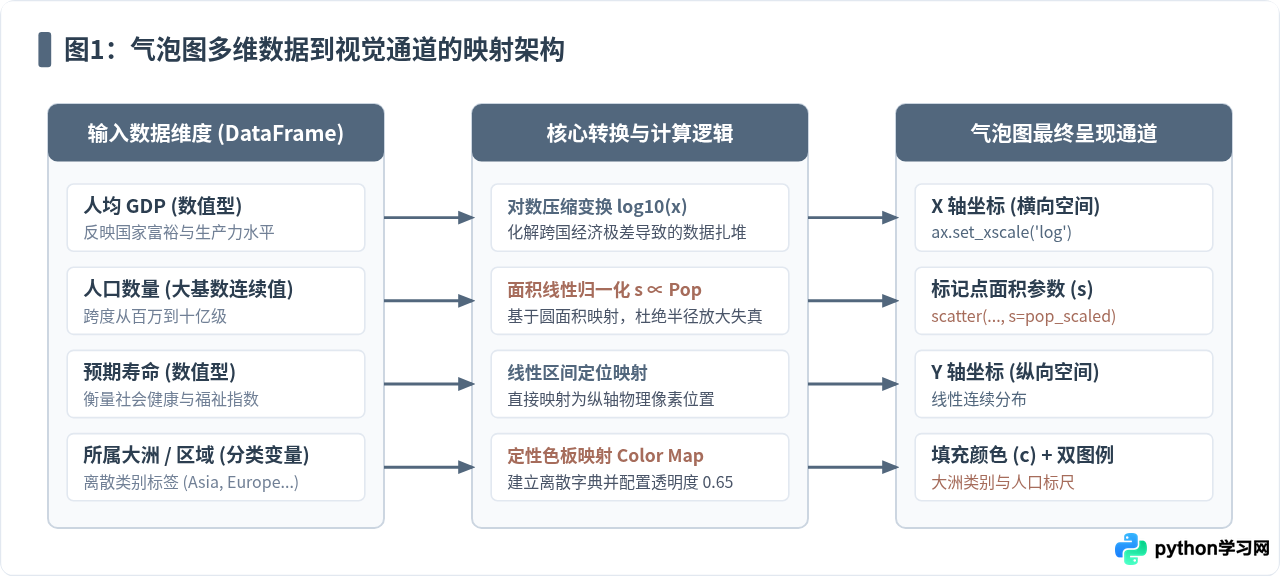
绘制一张具有说服力的数据图表,首要任务是明确每一个数据字段与图形视觉通道之间的对应关系。常规的散点图只利用了二维平面上的空间位置(X与Y坐标),而气泡图则在此基础上激活了“标记点面积”与“填充色彩”,从而实现对四个统计维度的同步承载:
- 横轴坐标(X轴):人均GDP(GDP per capita)。作为衡量各经济体个体富裕程度的指标,由于全球国家之间存在从几百美元到数万美元的巨大极差,该通道通常需要配合对数尺度处理。
- 纵轴坐标(Y轴):人均预期寿命(Life Expectancy)。作为衡量社会公共卫生与综合民生发展的指标,数据分布相对平缓集中(通常在50至85岁区间),适合采用常规的线性刻度。
- 气泡标记面积(Size):国家总人口(Population)。用来表征该经济体的实体规模与权重。人口越多,对应的气泡在视觉上占据的区域越显著。
- 色彩与透明度(Color & Alpha):所属地理区域或大洲(Continent/Region)。使用离散分类色板进行区分,同时设置半透明属性,防止相邻气泡产生视线死角。
二、关键原理:气泡尺寸的物理与感知映射
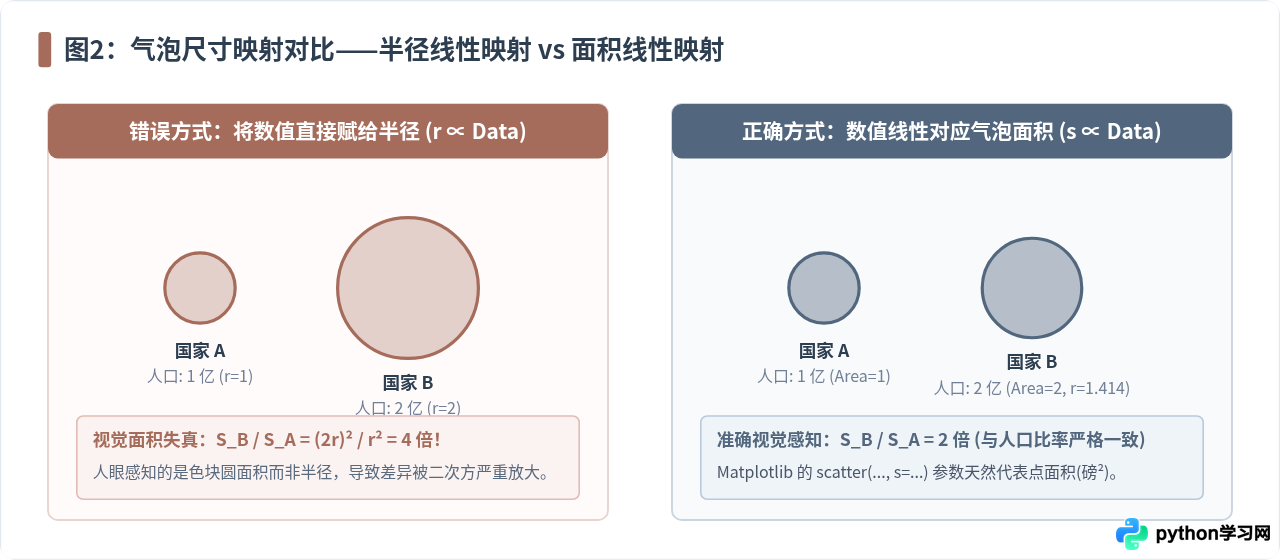
很多初学者在绘制气泡图时最容易犯的错误,就是直接将人口数值赋值给散点半径,或者未加思考地使用默认缩放。这种做法在数据可视化规范中属于严重的“感知扭曲”。
当读者观察一个圆形图元时,大脑视觉神经感知到的是该图形所覆盖的二维平面积(S = πr²),而不是它的一维半径(r)。如果直接让半径与人口数成正比(r ∝ Population),那么当两个国家的人口比例为1比2时,其气泡的视觉面积将被放大为 1² : 2² = 1 : 4。读者在潜意识中会误以为第二个国家的人口是第一个国家的4倍,从而产生了严重的视觉欺骗。
在Matplotlib中,plt.scatter(x, y, s=...)的s参数代表的是标记点面积的平方磅数(points^2),而不是半径。因此,将人口数据线性映射到s,恰好符合“数值与感知面积成正比”的科学可视化原则。不过由于国家人口绝对值往往高达数亿,必须通过适当的数学缩放公式将庞大的数值映射到适合画布观看的像素区间内。
s = min_size + (pop - pop_min) / (pop_max - pop_min) * (max_size - min_size)。对于800×600像素的常规图表,将min_size设为40,max_size设为2500左右,能确保各量级气泡均有良好的辨识度。
三、数据准备与清洗规范
在执行绘图命令前,需要确保输入的数据框(DataFrame)结构清晰规范。每一行代表一个独立国家或经济体,且必须保证关键列不存在非法的空值或负数。为了使接下来的代码能够独立运行,我们先构建一组涵盖主要大洲代表性国家的结构化数据集:
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

# 构建标准国家宏观统计样例数据
data = [
    {"country": "中国", "gdp_per_capita": 12500, "life_expectancy": 78.2, "population": 1411750000, "continent": "亚洲"},
    {"country": "印度", "gdp_per_capita": 2400, "life_expectancy": 70.8, "population": 1408000000, "continent": "亚洲"},
    {"country": "美国", "gdp_per_capita": 76000, "life_expectancy": 77.5, "population": 331900000, "continent": "美洲"},
    {"country": "印度尼西亚", "gdp_per_capita": 4780, "life_expectancy": 71.3, "population": 273750000, "continent": "亚洲"},
    {"country": "巴西", "gdp_per_capita": 8900, "life_expectancy": 75.9, "population": 214300000, "continent": "美洲"},
    {"country": "尼日利亚", "gdp_per_capita": 2180, "life_expectancy": 55.2, "population": 218500000, "continent": "非洲"},
    {"country": "日本", "gdp_per_capita": 39300, "life_expectancy": 84.6, "population": 125500000, "continent": "亚洲"},
    {"country": "德国", "gdp_per_capita": 51200, "life_expectancy": 81.0, "population": 83200000, "continent": "欧洲"},
    {"country": "英国", "gdp_per_capita": 46500, "life_expectancy": 81.2, "population": 67300000, "continent": "欧洲"},
    {"country": "法国", "gdp_per_capita": 43600, "life_expectancy": 82.5, "population": 67750000, "continent": "欧洲"},
    {"country": "埃塞俄比亚", "gdp_per_capita": 1020, "life_expectancy": 65.0, "population": 120300000, "continent": "非洲"},
    {"country": "越南", "gdp_per_capita": 4160, "life_expectancy": 75.4, "population": 97470000, "continent": "亚洲"},
    {"country": "挪威", "gdp_per_capita": 89000, "life_expectancy": 83.2, "population": 5400000, "continent": "欧洲"},
    {"country": "南非", "gdp_per_capita": 6990, "life_expectancy": 65.3, "population": 59300000, "continent": "非洲"}
]

df = pd.DataFrame(data)

# 数据完整性检查与清洗过滤
df = df.dropna(subset=['gdp_per_capita', 'life_expectancy', 'population'])
df = df[(df['gdp_per_capita'] > 0) & (df['population'] > 0)]
四、Python绘制核心步骤与完整代码实现
绘制高质量气泡图有五个核心执行步骤:数据排序、颜色字典映射、散点批量绘制、对数轴变换以及双图例装配。
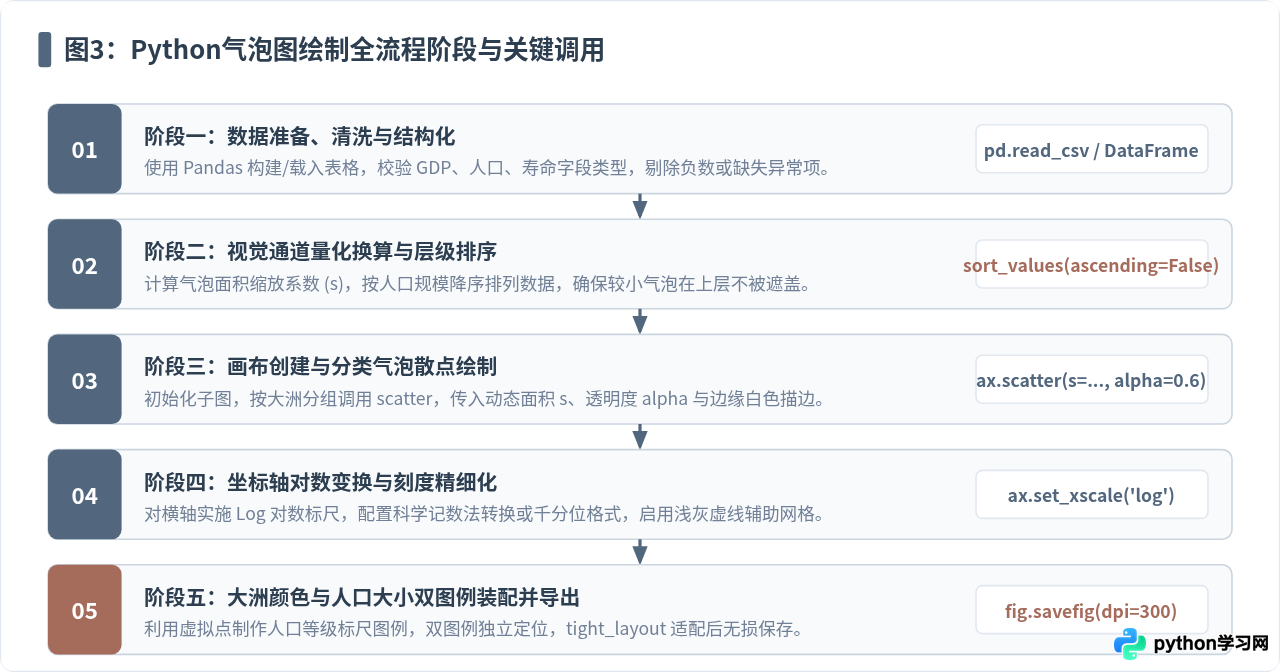
以下是能够直接复制并执行的完整脚本。代码中包含了详细的步骤标注与参数说明:
import matplotlib.pyplot as plt
from matplotlib.ticker import FuncFormatter
import numpy as np
import pandas as pd

# 设置中文字体与负号正常显示
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False

# 1. 气泡层级排序(极其重要):按人口降序排列
# 先绘制大国气泡,再绘制小国气泡,小国气泡位于上层,避免被彻底遮挡覆盖
df = df.sort_values(by='population', ascending=False).reset_index(drop=True)

# 2. 面积尺寸映射计算
# 人口基数以百万(M)为单位换算,并设定线性缩放系数
scale_factor = 2.2
min_marker_area = 50
df['bubble_size'] = (df['population'] / 1e6) * scale_factor + min_marker_area

# 3. 设定各区域统一色盘
color_map = {
    "亚洲": "#52677D",  # 主色调:稳重蓝灰
    "欧洲": "#7B8B9B",  # 辅助调:浅灰蓝
    "美洲": "#A66C5B",  # 强调色:古朴赭红
    "非洲": "#C48B7C"   # 强调浅调:柔和赭褐
}

# 4. 创建画布与坐标系
fig, ax = plt.subplots(figsize=(10, 6.5), dpi=150, facecolor="#FFFFFF")
ax.set_facecolor("#FAFAFA")

# 5. 分类别循环绘制气泡散点
for continent, group in df.groupby('continent'):
    ax.scatter(
        group['gdp_per_capita'],
        group['life_expectancy'],
        s=group['bubble_size'],
        c=color_map.get(continent, "#999999"),
        alpha=0.68,
        edgecolors='#FFFFFF',
        linewidth=1.2,
        label=continent,
        zorder=3
    )

# 为几个典型代表性国家添加文本标注
notable_countries = ["中国", "印度", "美国", "日本", "德国", "尼日利亚"]
for _, row in df.iterrows():
    if row['country'] in notable_countries:
        ax.annotate(
            row['country'],
            xy=(row['gdp_per_capita'], row['life_expectancy']),
            xytext=(0, 6),
            textcoords='offset points',
            ha='center',
            va='bottom',
            fontsize=9,
            fontweight='bold',
            color='#2C3E50',
            zorder=4
        )

# 6. 横轴对数坐标处理与刻度标签美化
ax.set_xscale('log')
ax.set_xlim(600, 150000)
ax.set_ylim(50, 90)

# 自定义横轴对数标签格式化函数(千分位展示)
def currency_formatter(x, pos):
    if x >= 1000:
        return f"${int(x/1000)}k"
    return f"${int(x)}"

ax.xaxis.set_major_formatter(FuncFormatter(currency_formatter))

# 7. 坐标轴标签与辅助网格
ax.set_xlabel("人均 GDP (美元, 对数刻度)", fontsize=11, fontweight='bold', color='#334155', labelpad=10)
ax.set_ylabel("人均预期寿命 (岁)", fontsize=11, fontweight='bold', color='#334155', labelpad=10)
ax.set_title("全球典型国家人均GDP、预期寿命与人口体量分布气泡图", fontsize=14, fontweight='bold', color='#1E293B', pad=15)

ax.grid(True, which='both', linestyle='--', linewidth=0.6, color='#E2E8F0', zorder=1)
ax.spines['top'].set_visible(False)
ax.spines['right'].set_visible(False)
ax.spines['left'].set_color('#CBD5E0')
ax.spines['bottom'].set_color('#CBD5E0')

# 8. 双图例配置:大洲颜色图例 + 人口大小分级图例
# 图例一:大洲分类图例(放置于左上角)
legend_continent = ax.legend(
    title="地理大区",
    loc='upper left',
    frameon=True,
    facecolor='#FFFFFF',
    edgecolor='#E2E8F0',
    fontsize=9,
    title_fontsize=10
)
ax.add_artist(legend_continent)

# 图例二:人口标尺图例(通过不可见空散点构建)
pop_sample_values = [1000, 300, 50]  # 百万(M)
pop_handles = []
for p in pop_sample_values:
    marker_size = p * scale_factor + min_marker_area
    handle = ax.scatter(
        [], [],
        s=marker_size,
        c='#718096',
        alpha=0.45,
        edgecolors='#52677D',
        linewidth=1,
        label=f"{p}M"
    )
    pop_handles.append(handle)

legend_size = ax.legend(
    handles=pop_handles,
    labels=["10 亿人", "3 亿人", "5000 万人"],
    title="人口规模标尺",
    loc='lower right',
    frameon=True,
    facecolor='#FFFFFF',
    edgecolor='#E2E8F0',
    fontsize=8.5,
    title_fontsize=9.5,
    labelspacing=1.3,
    borderpad=1.0
)

plt.tight_layout()
# 9. 输出图像文件(指定较高DPI以保证印刷及高清屏清晰度)
plt.savefig("bubble_chart_gdp_population.png", dpi=300, bbox_inches='tight')
plt.show()
五、关键视觉调优技巧与常见问题排查
完成基本绘制后,若直接交付通常会遇到多项可读性障碍。以下四项针对性调优是区分业余散点图与专业出版级气泡图的分水岭:
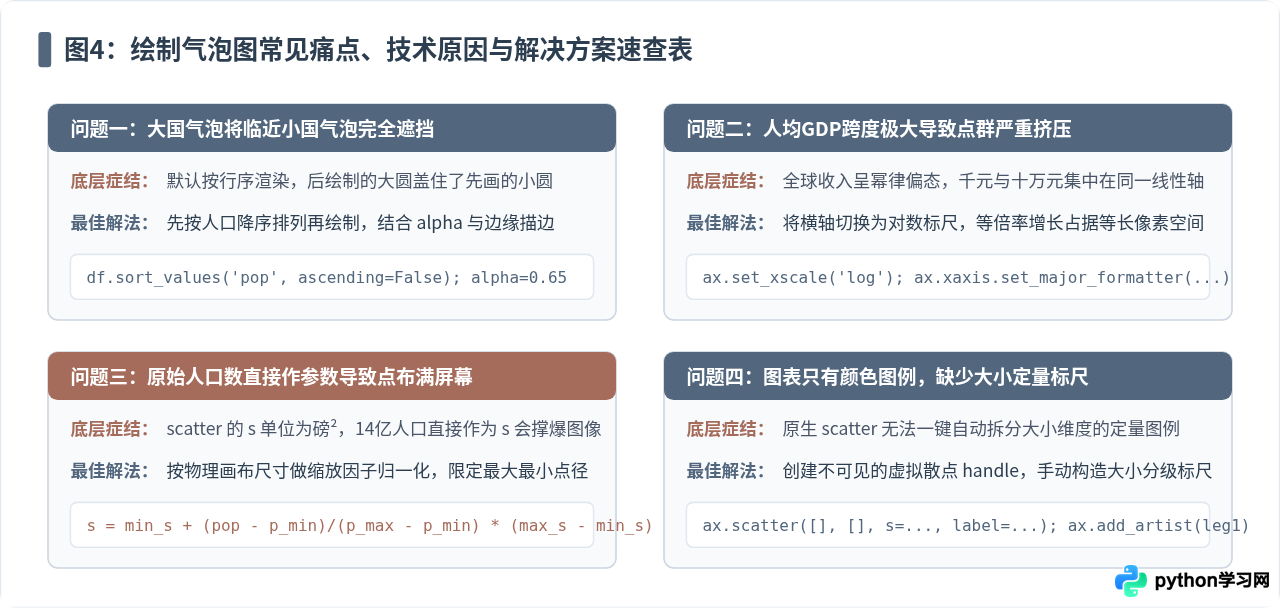
1. 气泡重叠与先后覆盖次序
中国与印度的人口均超过14亿,如果在数据框中它们排在最后被绘制,其巨大的气泡会直接覆盖附近人均GDP相仿但人口较少的小国气泡。解决方案是在绘图前严格执行 df.sort_values(by='population', ascending=False),让大圆沉底,小圆浮在顶层;同时为所有气泡设置 alpha=0.65 左右的透明度,并加上白色细描边 edgecolors='#FFFFFF',即使两个气泡完全同心,边缘描边也能清晰分离前后轮廓。
2. 横轴对数坐标(Log Scale)的必要性
如果使用普通的线性X轴,绝大多数发展中国家人均GDP集中在2,000到15,000美元之间,而欧美高收入国家在50,000到90,000美元之间。在线性轴上,大量国家会挤压在靠近原点的极窄条带内,右侧画布则极度空旷。通过 ax.set_xscale('log'),等比增长(例如2,000到4,000,与20,000到40,000)将占据相同的空间步长,更真实地反映经济增长的边际效应与阶梯分布。
3. 构建定量大小图例(Dual Legends)
Matplotlib 默认的 ax.legend() 只会根据 label 提取散点的颜色,无法自动为连续的数值面积生成阶梯标尺。通过在画布外部创建坐标为空([], [])的虚拟散点作为图元代理(Proxy Artist),可以精准注入预设分级(如10亿、3亿、5000万)对应的s值,并通过 ax.add_artist(legend_continent) 确保两套图例在同一画布上和谐共存。
六、总结与核心参数决策速查
基于GDP与人口数据绘制气泡图,本质是在二维平面上协调好四个维度的信息密度。通过对数坐标压缩横向极差、以面积平方磅精确表征人口规模、辅以大洲色彩与半透明重叠控制,最终使得宏观经济数据图表兼具统计严密性与视觉直观性。读者在实际项目中可以根据具体分析需求,替换Y轴指标(例如替换为碳排放强度、基尼系数或城市化率),而本文梳理的数据预处理、面积感知缩放与双图例架构均可原样复用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









