

Python怎么处理旧版.doc格式文件的读取与转换问题
深入讲解在Python中处理旧版Word 97-2003(.doc)二进制文件的读取与转换方案,详细解析CFBF与OpenXML结构差异,提供基于LibreOffice与pywin32的完整代码实现及生产级容错实践。
.doc 文件时,Python 生态中最主流的文档库 python-docx 无法直接对其进行解析。其根本原因在于旧版 .doc 采用专有的二进制复合文档格式,而 python-docx 仅专为基于 OpenXML 标准的 .docx 容器设计。要解决读取与转换问题,核心思路分为两类:当仅需获取纯文字时,可通过轻量级解析器直接抽取;当需要提取排版、段落层级与表格时,最可靠的做法是调度外部引擎(在跨平台或 Linux 服务器环境使用 LibreOffice 无头模式,在 Windows 环境调用 Word COM 组件)将文件批量转换为 .docx,再交由 python-docx 提取结构化数据。
一、为什么常规 Python 库无法直接读取旧版 .doc
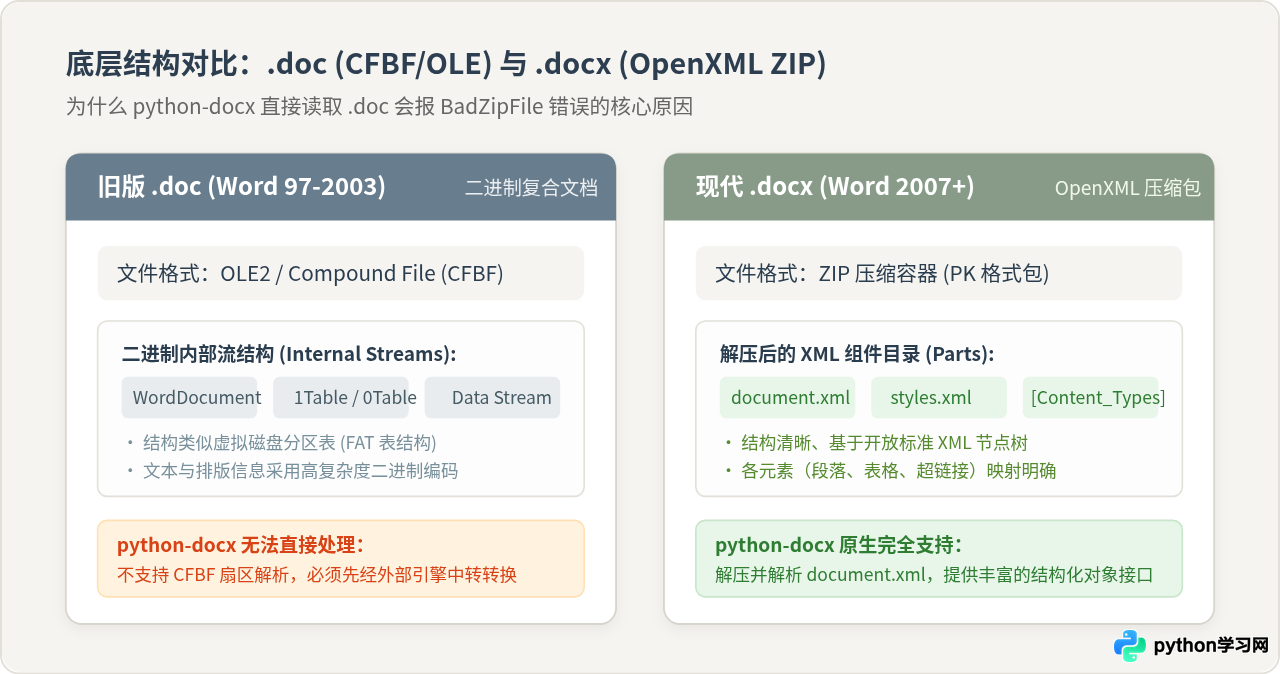
许多开发者在尝试使用 Python 操作 Word 文档时,最先尝试的往往是 pip install python-docx,随后执行 docx.Document("sample.doc")。然而程序会立即抛出 BadZipFile: File is not a zip file 或 PackageNotFoundError 异常。这并不是文件损坏,而是由两者截然不同的底层存储架构决定的。
2007 年以后的现代 .docx 文件,本质上是一个标准 ZIP 压缩包,解压后是一组规范的 XML 纯文本清单(例如 document.xml 保存正文、styles.xml 保存样式)。python-docx 的全部内部机制都建立在解包 ZIP、遍历并修改 XML 树状结构的基础之上。
相反,旧版的 .doc 是由微软在上世纪 90 年代制定的复合文件二进制格式(Compound File Binary Format,简称 CFBF 或 OLE2)。这种格式在单个文件内部模拟了一套完整的磁盘文件系统,包含类似 FAT 分区表、扇区分配、固定大小流(Streams)以及存储区(Storages)。正文文本、字体格式、内嵌图表混合交织在高度编码的二进制数据块中。直接用 Python 从头反序列化这些二进制扇区极其繁琐,因此主流做法均是通过转换引擎将其还原为标准格式后再行处理。
二、技术选型:纯文本提取与结构化转换的关键差异
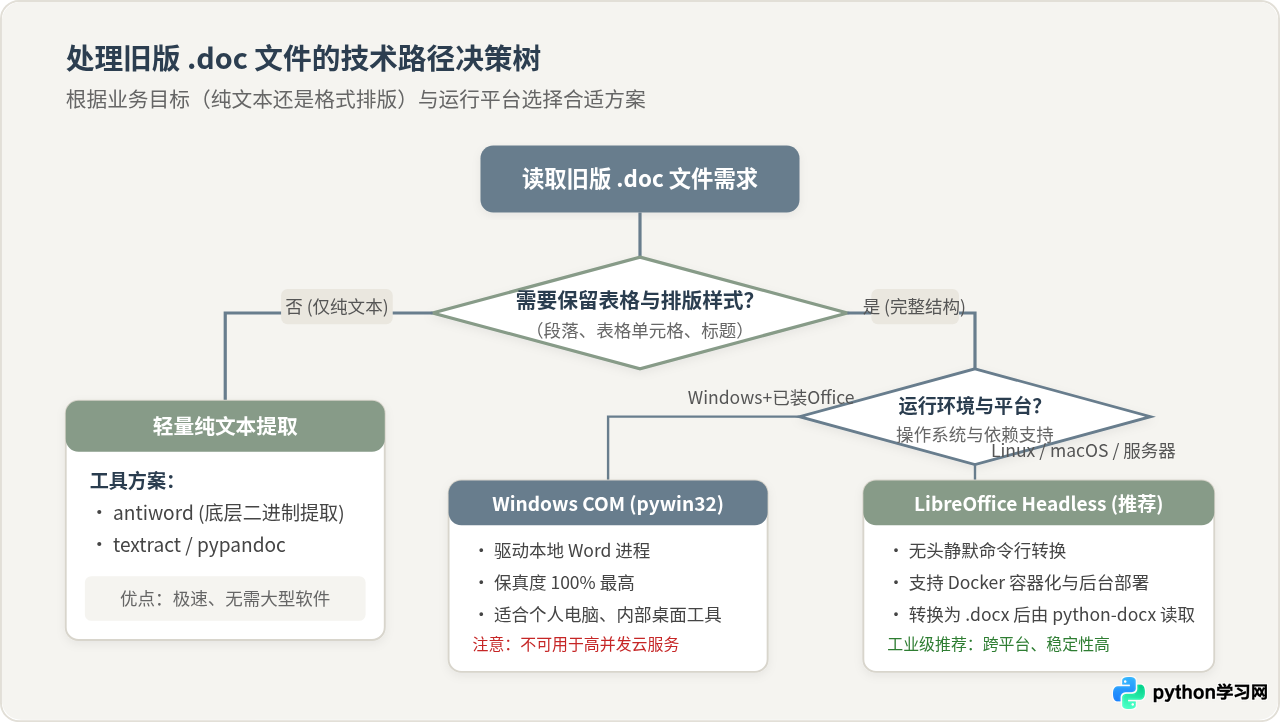
在制定处理方案前,必须明确当前业务对文档数据的具体要求。盲目追求完整转换可能会增加不必要的系统依赖,而仅做文本抽取则可能丢失关键信息。
两类处理路径的差异及影响如下:
- 纯文本抽取路径:适用于全文检索索引构建、关键词挖掘、大模型语料清洗或分类。这类任务只关心文本字符本身,不需要单元格行列位置、加粗、颜色或嵌套图表。采用基于 C 语言编写的轻量工具抽取,每秒可处理数十篇,依赖体积通常仅有几兆字节。
- 格式化转换路径(转为 .docx):适用于合同要素核对、财报表格抽取、带样式排版的文档重构。表格中的行列跨度与单元格层级必须被严格保留,若直接退化为纯文本,数据关联性将彻底瓦解。此路径必须调用完备的办公软件排版引擎进行重渲染和重新封装。
三、通用跨平台方案:利用 LibreOffice 无头模式批量转换
对于部署在 Linux 云服务器、Docker 容器或 macOS 环境的后端服务,LibreOffice 是处理格式转换最通用且工业级可靠的利器。LibreOffice 内置了对老旧二进制 OLE 格式的成熟解码引擎,并原生支持通过命令行在无图形界面(Headless)下运行。
1. 环境准备与命令行测试
在 Linux(如 Ubuntu/Debian)或 macOS 终端中安装 LibreOffice:
终端命令# Ubuntu / Debian 服务端
sudo apt-get update && sudo apt-get install -y libreoffice
# macOS 环境 (Homebrew)
brew install --cask libreoffice通过命令行验证转换功能是否工作正常:
终端命令soffice --headless --convert-to docx sample.doc --outdir ./output/执行后,目录中将生成同名的 sample.docx 文件,排版与原 .doc 保持高度一致。
2. Python 健壮封装与自动转换
在 Python 中通过 subprocess.run 调用无头命令时,务必配置超时时间,避免个别携带损坏宏代码或死循环流的畸形文档挂起整个后台进程:
import os
import subprocess
import shutil
from pathlib import Path

def convert_doc_to_docx_libreoffice(doc_path: str, output_dir: str = None, timeout_sec: int = 60) -> str:
    """
    使用 LibreOffice 无头模式将 .doc 转换为 .docx
    :param doc_path: 源 .doc 文件路径
    :param output_dir: 输出目录,若为空则与源文件同目录
    :param timeout_sec: 最大转换等待秒数,防止损坏文件阻塞
    :return: 生成的 .docx 文件绝对路径
    """
    src = Path(doc_path).resolve()
    if not src.exists():
        raise FileNotFoundError(f"源文件未找到: {src}")
    if src.suffix.lower() != ".doc":
        raise ValueError(f"只支持 .doc 格式文件: {src}")

    out_dir = Path(output_dir).resolve() if output_dir else src.parent
    out_dir.mkdir(parents=True, exist_ok=True)
    expected_docx = out_dir / f"{src.stem}.docx"

    # 寻找可用的 LibreOffice 启动命令
    candidates = ["libreoffice", "soffice"]
    if os.name == "nt":  # Windows 兼容路径
        candidates.extend([
            r"C:\Program Files\LibreOffice\program\soffice.exe",
            r"C:\Program Files (x86)\LibreOffice\program\soffice.exe"
        ])

    cmd_binary = None
    for cand in candidates:
        if shutil.which(cand) or os.path.exists(cand):
            cmd_binary = cand
            break

    if not cmd_binary:
        raise RuntimeError("系统未检测到 LibreOffice,请确保已安装并将 soffice 加入 PATH。")

    cmd = [
        cmd_binary,
        "--headless",
        "--convert-to", "docx",
        str(src),
        "--outdir", str(out_dir)
    ]

    try:
        proc = subprocess.run(
            cmd,
            stdout=subprocess.PIPE,
            stderr=subprocess.PIPE,
            text=True,
            timeout=timeout_sec,
            check=True
        )
    except subprocess.TimeoutExpired:
        raise TimeoutError(f"LibreOffice 转换超时(超过 {timeout_sec} 秒): {src}")
    except subprocess.CalledProcessError as e:
        raise RuntimeError(f"LibreOffice 转换失败,错误信息: {e.stderr}")

    if not expected_docx.exists():
        raise FileNotFoundError(f"转换命令已执行,但未发现产物文件: {expected_docx}")

    return str(expected_docx)
3. 读取转换后的 .docx 结构化内容
一旦完成向 .docx 的转置,就可以无缝使用 python-docx 提取文档各层级内容:
from docx import Document

def inspect_docx_content(docx_file: str):
    doc = Document(docx_file)

    print("--- 提取段落文本 ---")
    for idx, p in enumerate(doc.paragraphs):
        text = p.text.strip()
        if text:
            print(f"[{p.style.name}] 段落 {idx + 1}: {text}")

    print("\n--- 提取表格数据 ---")
    for t_idx, table in enumerate(doc.tables):
        print(f"表格 {t_idx + 1} (行: {len(table.rows)}, 列: {len(table.columns)}):")
        for row in table.rows:
            row_vals = [cell.text.strip() for cell in row.cells]
            print(" | ".join(row_vals))
四、Windows 环境专属方案:通过 pywin32 调度 Office COM
在已经安装了正版 Microsoft Office 的 Windows 桌面或内网工作站上,利用 pywin32 库调用原生 Word 程序是排版保真度最高的方案。因为由 Word 自身进行“另存为”操作,数学公式、专有宏域、复杂矢量图标均能得到精准还原。
实现代码必须严格遵循资源释放原则,保证无论转换成功与否,后台的 WINWORD.EXE 均能被及时退出并释放:
import os
from pathlib import Path

def convert_doc_to_docx_win32(doc_path: str, output_path: str = None) -> str:
    """
    在 Windows 上使用 pywin32 调用 MS Word 另存为 .docx
    :param doc_path: 输入 .doc 路径
    :param output_path: 输出 .docx 路径
    :return: 转换后的 .docx 路径
    """
    import win32com.client  # 需 pip install pywin32

    src = Path(doc_path).resolve()
    target = Path(output_path).resolve() if output_path else src.with_suffix(".docx")

    word = None
    doc = None
    try:
        # 启动后台静默 Word 实例
        word = win32com.client.DispatchEx("Word.Application")
        word.Visible = False
        word.DisplayAlerts = False  # 屏蔽弹窗告警

        # 打开文档
        doc = word.Documents.Open(str(src))

        # 16 代表 wdFormatXMLDocument (即标准 .docx 格式)
        wdFormatXMLDocument = 16
        doc.SaveAs2(str(target), FileFormat=wdFormatXMLDocument)
        return str(target)
    finally:
        if doc is not None:
            doc.Close(False)
        if word is not None:
            word.Quit()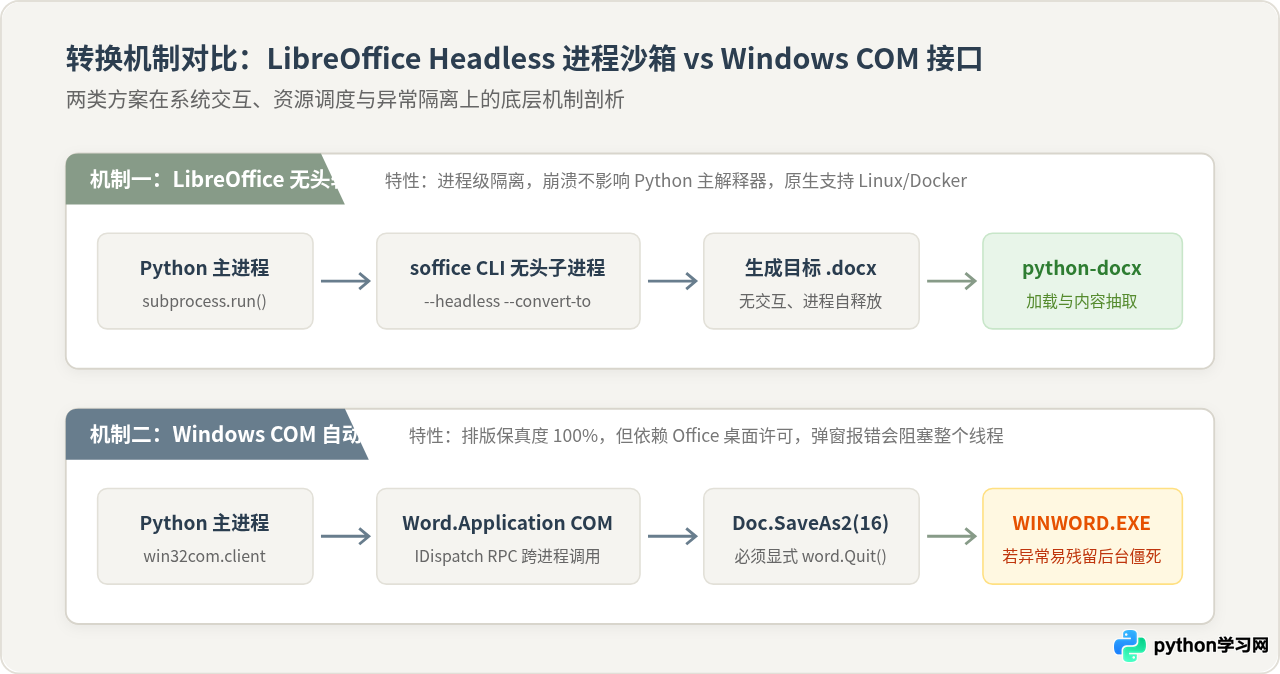
五、轻量化场景:使用 antiword 快速提取纯文本
如果服务器硬件资源受限(如小型嵌入式机器或轻量云主机),无法容纳庞大的办公套件,或者业务仅仅是做全文检索关键词索引,可以使用开源纯 C 工具 antiword。
antiword 能够直接解析 OLE2 复合流中的文本块并输出为纯文本,启动速度在毫秒级:
# Linux 安装
sudo apt-get install -y antiword

# 命令行直接打印 .doc 文本
antiword sample.doc
在 Python 中直接读取其标准输出流:
Python 代码 (antiword_reader.py)import subprocess
from pathlib import Path
def extract_text_antiword(doc_file: str) -> str:
path = Path(doc_file).resolve()
if not path.exists():
raise FileNotFoundError(f"文件不存在: {path}")
result = subprocess.run(
["antiword", str(path)],
stdout=subprocess.PIPE,
stderr=subprocess.PIPE,
text=True,
encoding="utf-8",
errors="ignore"
)
if result.returncode != 0:
raise RuntimeError(f"antiword 执行出错: {result.stderr}")
return result.stdout.strip()六、生产级批量处理与异常防御实践
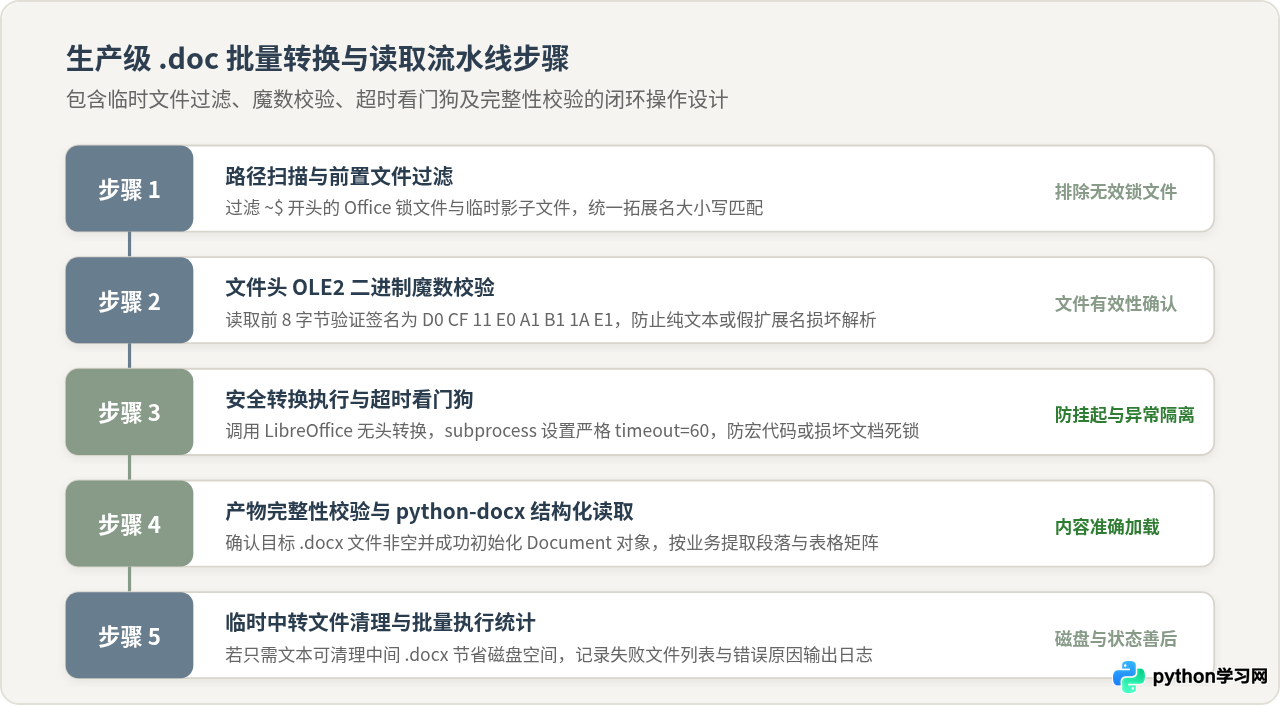
在批量处理数千份历史归档文档的实际工程中,不能假设所有文档都是完好合规的。真实的业务数据往往充满陷阱:文件扩展名被人工错改、Office 协作中残留的隐藏锁文件、甚至是损坏的零字节文件。
1. 核心防御机制
- 过滤临时锁文件:Word 打开文件时会在同目录下生成
~$sample.doc形式的隐藏锁文件。遍历目录时必须过滤以~$或.开头的文件,否则会导致转换引擎读锁冲突。 - 文件头魔数(Magic Number)校验:真正的 OLE2 二进制
.doc文件,前 8 个字节具有严格的特征魔数:D0 CF 11 E0 A1 B1 1A E1。如果一个扩展名为.doc的文件前几个字节是<html或纯文本,说明是由网页或文本文件伪造扩展名而来,应直接使用对应的文本解析器处理,避免送入转换引擎造成崩溃。 - 子进程超时断路:任何调用外部 CLI 的操作都必须设定
timeout。某些包含死循环宏或损坏交叉引用的文档会导致渲染器 CPU 占满且永不退出,超时看门狗可确保单篇异常不会破坏整个批处理队列。
2. 工业级批处理管道完整代码
Python 代码 (batch_pipeline.py)import os
import sys
import subprocess
from pathlib import Path
from docx import Document
OLE2_MAGIC = b"\xD0\xCF\x11\xE0\xA1\xB1\x1A\xE1"
def is_valid_doc_magic(file_path: Path) -> bool:
"""通过文件头魔数校验是否为真实的二进制 OLE 复合文档"""
try:
with open(file_path, "rb") as f:
header = f.read(8)
return header == OLE2_MAGIC
except Exception:
return False
def batch_process_docs(input_folder: str, output_folder: str):
in_dir = Path(input_folder).resolve()
out_dir = Path(output_folder).resolve()
out_dir.mkdir(parents=True, exist_ok=True)
# 扫描并过滤无效锁文件
doc_candidates = [
p for p in in_dir.glob("**/*")
if p.is_file()
and p.suffix.lower() == ".doc"
and not p.name.startswith("~$")
and not p.name.startswith(".")
]
print(f"扫描到候选 .doc 文件共 {len(doc_candidates)} 份")
success_list = []
failed_list = []
for doc_path in doc_candidates:
print(f"\n正在处理: {doc_path.name} ...")
# 步骤 2: 文件魔数检查
if not is_valid_doc_magic(doc_path):
print(f" [跳过] 文件头非标准 OLE2 签名,可能为假伪扩展名文件: {doc_path.name}")
failed_list.append((doc_path.name, "非标准 OLE2 文件头"))
continue
target_docx = out_dir / f"{doc_path.stem}.docx"
# 步骤 3: 安全转换执行
try:
cmd = ["libreoffice", "--headless", "--convert-to", "docx", str(doc_path), "--outdir", str(out_dir)]
subprocess.run(cmd, stdout=subprocess.DEVNULL, stderr=subprocess.PIPE, timeout=45, check=True)
except subprocess.TimeoutExpired:
print(f" [失败] 转换超时: {doc_path.name}")
failed_list.append((doc_path.name, "转换执行超时"))
continue
except Exception as err:
print(f" [失败] 引擎调度异常: {err}")
failed_list.append((doc_path.name, str(err)))
continue
# 步骤 4: 结果验证与结构化试读
if not target_docx.exists() or target_docx.stat().st_size == 0:
print(f" [失败] 目标文件未生成或大小为 0")
failed_list.append((doc_path.name, "未生成有效 docx 产物"))
continue
try:
doc = Document(str(target_docx))
total_paragraphs = len(doc.paragraphs)
total_tables = len(doc.tables)
print(f" [成功] 转换完成并校验通过: 段落数={total_paragraphs}, 表格数={total_tables}")
success_list.append(doc_path.name)
except Exception as read_err:
print(f" [异常] docx 生成但无法解析: {read_err}")
failed_list.append((doc_path.name, f"读取解析失败: {read_err}"))
# 步骤 5: 统计输出
print("\n================== 批处理总结报告 ==================")
print(f"成功处理: {len(success_list)} 篇")
print(f"失败/跳过: {len(failed_list)} 篇")
if failed_list:
print("\n失败清单与原因:")
for name, reason in failed_list:
print(f" - {name}: {reason}")
if __name__ == "__main__":
if len(sys.argv) >= 3:
batch_process_docs(sys.argv[1], sys.argv[2])
else:
print("示例用法: python batch_pipeline.py ./raw_docs ./converted_docs")七、方案选型综合对比与总结
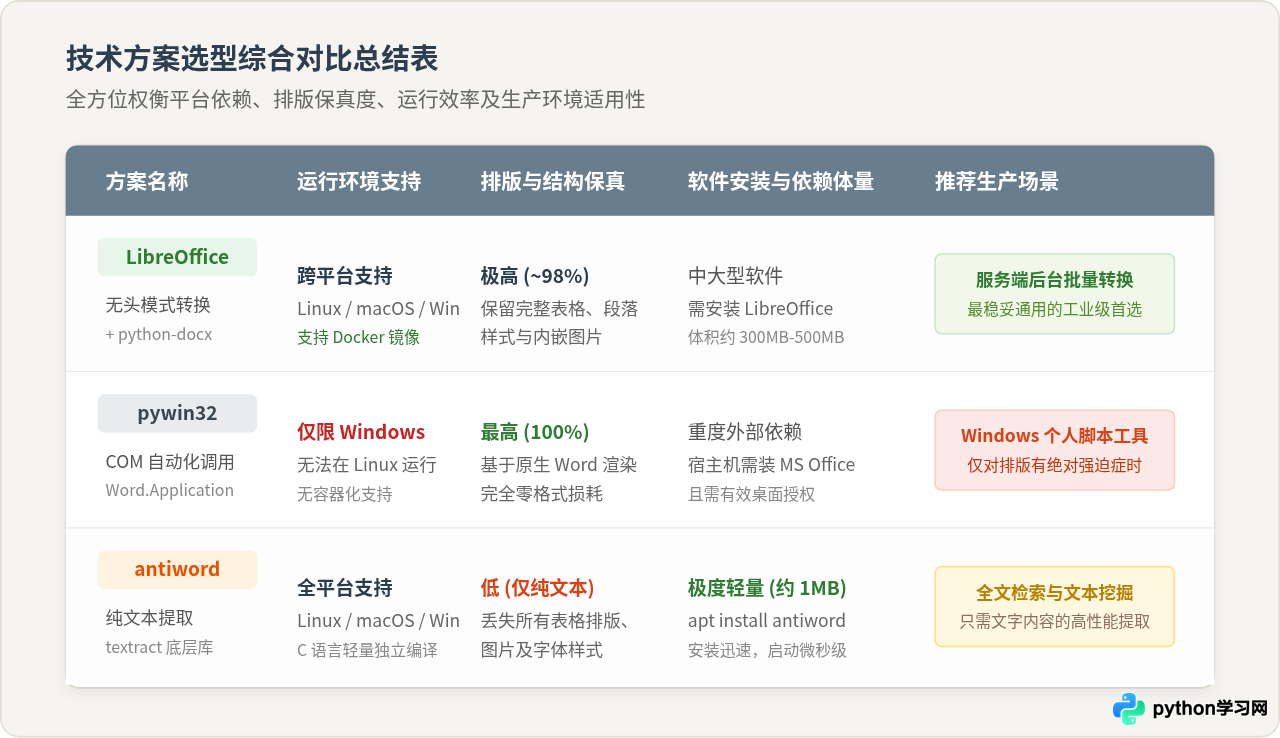
在真实业务选型中,没有绝对最优的技术,只有与基础架构最契合的方案。下表梳理了各处理方案的关键评估指标:
最终实施建议
- Linux 云服务器与容器化服务:优先选用“LibreOffice Headless + python-docx”的组合。该方案兼具跨平台、零授权费用和对表格样式的极高保真度,配合 Docker 镜像打包,能够在 CI/CD 和云端稳定扩容。
- 内部运营工具与个人 Windows 脚本:如果只在办公电脑本地运行,且对字体、公式排版有完全苛刻的 100% 还原要求,可使用
pywin32。但务必通过try...finally严密包裹进程清理代码。 - 高性能数据挖掘与文本搜索:如果只需提取文本内容,且目标机器无法承载上百兆的办公软件运行时,应果断选择
antiword,以最小资源消耗实现极速抽取。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









