

python必背源代码路径拼接os.path代码
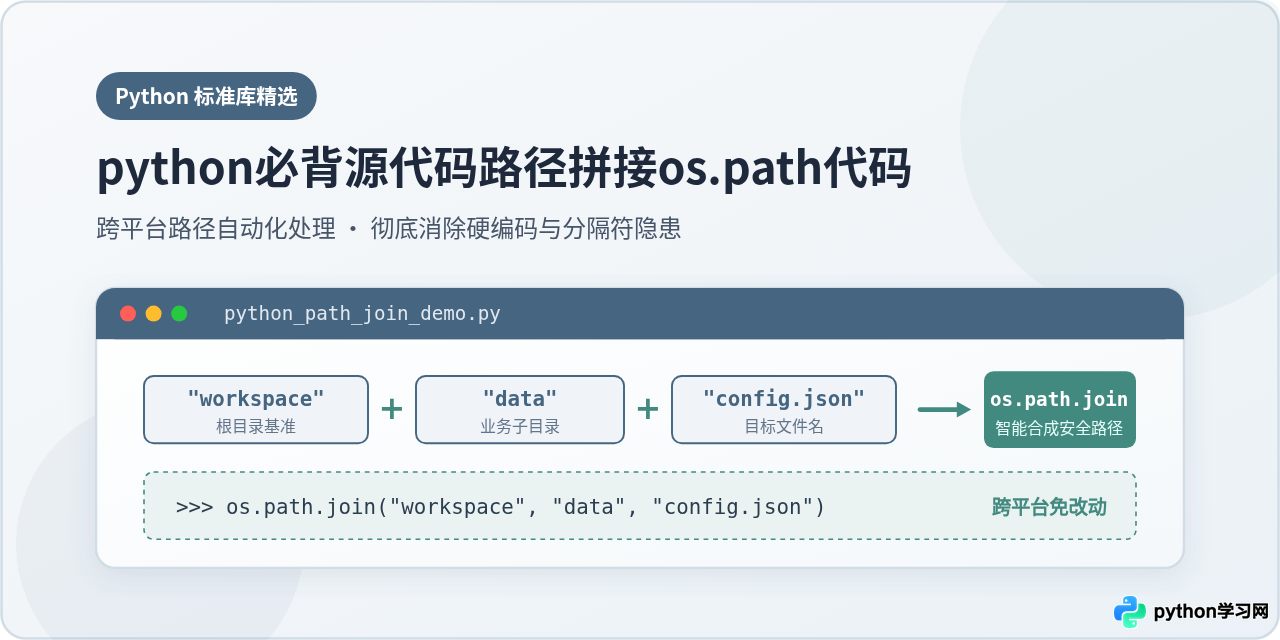
完整解析Python标准库os.path路径拼接必背源代码与工程使用范式。涵盖os.path.join跨平台机制、绝对路径覆盖规则、基于__file__的项目根目录动态锚定,以及避免硬编码路径的避坑指南。
\)而 Linux 与 macOS 采用正斜杠(/),硬编码字符串拼接极易引发跨平台报错或多斜杠逻辑漏洞。本文直接给出 os.path.join 的核心必背源代码模板,系统剖析其跨平台拼接原理、绝对路径覆盖机制,以及在工程项目中基于 __file__ 的标准目录锚定范式。
一、os.path.join 核心代码速查与基础拼接
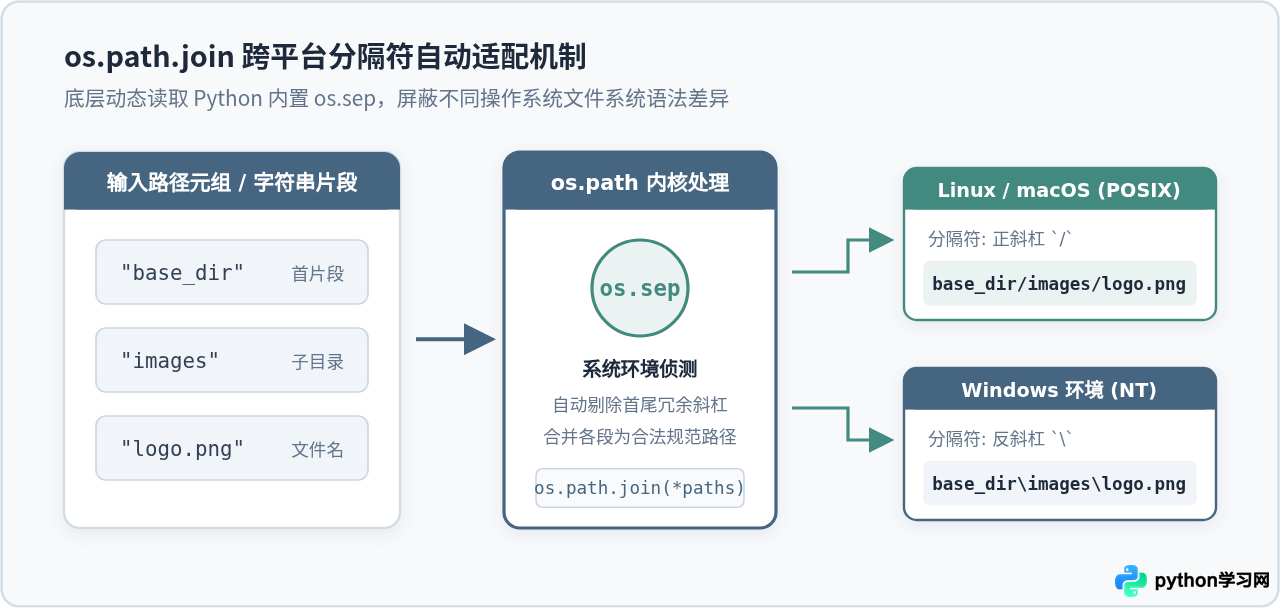
进行路径拼接时,标准做法是通过 import os 引入标准库,并直接使用 os.path.join() 接收多个路径段字符串。它能自动识别当前运行宿主的系统分隔符,将零散的文件夹名与文件名整合为合规的路径。
1. 最简必背基础源代码
import os

# 1. 基础多参数拼接
folder_path = "workspace"
sub_folder = "dataset"
filename = "records.csv"

# 核心代码:传入任意数量的路径片段
full_path = os.path.join(folder_path, sub_folder, filename)

print("拼接生成的路径为:", full_path)
# 在 Linux / macOS 下输出示例: workspace/dataset/records.csv
# 在 Windows 环境下输出示例: workspace\dataset\records.csv
os.path.join 能够接收任意数量的位置参数。当传入多个参数时,函数会按从左到右的顺序逐级组装。对于初学者常犯的“末尾是否需要自带斜杠”问题,os.path.join 具备自动容错能力:无论片段本身是否带有前导或尾随分隔符,它都能保证拼接处仅保留单个合法的系统分隔符。
2. 列表/元组参数解包拼接技巧
当路径层级由动态列表配置提供时,可以使用 Python 的参数解包运算符 * 进行拼接,这是数据分析与批处理脚本中的高频必背写法:
import os

# 路径层级保存在列表或元组中
path_nodes = ["project", "logs", "2026", "audit.log"]

# 通过 * 语法解包后传入 os.path.join
log_file_path = os.path.join(*path_nodes)
print("动态解包拼接结果:", log_file_path)
# 示例输出: project/logs/2026/audit.log
二、执行机制与绝对路径覆盖规则(必背核心避坑点)
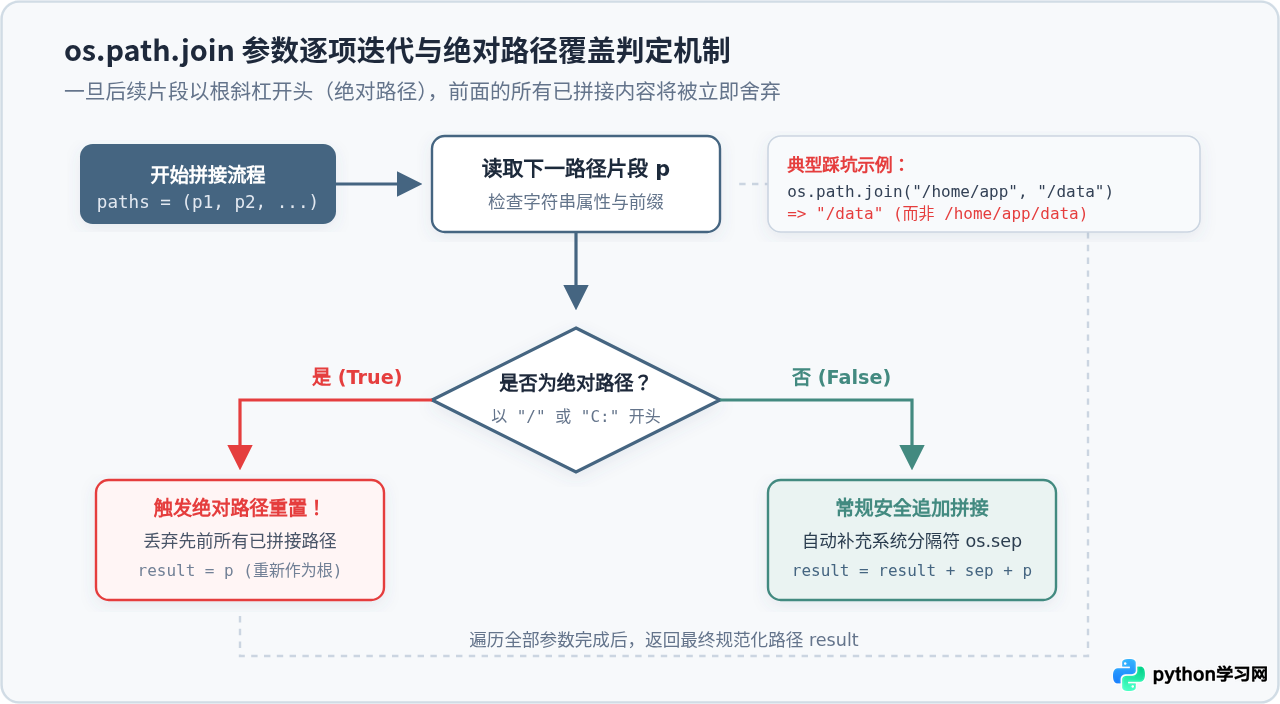
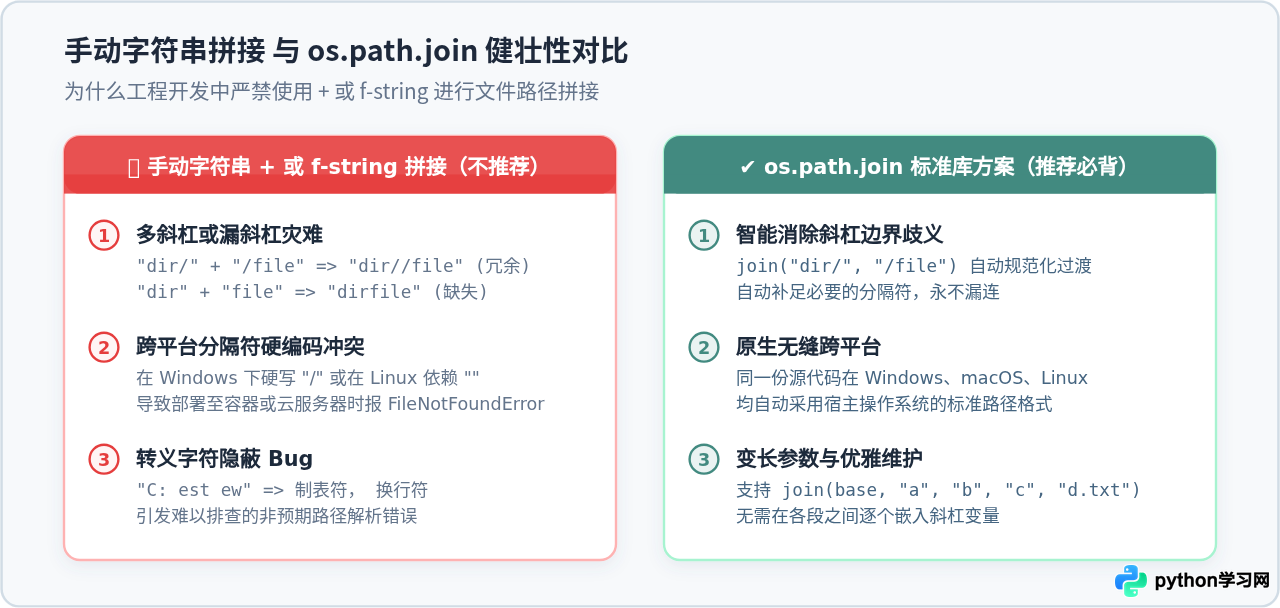
在使用 os.path.join 时,最容易造成严重程序缺陷的机制是“绝对路径重置行为”。官方设计规范规定:在拼接过程中,一旦某个参数被判定为绝对路径(例如在 Linux/macOS 下以 / 开头,或在 Windows 下带有盘符或反斜杠开头),os.path.join 会立即丢弃此前累积拼接的所有前序路径,直接从该绝对路径重新开始向后拼接。
1. 绝对路径覆盖陷阱代码复现
import os

base_dir = "/var/www/my_project"
sub_dir = "/uploads"  # 注意:这里错误地添加了前导根斜杠 "/"
target_file = "avatar.png"

# 错误直觉预期: /var/www/my_project/uploads/avatar.png
result_path = os.path.join(base_dir, sub_dir, target_file)

# 真实返回结果: https://img.ipython.cn/uploads/avatar.png (前面的 base_dir 被彻底清空舍弃!)
print("实际生成路径:", result_path)/。若数据源来自配置文件或前端输入,建议先使用 sub_dir.lstrip("/\\") 过滤掉前导斜杠,以防止基础路径被意外冲刷。
2. 参数特征与返回规律速查
| 拼接调用示例 | POSIX 系统返回结果 | 规则解析 |
|---|---|---|
os.path.join("a", "b", "c") |
a/b/c |
标准相对路径顺序连接 |
os.path.join("a", "/b", "c") |
/b/c |
/b 为绝对路径,前面的 a 被完全废弃 |
os.path.join("a/b/", "c") |
a/b/c |
自动消除重复斜杠,保持单个分隔符 |
os.path.join("a", "") |
a/ |
末尾为空字符串时,保留末尾目录分隔符 |
三、工程实战必背范式:基于 __file__ 动态锚定项目路径
初学者常直接使用相对路径 os.path.join("data", "config.json") 读取文件。这种写法依赖当前终端的工作目录 os.getcwd()。一旦用户在项目根目录之外启动脚本(例如通过 Crontab 定时任务、系统服务或在父级文件夹运行 python sub/run.py),程序就会抛出 FileNotFoundError。
工程级开发中,必须使用当前代码脚本自身所在的物理位置(__file__)作为基准锚点,动态反推项目根路径。
1. 定位当前文件所在目录与上一级根目录
import os

# 1. 获取当前正在执行的 Python 脚本的绝对路径
CURRENT_FILE = os.path.abspath(__file__)

# 2. 获取当前脚本所在目录
CURRENT_DIR = os.path.dirname(CURRENT_FILE)

# 3. 向上获取父级目录(假设项目根目录位于脚本上一级)
PROJECT_ROOT = os.path.dirname(CURRENT_DIR)

# 4. 安全拼接项目内部资源文件绝对路径
CONFIG_FILE = os.path.join(PROJECT_ROOT, "configs", "settings.ini")
STORAGE_DIR = os.path.join(PROJECT_ROOT, "runtime", "cache")

print("当前脚本绝对位置:", CURRENT_FILE)
print("工程根目录绝对定位:", PROJECT_ROOT)
print("目标配置文件绝对路径:", CONFIG_FILE)settings.py)顶部预先定义好 BASE_DIR = os.path.dirname(os.path.abspath(__file__)),后续所有文件读写均基于 BASE_DIR 进行拼接,实现全局路径零硬编码。
四、路径组合拳:拼接、目录自建与拆分实用库
实际开发中,路径拼接通常需要与目录验证(os.path.exists)、递归创建(os.makedirs)以及路径解析(os.path.splitext)协同运作,形成一条健壮的文件操作流水线。
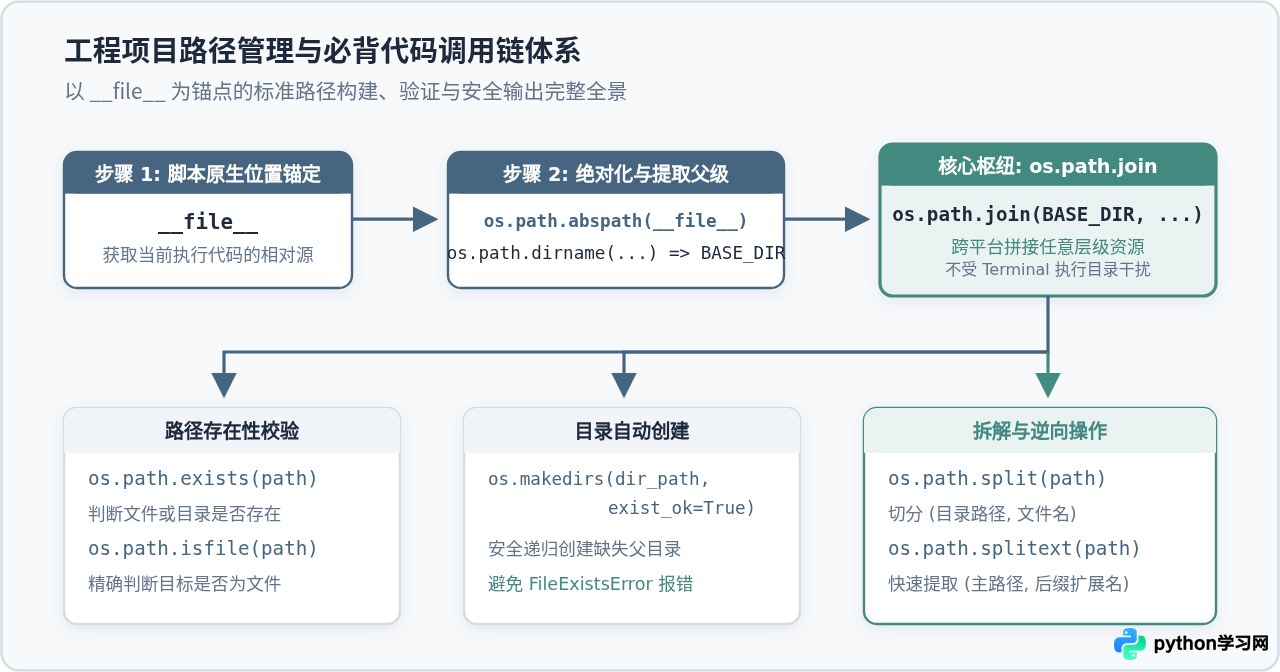
1. 拼接并自动保证父目录存在(防止写入失败)
import os

def prepare_output_file(base_folder, sub_name, file_name):
    """拼接目标文件路径,并自动确保其所在父级目录已成功创建"""
    # 步骤一:安全拼接完整文件路径
    target_path = os.path.join(base_folder, sub_name, file_name)

    # 步骤二:提取出该文件所在的目录部分
    parent_dir = os.path.dirname(target_path)

    # 步骤三:若目录尚不存在,则自动递归建立多级目录
    if not os.path.exists(parent_dir):
        # exist_ok=True 避免并发冲突引发 FileExistsError
        os.makedirs(parent_dir, exist_ok=True)
        print(f"成功新建缺失目录: {parent_dir}")

    return target_path
2. 路径解析与后缀分离函数
在对已拼接完成的路径进行后处理时,以下几个函数常与 os.path.join 成对出现:
os.path.split(path):将路径拆分为(目录名, 文件名)二元组。os.path.splitext(path):将文件名与扩展名拆分为(主路径, .扩展名),便于更换后缀或校验格式。os.path.normpath(path):标准化路径格式,消除冗余的./和../跳转层级。
五、直接复用的生产级路径处理完整模板
以下给出一段可直接复制到任何 Python 项目中的综合模板。该代码示范了从环境基准锚定、目录自愈到安全读写的完整闭环:
import os

# ==========================================
# 1. 项目基准路径全局锚定 (必背经典写法)
# ==========================================
# 消除执行位置对相对路径的破坏
SCRIPT_DIR = os.path.dirname(os.path.abspath(__file__))
APP_ROOT = SCRIPT_DIR  # 若脚本在子目录,可套用两层 os.path.dirname

# ==========================================
# 2. 声明业务各模块的标准文件路径
# ==========================================
LOG_DIR = os.path.join(APP_ROOT, "logs")
DATA_DIR = os.path.join(APP_ROOT, "data", "processed")
OUTPUT_FILE = os.path.join(DATA_DIR, "export_result.txt")

# ==========================================
# 3. 目录检查与自动化初始化
# ==========================================
def ensure_directories():
    for folder in [LOG_DIR, DATA_DIR]:
        if not os.path.exists(folder):
            os.makedirs(folder, exist_ok=True)
            print(f"[初始化] 目录就绪: {folder}")

def write_sample_data(filepath, content):
    # 提取目录并确保安全
    directory = os.path.dirname(filepath)
    if not os.path.exists(directory):
        os.makedirs(directory, exist_ok=True)

    with open(filepath, "w", encoding="utf-8") as f:
        f.write(content)
    print(f"[写入成功] 文件保存至: {filepath}")

if __name__ == "__main__":
    ensure_directories()
    sample_text = "Python os.path.join 标准工程范式测试成功。"
    write_sample_data(OUTPUT_FILE, sample_text)

    # 校验输出
    if os.path.isfile(OUTPUT_FILE):
        file_size = os.path.getsize(OUTPUT_FILE)
print(f"[结果校验] 确认文件有效生成,大小: {file_size} 字节")免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









