

为什么企业级系统多用Java而AI领域首选Python
很多开发者在选择技术栈时常有疑问:编程语言本无优劣之分,为什么在庞大的企业级业务系统中,Java 几乎占据统治地位,而在近些年爆发的人工智能与深度学习领域,Python 却成了绝对的第一首选?这一局面的形成,根本原因不是语法谁更简短,也不是运行谁更快,而是两类业务的“核心矛盾”截然不同:企业级系统追求大规模工程协作中的确定性、高吞吐与长期稳定性,而 AI 领域追求的是算法快速假设验证、敏捷数据探索与底层高性能计算的灵活胶水粘合。
一、核心目标的本质差异:大规模工程协作 vs 快速算法探索
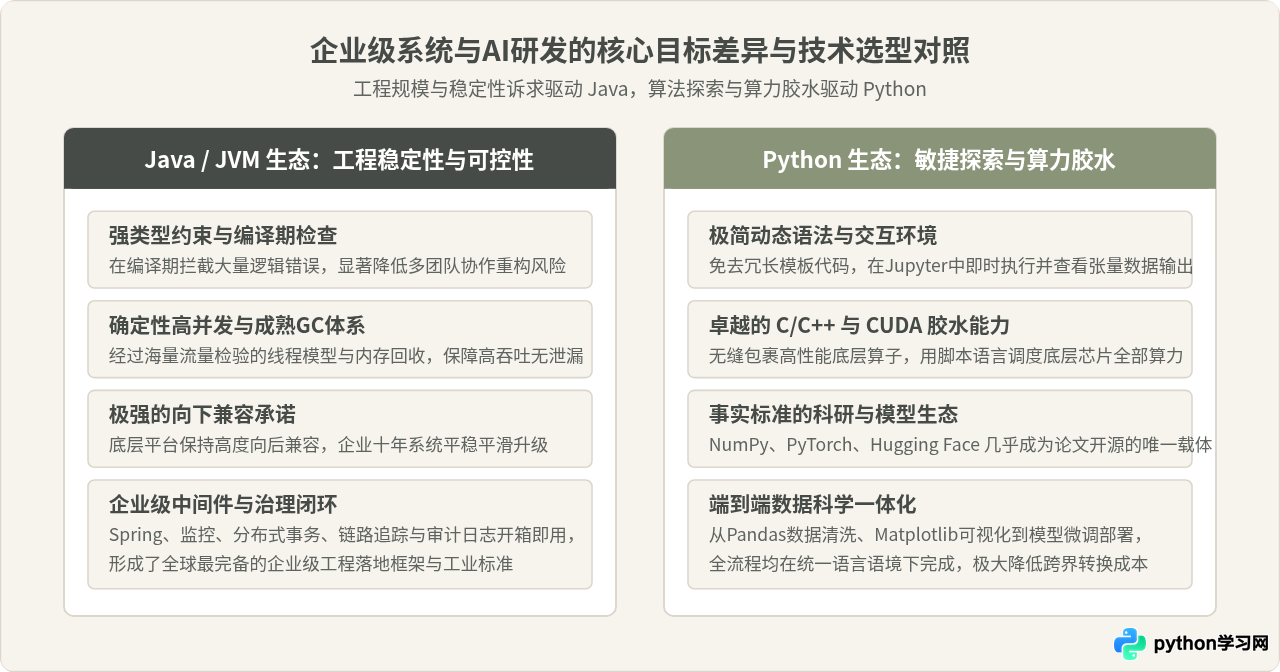
企业级系统(如银行核心账务、电商交易中枢、供应链 ERP 系统)往往由跨地域的数十甚至数百名工程师共同研发,代码生命周期长达五年乃至十年以上。在这种场景下,代码的“可维护性”和“重构安全性”远高于“编写时的输入速度”。Java 的静态强类型系统与编译期检查,在代码交付运行前就能拦截绝大部分拼写错误、类型不匹配和空指针漏洞。严格的接口规范和访问权限约束,使得庞大的团队即便在人员频繁更迭的情况下,也能以较低的心智负担理解系统边界。
相反,AI 研发的核心过程高度依赖“实验与探索”。研究人员在训练模型时,关注的是网络结构设计、超参数调整、损失函数变化以及张量维度的变换。他们需要快速得到反馈,在交互式笔记本(如 Jupyter Notebook)中实时执行代码、观察特征分布。如果每次改动几行矩阵维度都要经历静态类型声明和整包编译,探索效率将大打折扣。Python 的动态类型、解释型执行与极其简练的语法,天然适配这种短周期、高频次的算法试错流程。
二、性能认知的澄清:Python运行慢,为什么还能跑性能极致的AI?
日常交流中常有这样一种认知误区:“Python 解释执行速度慢,还有全局解释器锁(GIL),怎么可能撑得起算力要求极高的 AI 模型?”
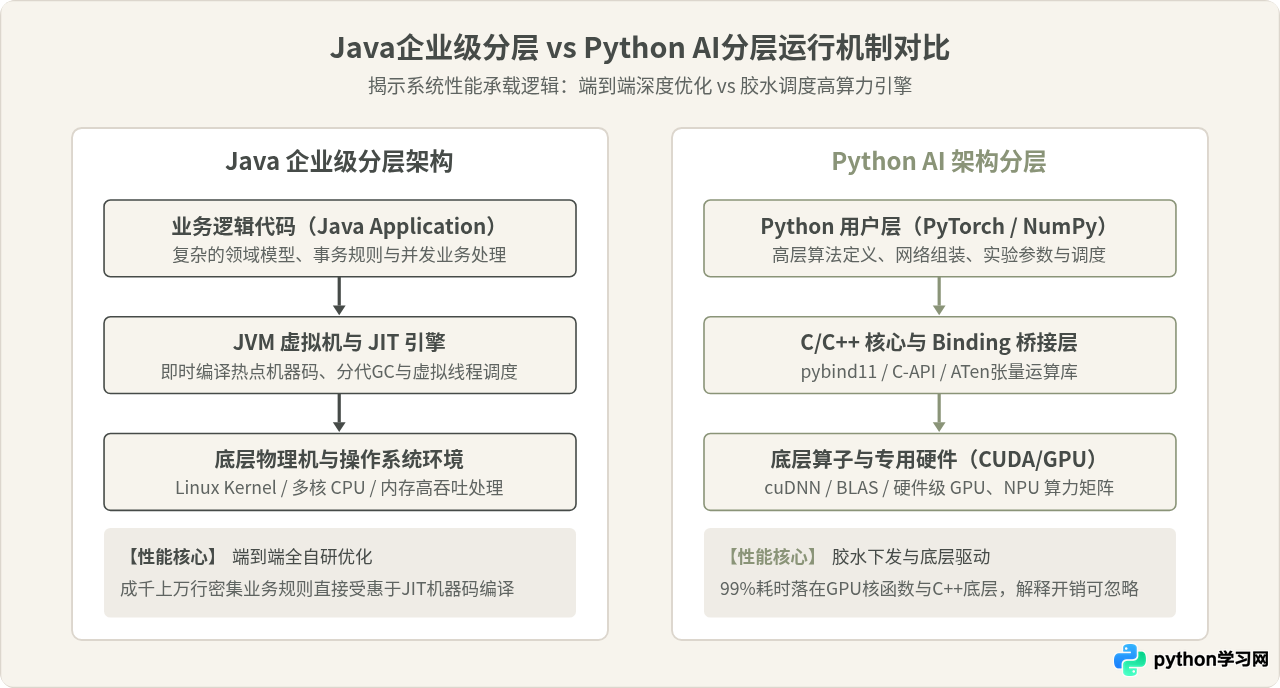
这种说法看似合理,但混淆了控制面(Control Plane)与数据计算面(Data Plane)。在典型的 AI 工作负载中,真正消耗 99% 计算资源的是矩阵乘法、卷积运算与梯度更新。这些底层运算并不是由纯 Python 代码逐行循环解释执行的,而是由高度优化的底层 C/C++、Fortran 以及直接面向 GPU 的 CUDA/cuDNN 库完成的。例如:
numpy.dot(a, b)调用的是高度优化的 OpenBLAS、MKL 或 LAPACK 等底层线性代数库;torch.matmul(x, w)最终下发为 GPU 上的 CUDA 内核指令,由 Tensor Core 硬件并行计算。
在这个体系中,Python 的角色是一个“高效率的调度员”与“胶水层”。它负责将数据张量装载进内存或显存,调用底层计算引擎,并在计算完成后接收结果。即便 Python 本身存在微秒级的解释开销,在长达数毫秒乃至数秒的高密度张量运算面前几乎可以忽略不计。
与此相对,Java 在企业级系统中的性能逻辑截然不同:企业级系统充斥着成千上万个密集的业务分支判断、对象组装、数据转换与数据库 I/O 交互。这种业务逻辑无法卸载给外部底层硬件,只能由主机 CPU 逐行运行。JVM 通过 HotSpot 即时编译器(JIT)、分代内存管理和高度优化的无锁/细粒度锁机制,能够将热点字节码直接编译为机器码,提供长期持续的高吞吐与低延迟表现。
三、生态护城河的形成与不可替代性
技术选型从来不是单纯的技术参数评测,而是生态协同效应的结果。一旦某种语言在特定领域建立了先发优势并形成飞轮效应,替换成本将变得极其高昂。
1. Java 在企业级系统中的护城河
企业级开发的核心挑战是处理错综复杂的数据一致性与合规性。Java 生态在此沉淀了整套工业级基础设施:
- 全链路中间件支持:Spring 框架、Hibernate/MyBatis 数据持久层、Apache Dubbo RPC 体系,以及针对 Kafka、RocketMQ、Elasticsearch 等底层组件的第一优先级官方客户端与驱动。
- 完善的诊断运维工具:从 JVM 内部的 JMX、Arthas 动态诊断,到 Prometheus、SkyWalking、Zipkin 等分布式链路追踪方案,生产环境排查复杂死锁、内存泄露具备极强的可视性与确定性。
- 企业级人才供给池:市场上具备大型项目分布式治理经验的 Java 工程师基数庞大,企业团队容易招聘、组建和快速扩编。
2. Python 在 AI 领域的护城河
AI 领域的发展经历了从传统的学术研究向工业界转化的历程。在这个过程中,Python 形成了不可逆转的飞轮:
- 学术界与开源标准:全球顶尖学术会议(如 NeurIPS、ICLR、CVPR)的论文代码,95% 以上直接提供 Python(主要是 PyTorch)实现。若选择其他语言,意味着无法直接复现最新研究成果。
- 端到端数据科学工具链:从数据的清洗过滤(Pandas)、矩阵数学变换(NumPy)、探索性绘图(Matplotlib/Seaborn),再到模型训练(PyTorch/TensorFlow)与轻量接口服务(FastAPI),全套工具链在统一语言中无缝流转。
- 现代大模型生态:以 Hugging Face(Transformers、Datasets、Diffusers)为代表的开源平台全面绑定 Python,使得开发者仅需数行代码即可加载千亿级预训练模型。
四、技术选型推导:从业务诉求到语言决策的判断路径
在面对一个新项目或系统重构时,技术负责人不应当仅凭个人喜好做决策,而应从系统核心诉求出发,按照系统化的推导步骤进行定型:
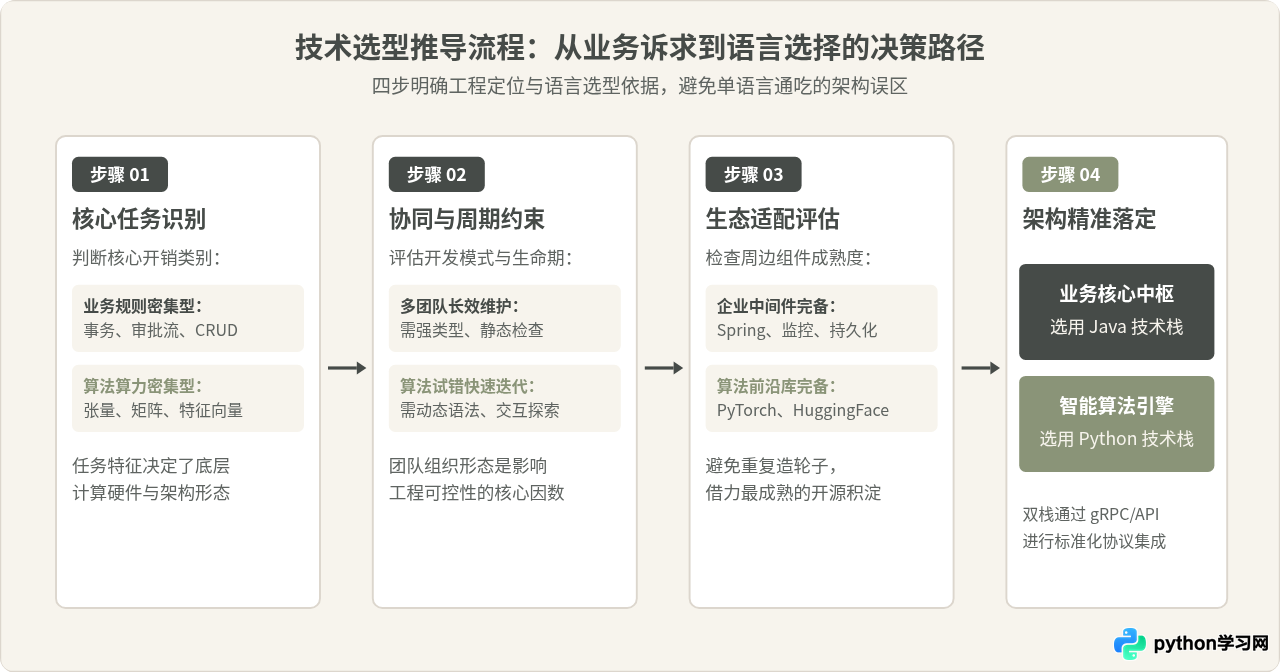
- 评估核心任务与瓶颈特征:系统是强业务规则逻辑(状态机、审批流、财务记账、订单事务),还是强矩阵与非结构化数据计算(向量检索、多模态处理、模型微调)?
- 评估团队协作与生命周期:是数十人跨部门长期维护的大型交付物,还是研究团队快速验证算法假说的试验品?
- 评估生态工具成熟度:对应领域的核心开源库是成熟的 Java 中间件,还是由学术界高度驱动的 Python AI 库?
- 确立分层边界与架构模式:如需同时满足业务流转与算法推理,应果断采用“双引擎微服务架构”,而不是强行用一种语言包打天下。
五、现代架构的协同模式:Java 与 Python 的工程互补
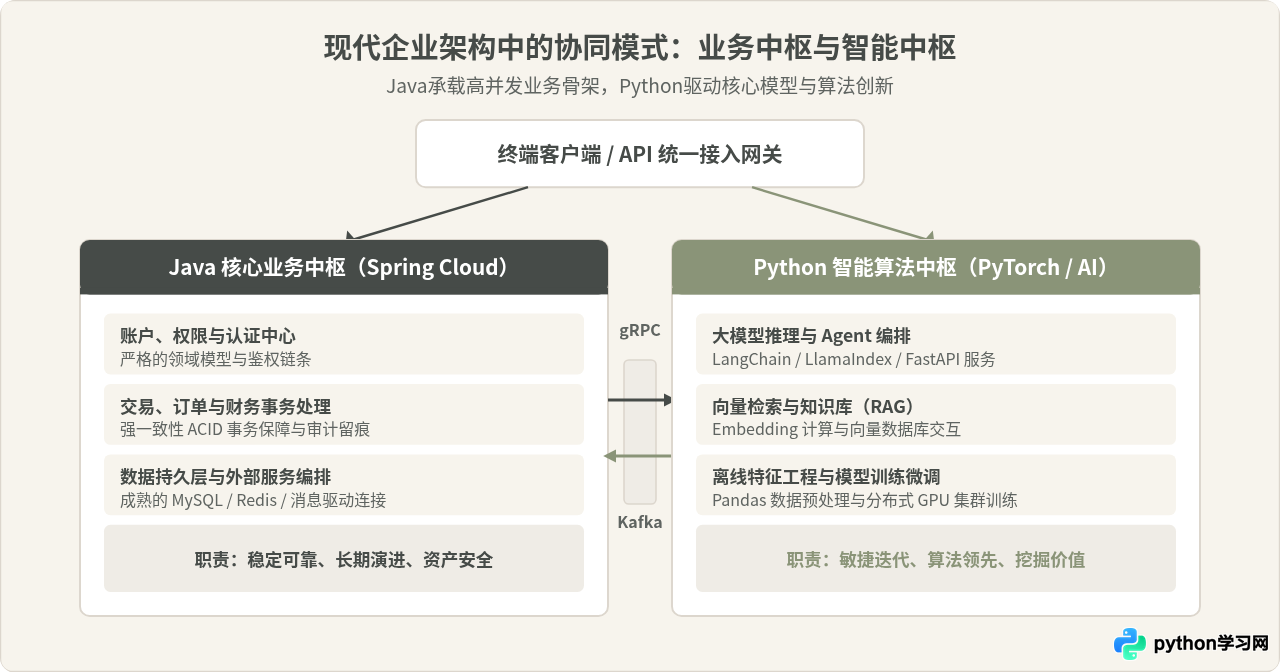
在当下的企业级智能化(AI-Native)系统建设中,Java 与 Python 并非非此即彼的对立关系,而是分工明确的协作搭档。典型的现代化大型系统架构通常表现为:
- Java 负责“业务骨架”:承担用户请求接入、权限鉴权、复杂业务逻辑校验、分布式事务一致性控制、主数据库事务写入以及事件发布。
- Python 负责“智能中枢”:承担离线数据处理与特征提取、模型训练与微调、在线大模型推理、知识库向量检索(RAG)以及 Agent 决策链路。
- 标准化集成接口:Java 服务与 Python 服务之间通过高性能
gRPC、标准REST API或Kafka异步消息队列进行通信,实现两者的低耦合、高内聚集成。
工程落地的关键建议:在模型线上部署阶段,如果推理并发要求极高且延迟敏感,业界通常会在 Python 中完成训练后,将模型导出为 ONNX 或 TensorRT 格式,并借助 C++ 或高性能推理服务器(如 Triton Inference Server)对外提供服务。这种模式下,Java 继续负责业务编排,Python 专注算法创新,系统各司其职,达到工程效率与计算性能的最佳平衡。
六、核心总结与选型对照
回顾两者在行业中的定位分工,我们可以通过下表做清晰的对照与复盘:
| 对比维度 | Java 在企业级系统中的表现 | Python 在 AI 领域中的表现 |
|---|---|---|
| 核心任务 | 承载复杂多变的业务流程、事务一致性与高吞吐业务请求 | 算法假说快速验证、数学张量计算、模型训练与前沿探索 |
| 类型机制 | 静态强类型,编译期捕获绝大多数类型错误,重构风险极低 | 动态弱约束,语法极其简短,便于交互式探索与即时计算 |
| 性能模型 | HotSpot JIT 深度优化业务字节码,多线程与内存管理稳定可靠 | 作为顶层胶水调度,底层依赖高度优化的 C/C++ 与 CUDA 算子 |
| 生态壁垒 | Spring 体系、企业级消息队列、分布式监控与全链路审计工具链 | NumPy、PyTorch、Hugging Face 与顶尖学术界绝对主流支持 |
| 协作成本 | 代码规范严谨,跨部门、跨人员流转时系统确定性与可读性高 | 研究员与工程师单兵作战或小团队效率极高,适合算法敏捷突破 |
技术选型本质上是“业务矛盾”在工具层面的映射。Java 依靠严谨的工程特质赢得了庞大企业级系统的长期信任,而 Python 则凭借灵活高效的胶水能力征服了波澜壮阔的 AI 新纪元。理解这层逻辑,能让我们在面对复杂架构决策时,不再陷入单纯的语言优劣争论,而是因地制宜、各取所长,构建出兼具稳健工程质量与强大智能驱动力的现代技术系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









