

系统底层开发选C还是应用层开发选Python
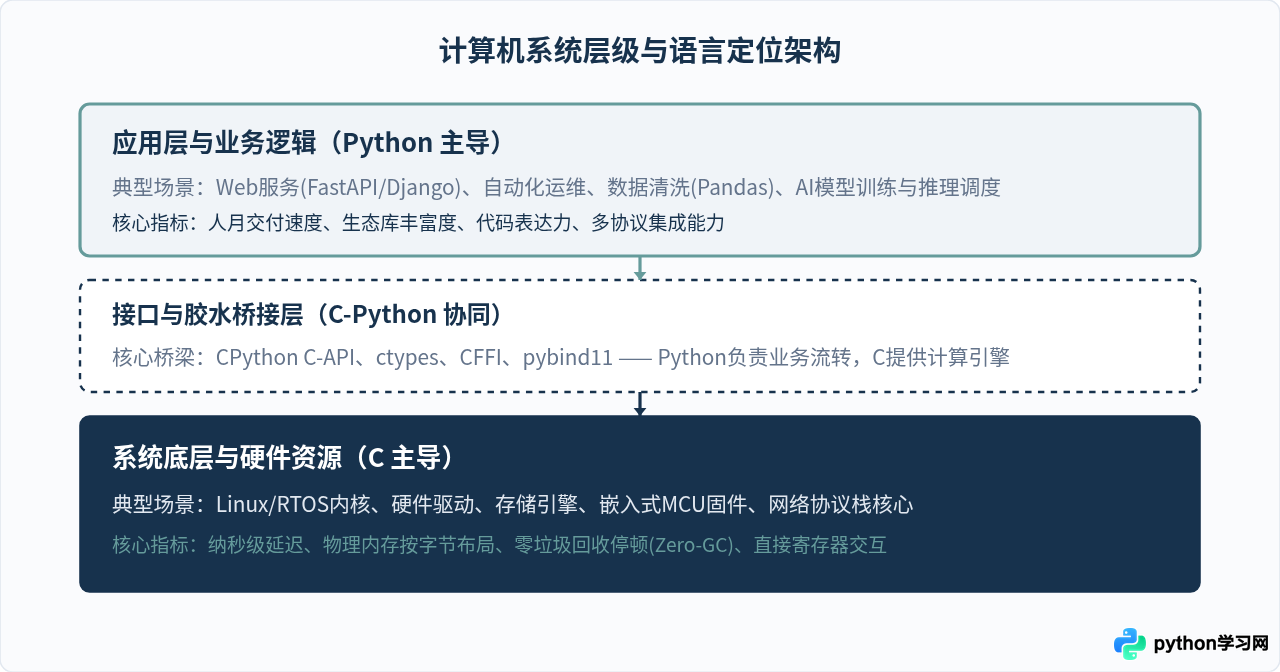
技术选型的本质是权衡“系统资源控制权”与“业务迭代交付速度”。面对系统底层开发选C还是应用层开发选Python这一问题,核心结论非常明确:若任务目标涉及直接操作硬件寄存器、管理物理内存、编写内核模块或追求微秒级确定性响应,必须选择C语言;若任务目标聚焦于数据交互、快速构建Web接口、自动化运维或人工智能流程编排,Python则是更高效的工具。而在现代工业架构中,二者往往以“C实现底层高性能核心、Python构建高层逻辑”的方式深度共存。
一、系统层级视角的边界划分
计算机软件系统存在清晰的抽象分层。距离硬件越近,系统所承受的资源限制越苛刻,对实时性与控制精度的要求越高;距离用户与业务越近,需求变更越频繁,对开发效率与生态集成的依赖越强。
C语言的设计初衷是提供一种能够精确映射机器指令、同时保持结构化特性的系统编程工具。它不提供自动内存回收机制,没有隐式运行时开销,编译生成的二进制直接在宿主环境裸跑。这种特性使其牢牢占据了操作系统内核、设备驱动程序、嵌入式微控制器(MCU)固件以及高性能通信底座。
Python则处于系统的应用层与胶水层。它通过高度抽象的动态类型系统和完备的标准库,隐藏了内存指针、堆栈分配及底层调用规约等物理细节。开发者通过少量代码即可组织复杂的数据流,因此在企业级API开发、数据分析与计算编排等领域具有决定性优势。
二、核心机制与执行原理对比
选择C还是Python,最根本的技术动因源自二者在代码执行原理与内存模型上的截然不同。
1. C语言的确定性内存控制与直接执行
C语言经过预编译、编译、汇编与链接四个阶段,直接将源代码翻译为目标处理器的原生机器码。变量在栈上分配还是在堆上分配由程序员显式决定。结构体的字段内存对齐可以精细到单个比特位,这使得C语言能够精准映射外设硬件状态寄存器或网络帧报文头。
/* C 语言直接映射硬件寄存器与结构体示例 */
#include <stdint.h>
#include <stdio.h>

/* 模拟硬件状态寄存器:无隐式字节开销,精准映射物理比特位 */
typedef struct {
    uint32_t enable     : 1;  /* 第0位:使能控制 */
    uint32_t ready      : 1;  /* 第1位:就绪标志 */
    uint32_t mode       : 2;  /* 第2-3位:工作模式 */
    uint32_t reserved   : 28; /* 保留位 */
} __attribute__((packed)) HardwareRegister;

int main(void) {
    uint32_t mock_memory = 0x00000003; /* 模拟外设映射地址 */
    HardwareRegister *reg = (HardwareRegister *)&mock_memory;

    printf("[C 输出] 使能状态: %u, 就绪状态: %u, 占用内存: %zu 字节\n",
           reg->enable, reg->ready, sizeof(HardwareRegister));
    return 0;
}
编译与执行命令(Linux / macOS):
$ gcc -O2 -Wall memory_demo.c -o memory_demo
$ ./memory_demo
[C 输出] 使能状态: 1, 就绪状态: 1, 占用内存: 4 字节
2. Python的动态对象系统与字节码解释
与C语言直接操作物理内存不同,标准CPython实现中,哪怕是一个简单的整数 a = 1,在底层都是一个完整的 PyLongObject C结构体,包含引用计数、类型指针和变长数字数组,在64位机器上往往占用28字节甚至更多。Python通过虚拟机(PVM)逐条解释执行字节码,并通过引用计数与分代垃圾回收器管理内存释放。这彻底消除了段错误(Segmentation Fault)和内存泄漏的低级风险,但必然伴随运行时开销与不确定的GC停顿。
# Python 快速组织数据与业务逻辑示例
import sys

# 业务数据结构:字典与列表快速组织复杂逻辑
device_state = {
    "device_id": "sensor-node-01",
    "is_online": True,
    "metrics": [23.4, 23.8, 24.1],
}

print(f"[Python 输出] 设备: {device_state['device_id']}, "
      f"平均读数: {sum(device_state['metrics'])/len(device_state['metrics']):.2f}")
print(f"[Python 内部开销] 纯整数 1 的内存占用: {sys.getsizeof(1)} 字节")
执行命令:
$ python3 app_demo.py
[Python 输出] 设备: sensor-node-01, 平均读数: 23.77
[Python 内部开销] 纯整数 1 的内存占用: 28 字节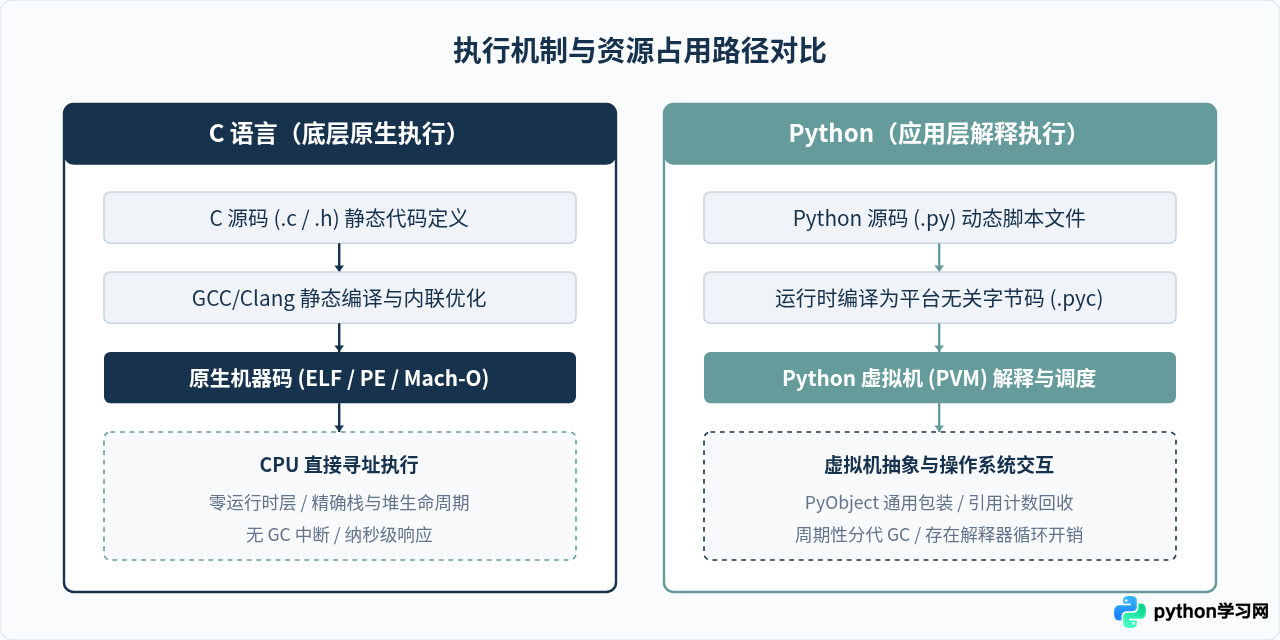
三、技术选型的4步评估法
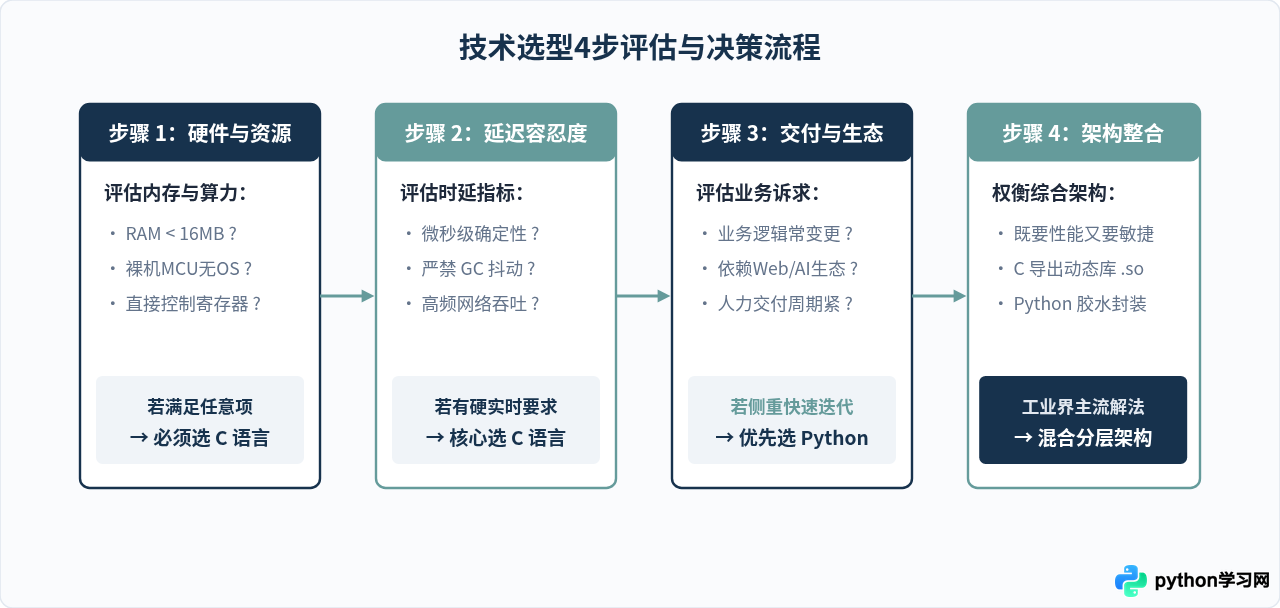
面对具体工程项目或技术发展路径,可以通过以下4个具体步骤进行系统评估,从而得出清晰的选型结果:
- 步骤一:核验物理运行环境与资源上限
检查运行设备的内存规模与系统支撑。若目标设备是资源极度受限的单片机(例如RAM小于256KB的STM32芯片)、无MMU(内存管理单元)的裸机环境,或者直接与物理中断向量表交互,Python解释器本身数十兆的内存底线无法满足,必须选C。
- 步骤二:度量延迟与抖动容忍度
确认业务对响应时间的硬性约束。如果系统要求每一次操作在10微秒内完成,且绝不允许由于垃圾回收造成1毫秒以上的不可控抖动(如工业PLC控制、高频交易撮合内核),选C是唯一合规方案;若系统响应在10毫秒到100毫秒即可满足业务(如常规RESTful请求),Python的执行损耗完全可被接受。
- 步骤三:评估业务迭代频率与生态支持
若系统主要处理的是不断变化的业务规则、与第三方SaaS平台的JSON对接,或是利用机器学习算法分析日志,使用C语言需要手动处理HTTP协议编解码与JSON序列化,代码量通常是Python的数倍甚至数十倍。在此场景下,Python拥有丰富的现成框架,能极大压缩人力与交付周期。
- 步骤四:确认系统边界并制定协作策略
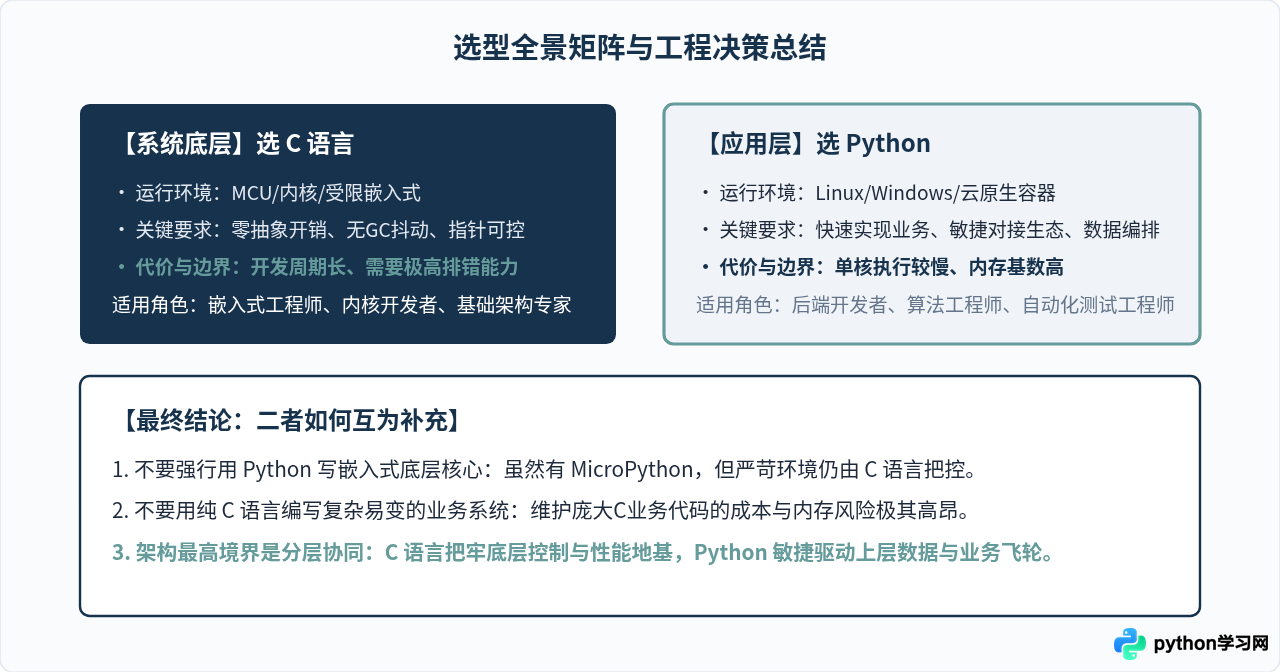
不要将C与Python割裂对立。如果工程兼具“密集数据计算/设备通信”与“上层接口呈现”,最优实践通常是架构分层:使用C语言编写高性能动态链接库(.so或.dll),对外暴露C规范接口;上层采用Python通过
ctypes直接加载调用,兼得两者的核心优势。
四、典型场景选型决策矩阵与协作总结
为了让不同技术背景的读者对技术选型形成确定性认知,下表列出了常见工业场景下的首选语言及关键选型考量:
| 业务与技术场景 | 推荐选型 | 决定性技术因素 | 工程典型代表 |
|---|---|---|---|
| 操作系统内核与硬件驱动 | C 语言 | 直接内存与寄存器映射、无额外运行时、完全确定性 | Linux 内核、RTOS、显卡驱动底层 |
| 高并发存储与网络引擎 | C / C++ | 极限吞吐量、对缓存局部性(Cache Line)的高度优化 | Redis 核心代码、Nginx、DPDK |
| 微控制器与嵌入式IoT节点 | C 语言 | ROM与RAM资源受限在KB级别、微秒级中断处理 | FreeRTOS 固件、传感器采集固件 |
| Web API 与微服务中台 | Python | 快速原型验证、多协议适配、健全的ORM与中间件生态 | FastAPI、Django、Flask |
| 人工智能与科学计算调度 | Python (底层C/C++) | 顶层张量编排极简,底层自动路由至C/CUDA算子执行 | PyTorch、TensorFlow、NumPy |
| 自动化测试与系统监控脚本 | Python | 即写即测、跨操作系统兼容性良好、标准库开箱即用 | Ansible 模块、Pytest、系统运维巡检 |
五、注意事项与易混淆点
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









