

Python人工智能开发用什么框架?TensorFlow与PyTorch解析

一、核心分水岭:动态计算图与静态图机制
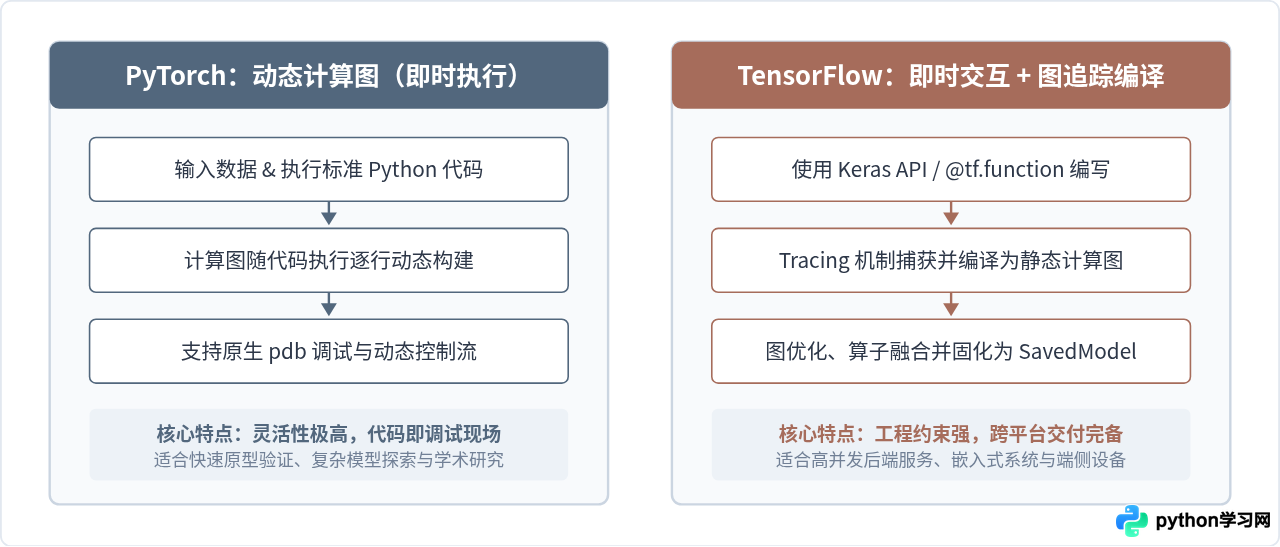
探讨这两个框架的差异,最根本的切入点是它们构建与运行数学计算图的方式。在深度学习中,神经网络的本质是一系列由张量(Tensor)组成的数学运算图。如何构建这个图,直接决定了开发者的编码心智模型和排错难度。
PyTorch采用的是动态计算图(Define-by-Run)模式。在Python执行代码的每一行时,计算图伴随运算即时构建。这意味着开发者可以把PyTorch的张量当成增强版的NumPy数组,在前向传播逻辑中自由使用Python原生的条件判断(if/else)和循环(for/while)。更重要的是,当程序出现逻辑偏差或运行时异常时,可以直接在代码中插入原生的Python断点工具(如pdb或breakpoint()),单步检查每一个张量的形状和数值。
TensorFlow在1.x时代采用纯粹的静态计算图(Define-and-Run),需要先用符号完整声明网络架构,再建立Session并装填数据执行。这种模式给工业运行时优化带来了极大的便利,但调试难度极高,报错堆栈往往脱离具体的业务代码。虽然TensorFlow 2.x彻底将Keras整合为核心API并默认启用了Eager Execution(即时执行),但其底层的设计重心依然侧重于通过@tf.function注解将Python函数追踪编译为独立于运行时的Graph,以便导出为跨语言执行的SavedModel。
二、开发与调试实战:代码风格与心智负担
在日常开发中,代码组织方式直接影响代码的可读性和维护成本。我们可以通过一个经典的全连接分类模型定义与训练片段,直观感受两者的风格差异。
1. PyTorch 的面向对象与显式控制
PyTorch通常继承自torch.nn.Module,要求显式定义网络层并在forward方法中实现数据传递。训练循环同样是显式的:手动执行前向运算、计算损失、梯度归零、反向传播与优化器步进。这种写法看似代码量稍多,但每一步都完全透明、完全处于开发者的掌控之中。
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 显式构建模块
class SimpleClassifier(nn.Module):
    def __init__(self, in_features, num_classes):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(in_features, 64),
            nn.ReLU(),
            nn.Linear(64, num_classes)
        )
    def forward(self, x):
        return self.net(x)

# 2. 显式训练循环
model = SimpleClassifier(10, 2)
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=1e-3)

for data, labels in train_loader:
    optimizer.zero_grad()       # 显式梯度清零
    outputs = model(data)       # 前向传播
    loss = criterion(outputs, labels)
    loss.backward()             # 反向传播计算梯度
    optimizer.step()            # 优化器更新权重
2. TensorFlow / Keras 的高度抽象
TensorFlow 2.x主要通过Keras高级API组织模型。它提供开箱即用的Sequential容器和model.fit()封装。对于标准结构的网络,短短几行即可完成编译和训练。然而,一旦需要实现非常规的前向逻辑、多分支条件损失或对抗生成机制,开发者就必须切换到自定义tf.GradientTape与子类化重写,此时学习曲线会陡然上升。
import tensorflow as tf
from tensorflow.keras import layers, models

# 1. 声明式快速组网
model = models.Sequential([
    layers.Dense(64, activation='relu', input_shape=(10,)),
    layers.Dense(2, activation='softmax')
])

# 2. 编译模型配置
model.compile(
    optimizer='adam',
    loss='sparse_categorical_crossentropy',
    metrics=['accuracy']
)

# 3. 封装训练过程
model.fit(train_dataset, epochs=5)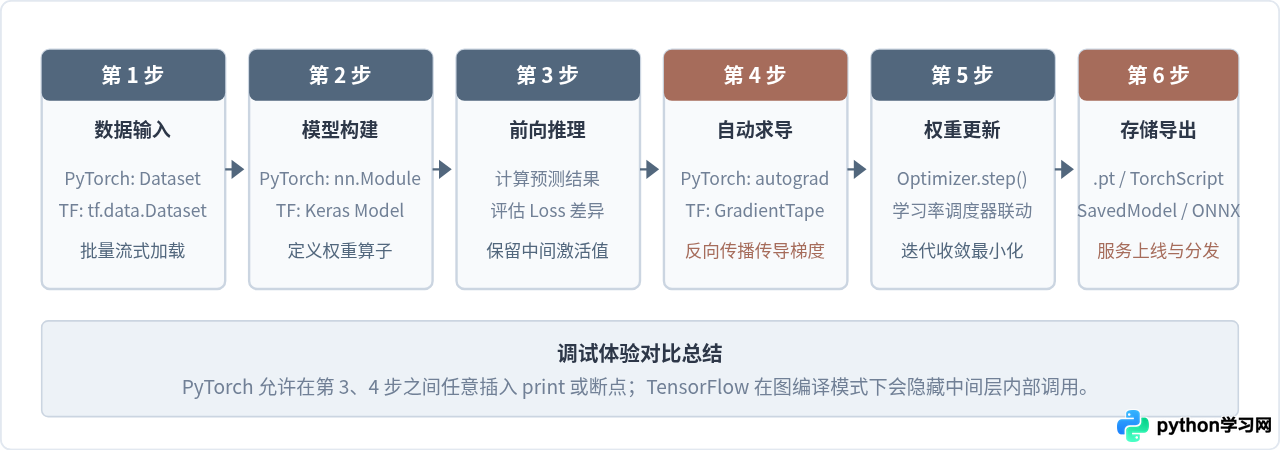
三、生态分布与前沿支持:科研与产业的真实版图
评估一个框架不仅要看语法,更要看周边配套社区的繁荣度。当我们在实际开发中需要调用现成的前沿模型、查找解决方案或招聘工程师时,生态往往起决定性作用。
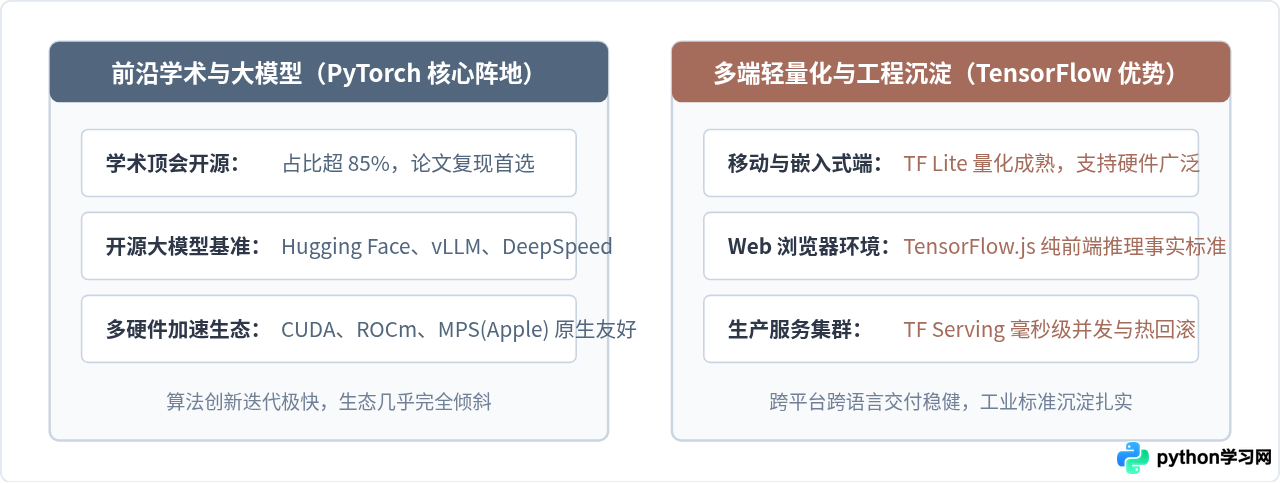
1. 学术研究与大模型(PyTorch的统治区)
目前在CVPR、NeurIPS、ICLR、ACL等全球顶级AI学术会议中,开源代码基于PyTorch的比例已经超过85%。造成这一现象的根本原因是研究人员必须频繁修改底层损失函数、自定义注意力机制或实现非常规的反向传播逻辑,PyTorch的动态执行特性降低了试错成本。
更关键的是开源大语言模型生态。以Hugging Face为代表的开源社区中,绝大部分先进模型(如Llama系列、Qwen、Mistral等)的原生权重与训练代码均基于PyTorch编写。依托Accelerate、DeepSpeed、vLLM、Megatron-LM等周边库,PyTorch已成为当今大模型训练与微调的绝对基石。
2. 工业工程与多端轻量化(TensorFlow的护城河)
TensorFlow并非被淘汰,它在工业工程流水线与多端运行领域构建了极其扎实的壁垒:
- 端侧与边缘设备:
TensorFlow Lite (TF Lite)是目前移动端(Android/iOS)和嵌入式硬件(微控制器、单板机)上优化最完善、量化最健全的推理引擎之一。 - Web端推理:
TensorFlow.js允许直接在浏览器中利用WebGL或WebGPU运行深度学习模型,无需后端服务器参与,在前端智能化与互动产品中不可替代。 - 标准工业服务集群:
TensorFlow Serving专为高吞吐、低延迟的生产环境设计,原生支持模型无缝热更新、多版本并发回滚与gRPC高性能调用。配合TFX (TensorFlow Extended),为大型企业提供了端到端工业级MLOps标准化方案。
四、选型决策指南:如何根据具体目标做出判断
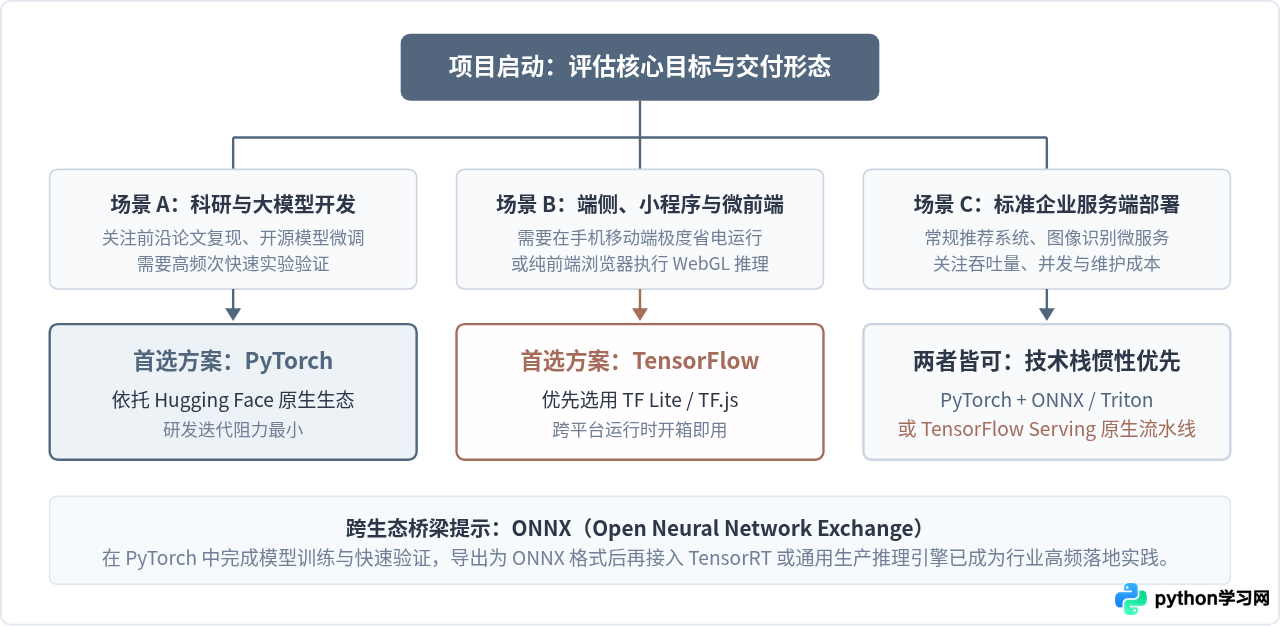
在立项或开始学习时,读者无需纠结于“谁终将取代谁”,而应该根据业务场景与交付要求进行精准判断:
| 考量维度 | PyTorch | TensorFlow (Keras) |
|---|---|---|
| 首选受众 | 算法工程师、科研人员、大模型开发者、高校学生 | 端侧AI开发人员、既有生产线维护工程师、Web端AI开发者 |
| 代码可读性 | 高(纯粹Python语法风格,逻辑透明) | 高层Keras极简洁,但底层Graph模式理解难度高 |
| 前沿模型适配 | 即发即用(几乎所有开源模型第一时间发布PyTorch权重) | 需要社区转换或二次适配,稍有滞后 |
| 部署灵活性 | TorchScript / ExecuTorch / ONNX / TensorRT / Triton | TF Serving / TF Lite / TensorFlow.js / TFX 原生链条完备 |
| 调试诊断成本 | 低(标准错误栈,支持逐层中断检查) | 高(图追踪编译后报错堆栈较为冗长繁杂) |
五、常见避坑事项与过渡建议
import tensorflow.compat.v1、tf.Session()、tf.placeholder等字样,说明这是已被淘汰多年的TF 1.x过时模式,切勿花费精力学习。
对于初学者或计划开展新项目的团队,建议遵循以下两条实践路径:
- 新入门者以 PyTorch 为起点:先用PyTorch建立对张量运算、前向传播、自动微分与优化器迭代的核心认知。由于其报错完全遵循Python语言逻辑,学习阻力最小,且后续学习Hugging Face等大模型库几乎零门槛过渡。
- 不必担心被单一框架锁定:现代深度学习工程中,训练与推理往往分离。通过开放神经网络交换格式
ONNX,可以将PyTorch训练出的模型权重无缝转换为TensorRT、OpenVINO等各芯片厂商的原生加速格式,甚至可通过工具转换为TF Lite运行在移动端。掌握算子数学本质远比纠结于框架API更为重要。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









