

Python数据清洗技巧:利用字符串方法提取和规范文本
在批量处理网页爬虫抓取结果、用户表单提交或后台日志导出数据时,原始文本往往包含不规则空白、冗余前后缀、混乱的大小写和混杂标点。许多人在面对这类轻量级脏文本时会直接引入正则表达式或加载 Pandas,但这往往增加了代码复杂度与内存开销。实际上,Python 内置的字符串方法具有零第三方依赖、执行效率极高且语法直观的特点,足以覆盖绝大多数日常文本清洗与规范化需求。
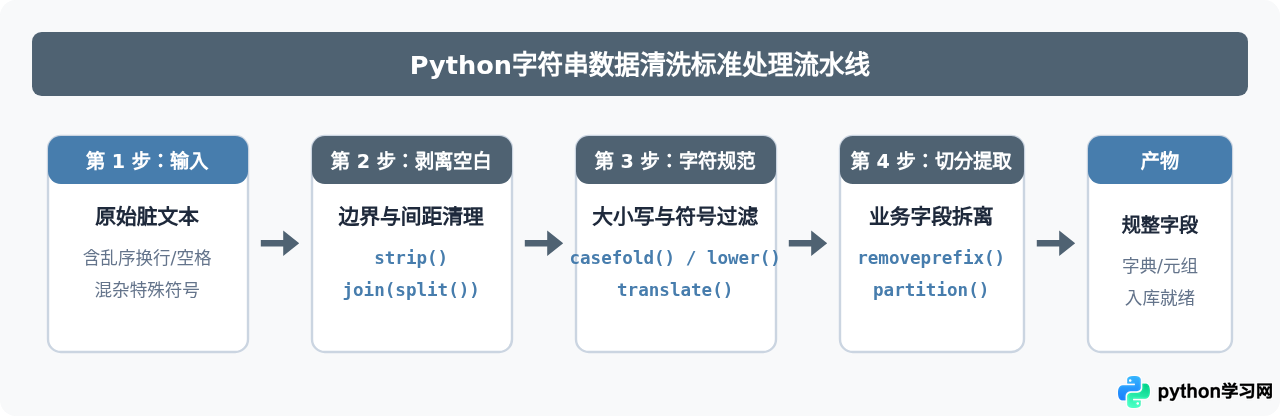
清除空白与隐形控制字符
数据源录入时最普遍的噪音是首尾的空格、换行符(\n、\r)和制表符(\t)。Python 提供了针对不同位置的清除方案:
str.strip([chars]):移除字符串首尾两端的所有指定字符,默认移除所有空白符。str.lstrip([chars]):仅移除左侧(头部)空白或指定字符。str.rstrip([chars]):仅移除右侧(尾部)空白或指定字符。
# 基础空白剔除
raw_name = "\t\r\n  张三丰   \n"
cleaned_name = raw_name.strip()
print(repr(cleaned_name))  # 示例输出: '张三丰'
规整文本内部的连续多余空格
strip() 只能处理首尾两侧的空白,若文本内部存在多个连续空格、换行或混合制表符(例如 "北京 朝阳区 建国门"),可利用 split() 不传参数时的天然特性配合 join() 一步完成规范化:
raw_address = "北京市   海淀区\t中关村南大街\n\n1号院  "
# split() 在不传参数时,会自动将任意连续的空白符(空格、\t、\n等)整体作为分割依据
tokens = raw_address.split()
normalized_address = " ".join(tokens)

print(tokens)              # 示例输出: ['北京市', '海淀区', '中关村南大街', '1号院']
print(normalized_address) # 示例输出: '北京市 海淀区 中关村南大街 1号院'replace(" ", " ") 去除连续双空格,因为三空格或四空格需要循环执行多次才能缩减为单空格;而 " ".join(s.split()) 是一次性规整任意长度连续空白的最优原生手段。
统一字符格式与大小写规范
在对比或建立文本索引前,大小写一致性是必不可少的步骤。Python 提供了多组大小写处理函数,适用于不同清洗场景:
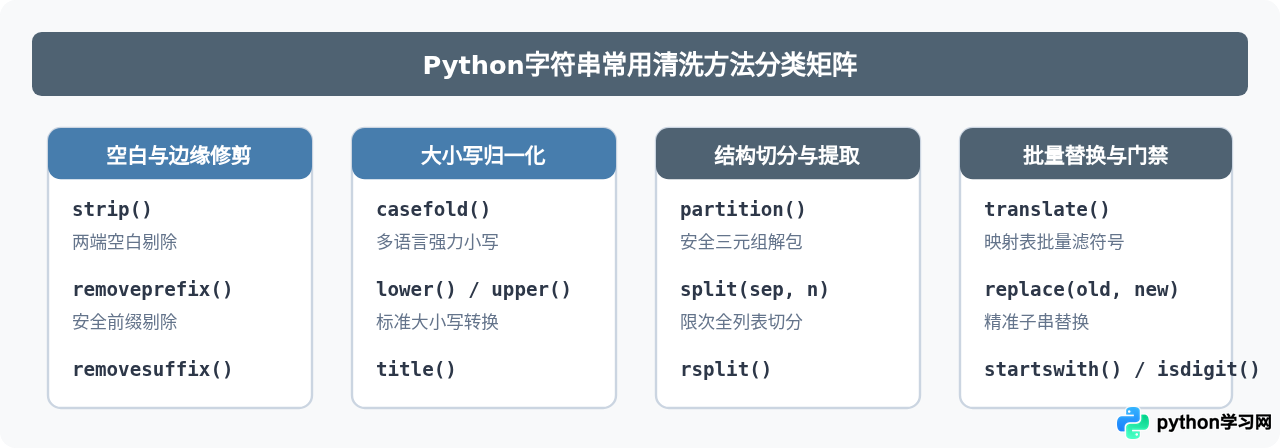
在大小写处理中,常见选择包括:
casefold():相比lower()更加彻底的弱化大小写匹配方案,能正确处理西欧语言特殊字符(例如德语的"ß"转为"ss")。做文本去重与无视大小写的比对时推荐优先使用casefold()。title():每个单词首字母大写。需要注意的是,遇到撇号(如"it's")时会将后续字母误转为大写(变成"It'S")。capitalize():仅将整段文本的第一个字符大写,其余字符全部转为小写。
text_a = "PYTHON_DEVELOPER"
text_b = "python_developer"
# 规范化后进行安全匹配
print(text_a.casefold() == text_b.casefold())  # 示例输出: True
消除前后缀与特定干扰模式
在处理文件路径、协议 URL 或固定业务编码时,常需要移除固定前缀或后缀。这里存在一个在初学者中极为普遍的高频错误——误用 lstrip() 移除字符串前缀。
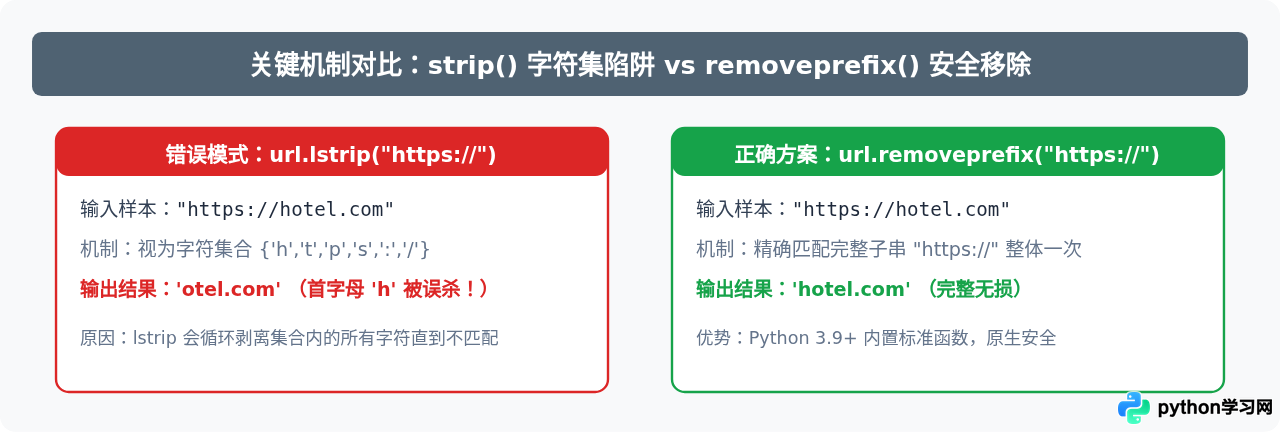
str.strip()、str.lstrip() 与 str.rstrip() 的参数传入的是字符集合而非完整单词序列。只要字符包含在该集合中,它就会被持续剥离。
自 Python 3.9 起,官方引入了 removeprefix() 和 removesuffix(),完美解决了剥离完整业务前缀的需求:
order_id = "ORDER_20261026_099"
cleaned_id = order_id.removeprefix("ORDER_")
print(cleaned_id)  # 示例输出: '20261026_099'

filename = "report_data.csv.bak"
clean_filename = filename.removesuffix(".bak")
print(clean_filename)  # 示例输出: 'report_data.csv'
利用 translate() 批量清洗标点符号
当文本中夹杂大量非标准标点(例如中英文逗号、括号、特殊符号)时,连续调用 replace() 会导致代码臃肿。此时使用 str.maketrans() 配合 str.translate() 是速度最快且最优雅的解法:
# 场景:移除全部英文标点与特殊脏字符
import string

dirty_comment = "用户反馈:[好评!] 速度快、体验好***,点赞&&&!"

# 创建转换映射表:将所有标点符号映射为 None(即直接删除)
remove_puncts = string.punctuation + ",!:【】、"
trans_table = str.maketrans("", "", remove_puncts)

clean_comment = dirty_comment.translate(trans_table)
print(clean_comment)  # 示例输出: '用户反馈好评 速度快体验好点赞'
字段定位、分割与定点提取
在数据清洗中,从半结构化字符串(如 "ID: 9527 | Status: Verified")提取具体字段是常规操作。根据切分需求的不同,应选用不同的切分策略:
1. partition 与 rpartition:安全三元组解包
常规的 split(":") 若遇到不存在冒号的异常脏行时,返回的列表长度为 1,直接用 k, v = s.split(":") 解包会导致程序抛出 ValueError: not enough values to unpack 导致流程中断。
partition(sep) 始终返回固定长度为 3 的元组 (head, sep, tail)。如果未找到分隔符,它将返回 (s, '', ''),程序永远不会报错崩溃:
records = [
    "user_id:1001",
    "invalid_record_data",
    "name:张小凡"
]

for item in records:
    key, sep, val = item.partition(":")
    if sep:
        print(f"提取字段 -> 键: {key.strip()}, 值: {val.strip()}")
    else:
        print(f"告警 -> 跳过非标脏记录: {key}")
# 示例输出:
# 提取字段 -> 键: user_id, 值: 1001
# 告警 -> 跳过非标脏记录: invalid_record_data
# 提取字段 -> 键: name, 值: 张小凡
2. split 限制分割次数
当只想提取头部标志,而保留后续包含分隔符的正文内容时,必须使用 maxsplit 参数控制切分次数:
log_line = "2026-10-26 12:00:00 - ERROR - Database connection timeout: retry=3"
# 仅根据 " - " 切割前2次
parts = log_line.split(" - ", maxsplit=2)
print(parts)
# 示例输出: ['2026-10-26 12:00:00', 'ERROR', 'Database connection timeout: retry=3']
数据质量校验门禁方法
在清洗流程中,不是所有文本都值得继续处理。提早借助布尔判断方法对数据进行过滤,可以大幅降低后续解析负担:
| 方法名 | 校验逻辑 | 典型应用场景 |
|---|---|---|
startswith(prefix) |
检查字符串是否以指定子串开头(支持元组多条件) | 过滤非法协议头、检查业务代码前缀 |
endswith(suffix) |
检查是否以指定后缀结尾(支持元组) | 校验文件拓展名、合法单位标识 |
isdigit() |
检查是否仅包含十进制数字字符 | 校验电话号码、用户 UID、邮政编码纯度 |
isalnum() |
检查是否全为字母或数字组合 | 清理特殊注入字符、验证订单流水号 |
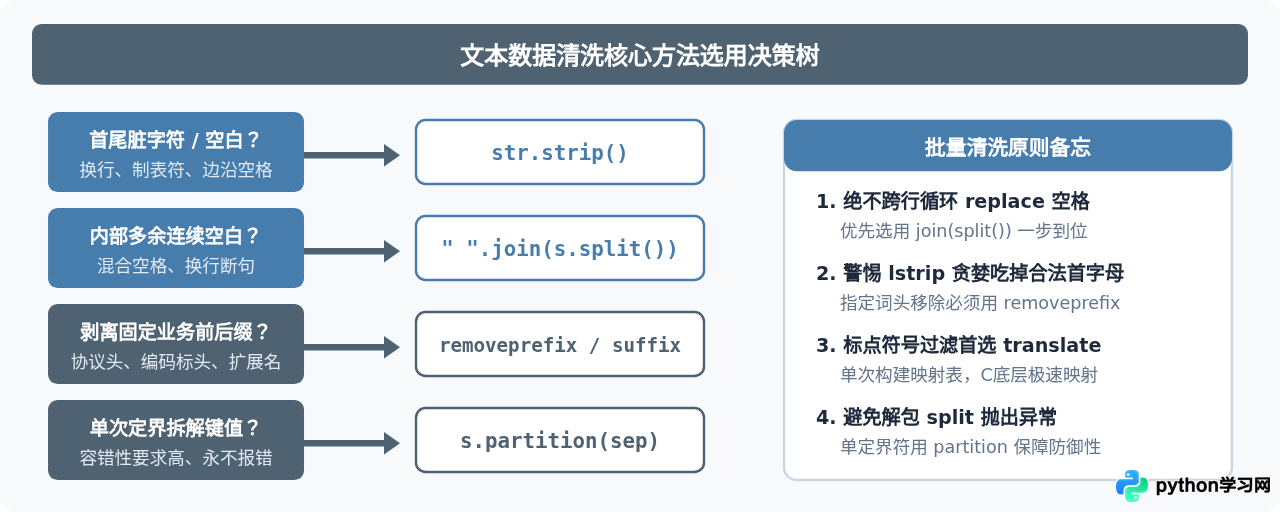
字符串清洗方法选用决策
面对各式各样的文本脏数据,清晰的选用思路能够保证清洗代码既简洁又不易产生边界漏洞。下方的决策图总结了针对不同问题特征的核心方法对应路径:
综合实战:多维度脏数据一体化清洗
下面通过一段包含前后多余空白、乱序制表符、混合大小写、固定前后缀杂质的客户登记数据,演示如何组合利用纯原生字符串方法构建一条高内聚的清洗流水线:
# 原始输入记录集合
raw_records = [
    "  USR_ID#88319 :  Li_Lei@Company.COM  \r\n",
    "  USR_ID#88320 :  Han_Meimei@Foxmail.COM \t",
    "INVALID_ROW_FORMAT_HERE",
    "USR_ID#88321 :  Jack_MA@ALI.ORG\n"
]

def clean_record(row: str):
    # 步骤 1: 清理外围换行与空格
    row = row.strip()

    # 步骤 2: 安全三元组解包,过滤无效结构
    raw_uid, sep, raw_email = row.partition(":")
    if not sep:
        return None  # 记录格式不合规,阻断

    # 步骤 3: 提取用户ID(剔除业务标识与井号)
    # 去除首部 "USR_ID#" 前缀并移除多余空白
    clean_uid = raw_uid.strip().removeprefix("USR_ID#")

    # 步骤 4: 规范电子邮箱(统一小写、剥离空白)
    clean_email = raw_email.strip().lower()

    # 步骤 5: 提取用户名与邮箱域名
    username, at_sep, domain = clean_email.partition("@")

    return {
        "uid": int(clean_uid) if clean_uid.isdigit() else None,
        "email": clean_email,
        "username": username,
        "domain": domain
    }

# 批量执行清洗流水线
cleaned_dataset = [clean_record(item) for item in raw_records if clean_record(item) is not None]

# 查看清洗产物
for data in cleaned_dataset:
    print(data)

# 示例输出:
# {'uid': 88319, 'email': 'li_lei@company.com', 'username': 'li_lei', 'domain': 'company.com'}
# {'uid': 88320, 'email': 'han_meimei@foxmail.com', 'username': 'han_meimei', 'domain': 'foxmail.com'}
# {'uid': 88321, 'email': 'jack_ma@ali.org', 'username': 'jack_ma', 'domain': 'ali.org'}
性能与边界注意事项
- 字符串不可变性(Immutability):Python 中每次调用
replace()、strip()或lower()都会在内存中生成新的字符串对象。当处理数十万行级别的超长列表时,避免在循环体内进行多层嵌套的重复赋值;可以借助列表推导式或生成器表达式(Generator Expression)在管道中惰性求值。 - 何时转向正则表达式:当文本特征具有高度动态性或复杂的模糊模式匹配(例如提取特定规则混杂的身份证号、多层嵌套括号表达式或不确定长度的特定格式日期)时,才应切换至
re模块。对于有固定定界符、确定前后缀和明确字符集的常规任务,内置字符串方法的执行速度普遍比正则匹配快 3 到 8 倍,且可维护性更佳。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









