

不同Python版本生成的.pyc文件兼容吗?迁移注意事项
直接给出的明确结论是:在绝大多数情况下,不同 Python 版本之间生成的 .pyc 文件并不兼容。在主版本(如 Python 2 与 Python 3)以及不同的次版本(如 Python 3.9、3.10、3.11 与 3.12)之间,.pyc 文件均不可跨版本通用;只有在同一个次版本内部的小版本补丁更新之间(例如 Python 3.10.2 与 Python 3.10.12),字节码文件通常才保持兼容。本文将深入解释背后的魔数校验机制与字节码设计,并梳理在多版本切换、项目迁移和生产打包时必须遵循的操作流程与注意事项。
一、为什么跨版本的 .pyc 文件不能混用
.pyc 是 Python 解释器在加载 .py 源码时编译生成的二进制字节码缓存文件,位于对应的 __pycache__ 目录中。它的核心作用是避免在下一次运行相同代码时重复执行词法分析、语法解析和字节码编译,从而加快模块的加载速度。然而,Python 官方并未将字节码规范设计为长期稳定的跨版本中间语言格式。
每个 .pyc 文件的开头都包含一段固定格式的头部信息(Header),其中前 4 个字节就是决定兼容性的核心标识——魔数(Magic Number)。魔数由 2 个字节的特定版本标识序号与 2 个字节的回车换行符(\r\n)组成。当 Python 解释器准备加载 .pyc 文件时,第一步操作就是读取这 4 个字节,并将其与当前运行环境的内置魔数进行比对。
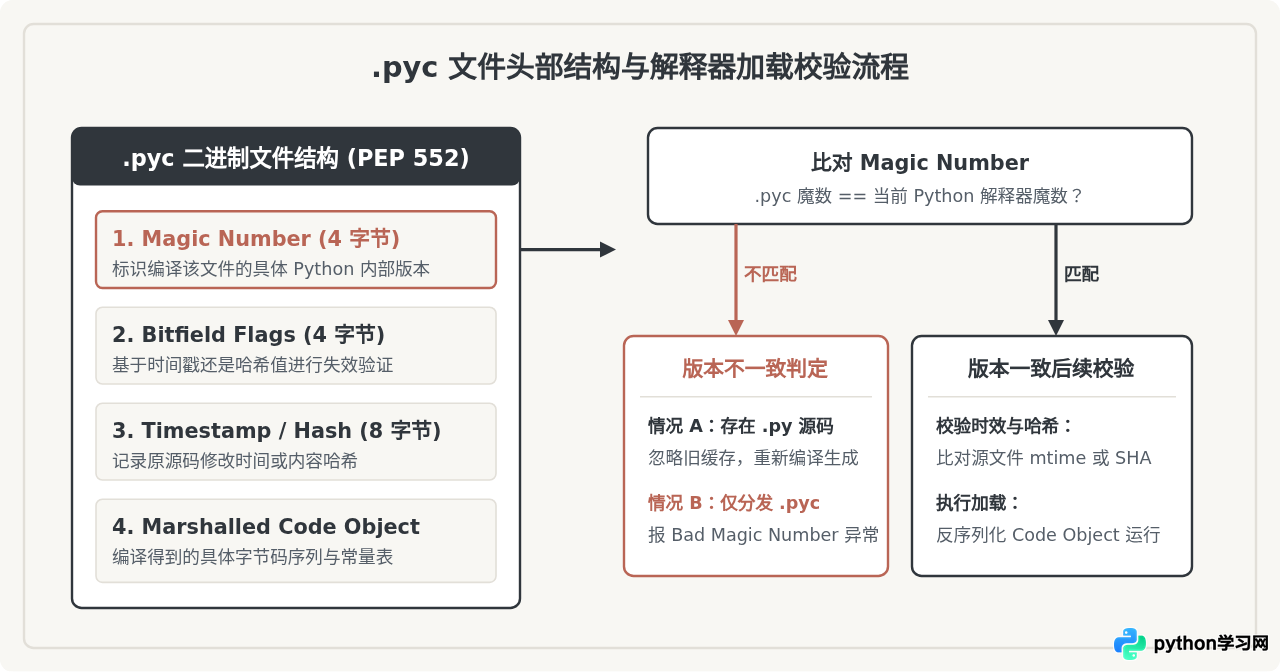
除了魔数以外,更底层的限制在于虚拟机操作码(Opcode)的频繁演进。Python 核心开发团队会在每个次版本中优化或重构字节码指令。例如:
- 在 Python 3.6 中,操作码从原本可变长度调整为统一的 16 位单字码(Wordcode)。
- 在 Python 3.11 的“Faster CPython”项目中,引入了专有化自适应解释器(Specializing Adaptive Interpreter),重写了大量基础操作码并引入内联缓存(Inline Cache)。
- 在 Python 3.12 中,移除了部分过时的指令,进一步调整了异常处理表和基本块跳转逻辑。
由于指令含义、操作数格式和执行栈布局在各版本中存在显著变动,即便强行绕过魔数校验,旧版解释器读取新版字节码也会遇到未知的指令解析错误,轻则引发 ValueError: bad marshal data,重则直接导致解释器底层进程崩溃。
二、Python 版本差异与兼容性边界
为了在实际迁移时准确评估风险,我们需要区分 Python 语义化版本(Major.Minor.Micro)在字节码层面所代表的具体兼容范围:
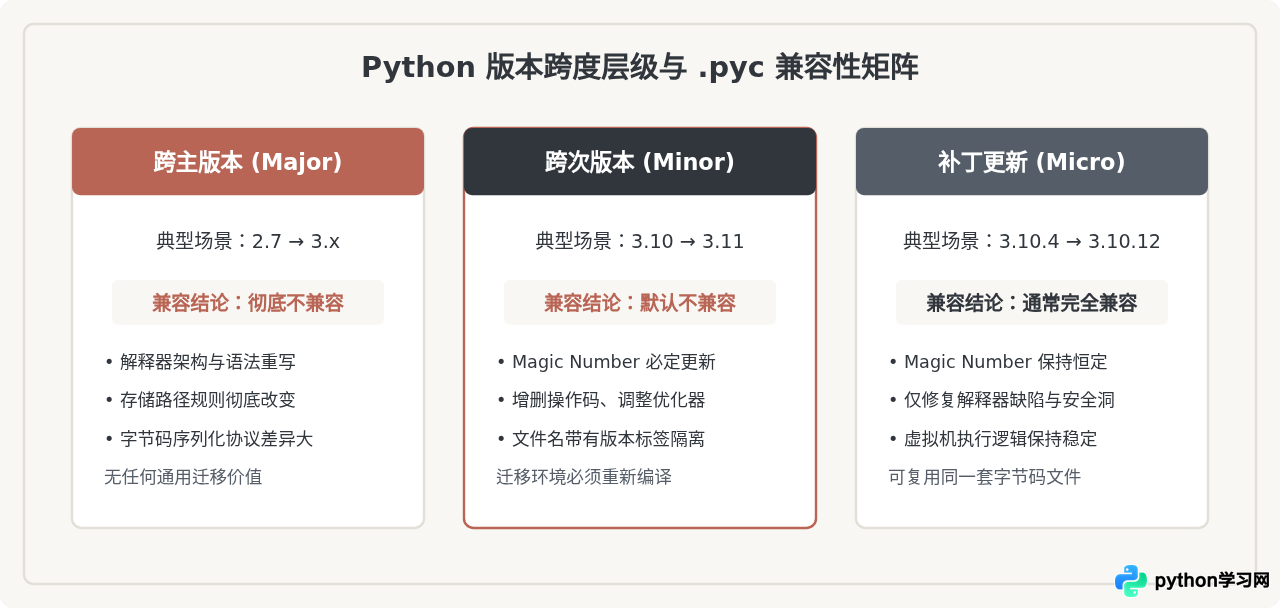
为了直观说明次版本间的魔数变化,可以通过 Python 内置的 importlib.util.MAGIC_NUMBER 模块打印当前环境的魔数值:
import importlib.util

# 打印当前 Python 解释器使用的魔数(16进制与十进制整数)
raw_magic = importlib.util.MAGIC_NUMBER
magic_int = int.from_bytes(raw_magic[:2], 'little')
print(f"原始字节: {raw_magic!r}")
print(f"对应 Magic 整数标识: {magic_int}")
不同次版本对应的魔数在源码中是严格递增或分配的,例如:
| Python 版本 | 十六进制魔数(前2字节) | 十进制标识 | 与邻近版本兼容性 |
|---|---|---|---|
| Python 3.8 | \x55\x0d |
3413 | 与 3.9 及更高版本互不兼容 |
| Python 3.9 | \x61\x0d |
3425 | 与 3.8、3.10 互不兼容 |
| Python 3.10 | \x6f\x0d |
3439 | 3.10.x 内部兼容,跨次版本不兼容 |
| Python 3.11 | \xa7\x0d |
3495 | 引入自适应指令集,完全独立 |
| Python 3.12 | \xcb\x0d |
3531 | 移除多项旧指令,完全独立 |
PEP 3147 命名隔离机制: 自 Python 3.2 引入 PEP 3147 之后,编译生成的 .pyc 文件被统一归纳在源码同级的 __pycache__ 目录中,文件名中会强制追加平台与版本标签,例如 utils.cpython-310.pyc 和 utils.cpython-311.pyc。这种命名机制使得同一台机器在切换 Python 版本时,可以并存不同版本的缓存,而不会互相直接覆盖破坏。
三、项目迁移与版本切换中的关键注意事项
在实际工程运维中,项目升级 Python 版本、迁移服务器或使用 Docker 容器构建时,因 .pyc 产生的诡异报错屡见不鲜。为了确保迁移过程顺畅,建议严格遵守以下操作步骤:
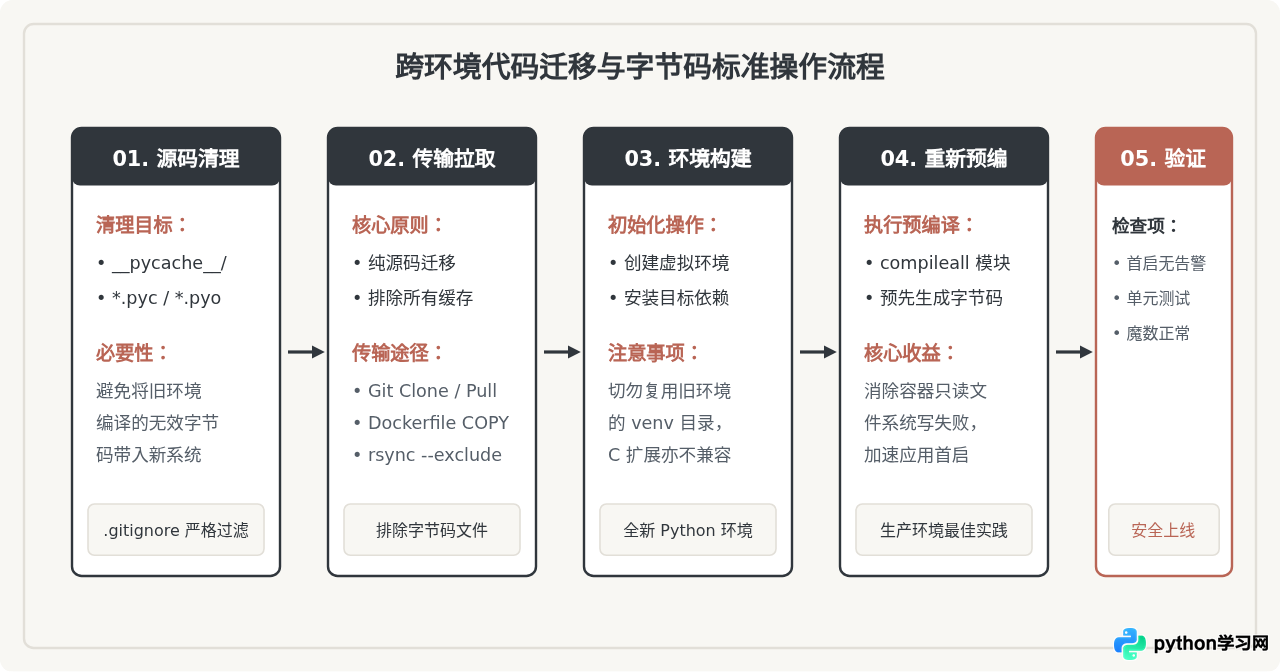
1. 严格将 .pyc 与 __pycache__ 排除在版本控制外
跨版本引发问题的最主要根源,是开发者不慎将本地低版本环境生成的字节码提交进了 Git 仓库,随后被部署到了使用高版本 Python 的生产服务器上。在项目的根目录 .gitignore 中,必须加入完整的忽略规则:
# 忽略字节码缓存目录与相关文件
__pycache__/
*.py[cod]
*$py.class
2. 迁移前后彻底清理陈旧的缓存文件
如果需要在本地同一工作目录中切换多个 Python 版本(例如使用 pyenv、conda 从 3.9 切换至 3.11 测试),建议在切换版本后运行命令彻底清空残留的旧缓存:
# Linux / macOS 环境下递归查找并删除所有 __pycache__ 目录与 .pyc 文件
find . -type d -name "__pycache__" -exec rm -rf {} +
find . -type f -name "*.pyc" -delete

# 或使用 Python 自带的标准库脚本在当前目录下递归清理
python -c "import pathlib, shutil; [shutil.rmtree(p) for p in pathlib.Path('.').rglob('__pycache__')]"
3. 在特定场景下禁用字节码生成
在持续集成(CI)、短生命周期的容器执行或某些自动化测试环境中,生成 .pyc 文件不仅不会带来可观的性能提升,反而可能因为文件系统写权限不足导致异常。此时可以通过设置系统环境变量或启动参数直接禁用字节码写入:
- 环境变量: 设置
export PYTHONDONTWRITEBYTECODE=1。 - 命令行参数: 使用
python -B main.py运行程序。
4. 生产环境镜像打包的预编译(compileall)
在构建生产 Docker 镜像时,通常为了安全会将容器运行目录设置为只读文件系统(Read-only Root Filesystem)。如果此时没有提前生成对应 Python 版本的 .pyc,Python 进程在导入模块尝试写入缓存失败时会抛出警告或错误;即便在可写文件系统中,应用启动时临时编译每个模块也会拖慢首屏响应。正确的做法是在构建 Dockerfile 期间调用 compileall 模块完成针对当前环境的预编译:
# 在 Dockerfile 中,源码复制完成后执行预编译
COPY ./app /workspace/app
WORKDIR /workspace

# 使用当前容器内的 Python 解释器预编译所有文件为 .pyc
RUN python -m compileall -q /workspace/app
四、仅分发 .pyc 场景下的版本与兼容性陷阱
一些商业项目或交付场景希望通过“不提供 .py 源码,仅交付 .pyc 字节码”的方式实现简易的代码逻辑隐藏或分发。这种方案最大的技术痛点就是版本锁定过于严苛:
- 目标机器版本必须完全一致: 交付方使用 Python 3.10.8 编译得到的
.pyc,如果客户现场的服务器安装的是 Python 3.8 或 Python 3.11,客户执行import时将直接触发异常中断,提示魔数不匹配。 - 难以逆向排查与更新: 当缺少源码时,Python 解释器无法在检测到魔数失效时自动执行重新编译,整个应用陷入瘫痪。
- 安全与防逆向局限:
.pyc仅仅是字节码序列化,使用开源的反编译工具(如decompyle++、uncompyle6)在对应支持的版本下通常能轻易恢复出高可读性的源码。
对于确实需要二进制分发或代码保护的场景,更稳妥的做法是:
- 容器化交付: 将运行所需的指定版本 Python 解释器、依赖库与
.pyc整体打包为 Docker 镜像,彻底消除主机 Python 版本漂移的影响。 - 原生 C 扩展编译: 使用 Cython 或 Nuitka 将 Python 代码转译为 C 源码并编译为
.so(Linux)或.pyd(Windows)机器码二进制动态库,脱离 Python 字节码层面的版本绑定。
五、常见报错诊断与治理决策树
当在跨版本或多环境运行 Python 代码时遭遇字节码冲突,最典型的两种报错表现如下:
# 典型报错 1:魔数不匹配(常见于缺少 .py 源码只有旧版 .pyc 时)
ImportError: bad magic number in 'config': b'\x6f\x0d\r\n'

# 典型报错 2:序列化代码对象损坏或指令无法被旧版本解释器解析
ValueError: bad marshal data (unknown type code)
遇到类似问题时,可参照以下决策树进行系统化排查与修复:
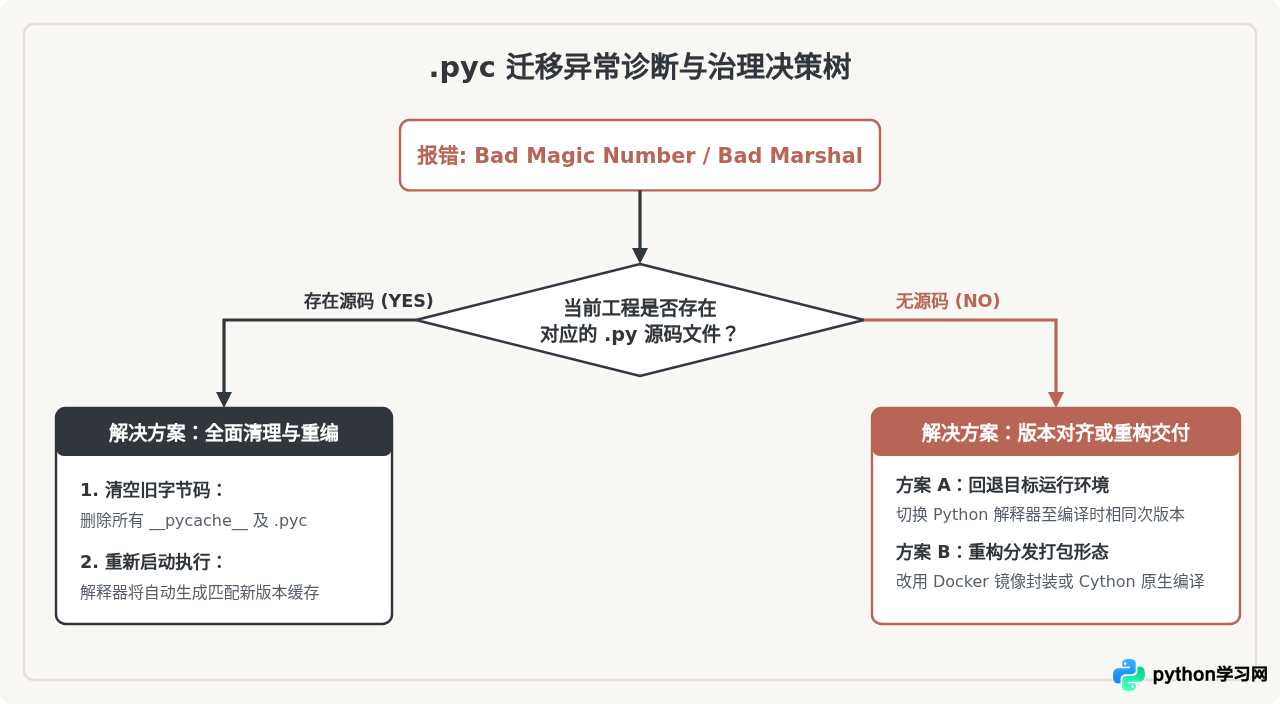
若需要核验某个具体的 .pyc 文件究竟是由哪个 Python 次版本编译生成的,可以使用下面的 Python 诊断脚本直接解析该文件前 4 字节的魔数:
import sys

def inspect_pyc_header(pyc_path):
    with open(pyc_path, 'rb') as f:
        magic_bytes = f.read(4)
    if len(magic_bytes) < 4:
        print("错误:文件长度不足 4 字节,非合法 .pyc 文件")
        return

    magic_int = int.from_bytes(magic_bytes[:2], 'little')
    print(f"目标文件: {pyc_path}")
    print(f"魔数字节序列: {magic_bytes!r}")
    print(f"提取魔数标识: {magic_int}")

if __name__ == '__main__':
    if len(sys.argv) > 1:
        inspect_pyc_header(sys.argv[1])
    else:
        print("用法: python check_magic.py <file.pyc>")
六、总结
总结而言,跨 Python 次版本的 .pyc 字节码文件在机制上是严格不兼容的。Python 依赖魔数校验与版本化目录命名机制,防止了不匹配的字节码导致系统错误。在工程实践中:
- 日常开发与部署应坚持纯源码迁移原则,通过
.gitignore坚决杜绝__pycache__目录进入版本控制。 - 切换 Python 版本后,应当主动清理残存的旧版本
.pyc。 - 生产镜像交付时,利用
python -m compileall在目标运行环境中针对性预生成匹配字节码。 - 对于无源码的字节码交付需求,必须严格锁定目标环境的主次版本,或者转向容器封装与 C 扩展原生编译。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









