

怎么筛选高质量的Python人工智能开源案例与避坑指南

设想一个典型的开发情境:你在GitHub上搜索到一个标星超过3000的AI开源项目,演示动图效果惊艳,声称具备业界前沿性能,并附带简洁的运行指令。然而将代码克隆到本地后,刚执行依赖安装命令便遭遇大面积底层扩展编译报错;花费半天排查好环境,下载了网盘中存放的权重文件,一运行预测脚本却抛出张量维度不匹配或核心模块缺失的致命异常。这并非偶发现象,而是AI开源生态中由于学术论文代码缺乏工程化维护、硬件依赖深度耦合导致的常态。筛选高质量Python人工智能开源案例的核心,在于建立“仓库元数据初筛、依赖环境规格审查、模型权重闭环核验、沙盒隔离验证”的四步漏斗机制,并在动手前识别出常见的环境与算力暗礁。
一、四步漏斗筛选法:系统化甄别可用开源项目
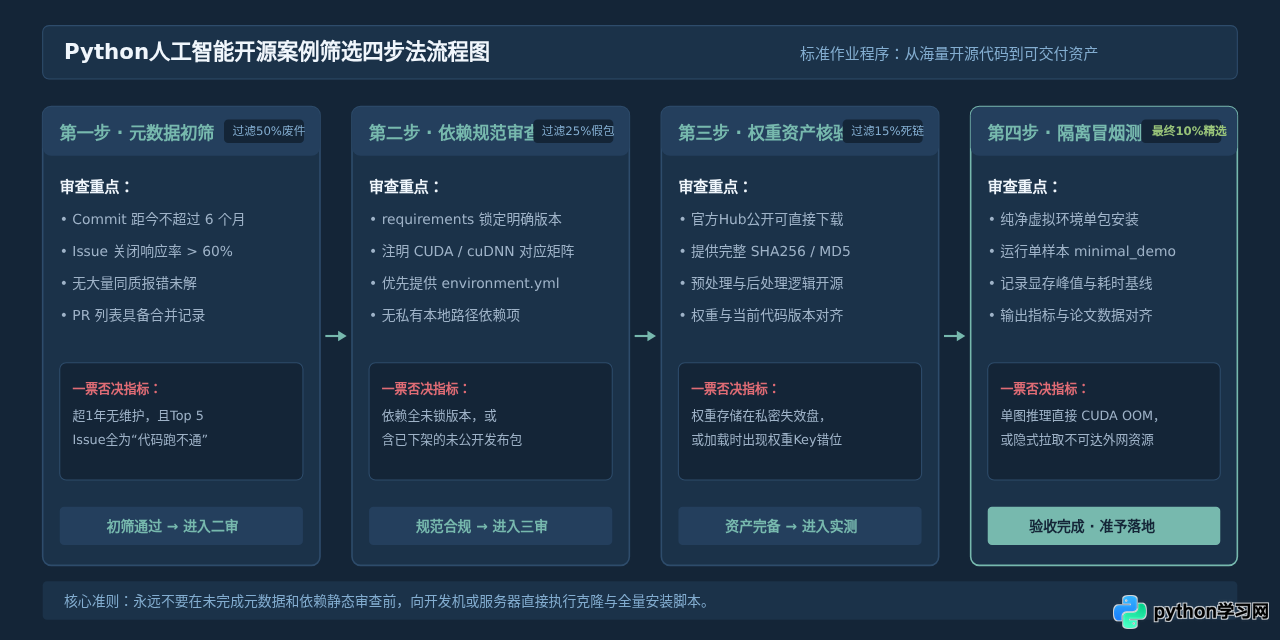
挑选可落地的Python AI开源案例不能仅看Star数量,因为高标星往往反映的是论文关注度或概念热度,并不等同于工程交付水准。高效的筛选必须遵循由粗到细的四步漏斗流程:
- 元数据与维护状态初筛:审查最近一次代码提交时间与Issue处理状况。如果仓库已超过半年没有任何更新,且未解决的Issue中积压了大量“代码跑不通”或“报错无法复现”而作者完全未予回应,该项目大概率已处于停滞状态。
- 环境与依赖规格审查:查看依赖清单是否专业规范。具备良好工程规范的项目会明确给出Python版本(如3.10)、PyTorch/TensorFlow的具体版本及其对应的CUDA支持矩阵,甚至提供完整的
environment.yml或Dockerfile。 - 模型资产与权重链路核查:确认核心预训练权重是否能够稳定获取。优质项目通常将权重托管在Hugging Face Hub、ModelScope或GitHub Releases等公开平台,并附带SHA256校验码;若权重托管于无校验的个人网盘或私有网盘链接早已失效,则属于典型的不可用项目。
- 隔离沙盒冒烟测试:在独立的虚拟环境中只运行最小推理用例(Minimal Working Example),记录单次推理的显存占用和耗时,核验输出结果是否与文档描述一致。
二、评估矩阵:量化衡量AI开源项目的四大维度
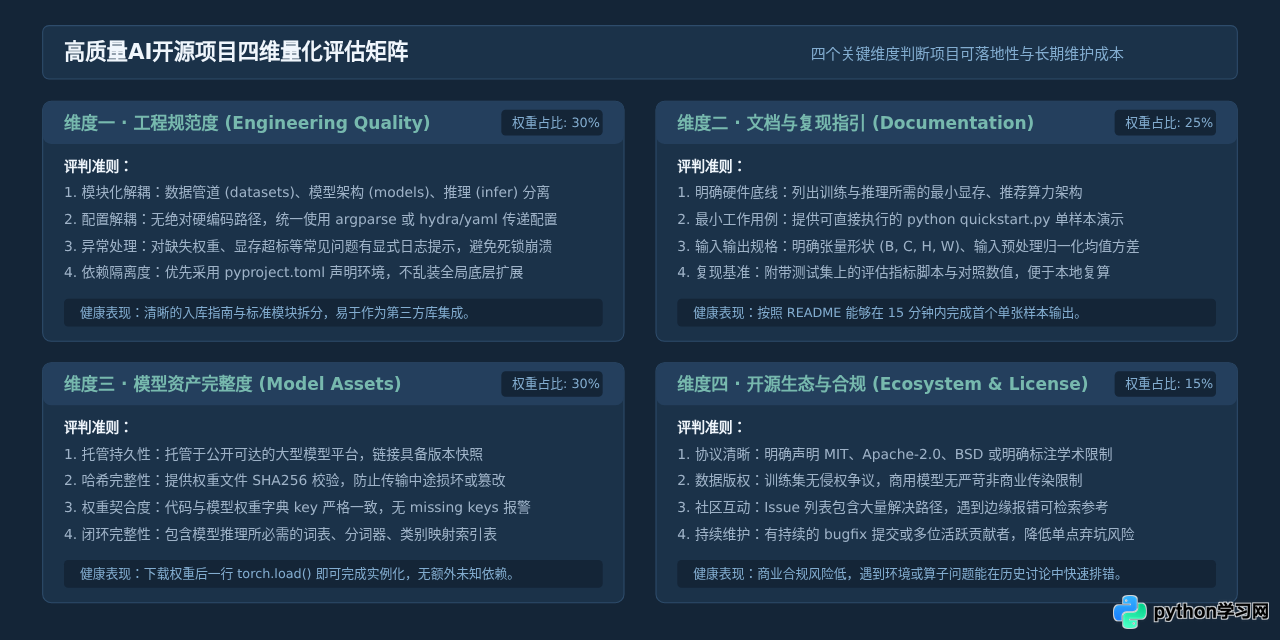
通过漏斗筛选后,需要对候选项目建立多维度的质量雷达。AI项目的工程特异性决定了它不仅涉及常规软件工程的代码风格,还强依赖硬件加速器和复杂数学计算库。以下四个维度构成了量化评估的核心依据:
| 评估维度 | 高质量特征 | 低质量风险特征 |
|---|---|---|
| 1. 工程规范度 | 核心模型、数据管道与推理脚本目录清晰;超参数与路径抽离为YAML或命令行参数;提供单元测试。 | 单文件千行代码;数据路径强行硬编码在模型类中(如 D:/dataset/train);全局变量混乱。 |
| 2. 文档与复现指引 | 明确给出最低GPU显存要求与CUDA驱动区间;提供带预期输出的快速入门示例代码与日志。 | 仅有一句话简述与论文链接;无任何参数说明;未提及需要预装哪些C++编译环境或系统级动态库。 |
| 3. 资产与闭环度 | 官方Release提供模型权重与MD5;提供开箱即用的推理脚本;预处理/后处理代码与论文描述一致。 | 权重托管于易失效的个人分享盘;权重Key与仓库当前模型定义脱节;代码缺失训练反向传播部分。 |
| 4. 许可与合规性 | 采用标准开源协议(如 Apache-2.0、MIT、BSD);训练数据源合规且版权边界清晰。 | 无开源协议(默认保留所有权利);或附加限制严格的非商业(CC-BY-NC)协议却未明示。 |
三、环境复现与避坑实战指南
AI开源项目跑不通,绝大多数并非代码本身的算法错误,而是由于硬件驱动、计算框架、依赖项版本以及显存资源之间产生的连锁冲突。在动手运行任何开源代码前,必须掌握以下排查与处置方法。
1. 避开CUDA与PyTorch的“三元版本冲突”
许多开发者在克隆代码后,第一步就习惯性输入 pip install -r requirements.txt。这是导致环境崩溃最常见的误操作。许多开源项目的依赖清单里直接写着 torch 或 torch>=1.12.0,当执行默认 pip 安装时,系统会从 PyPI 仓库下载官方默认的轮子(通常是 CPU 版本,或当前最新的 CUDA 编译版本),这会直接覆盖你原本针对本机显卡驱动配置好的 PyTorch 环境,导致 GPU 无法被调用。
标准操作流程:
# 步骤 1:创建并激活纯净的 Python 独立沙盒环境
conda create -n ai_sandbox python=3.10 -y
conda activate ai_sandbox

# 步骤 2:查看宿主机显卡支持的最大 CUDA 版本(检查右上角 CUDA Version 字段)
nvidia-smi

# 步骤 3:根据显卡驱动版本,单独前往官方源安装特定预编译 PyTorch 轮子
# 例如安装匹配 CUDA 12.1 的 PyTorch 2.1.2 稳定版
pip install torch==2.1.2 torchvision==0.16.2 torchaudio==2.1.2 --index-url https://download.pytorch.org/whl/cu121
安装完成后,必须立刻编写一个单行脚本检验 GPU 挂载状态:
# 环境健康度冒烟检查脚本 verify_env.py
import torch

print(f"PyTorch 核心版本: {torch.__version__}")
print(f"CUDA 是否可用: {torch.cuda.is_available()}")
if torch.cuda.is_available():
    print(f"当前计算卡型号: {torch.cuda.get_device_name(0)}")
    print(f"CUDA 算力支持架构: {torch.cuda.get_device_capability(0)}")
else:
    print("警告:当前 PyTorch 运行于 CPU 模式!")
终端执行输出示例(明确标示为示例):
[示例输出]
PyTorch 核心版本: 2.1.2+cu121
CUDA 是否可用: True
当前计算卡型号: NVIDIA GeForce RTX 4090
CUDA 算力支持架构: (8, 9)避坑要点:完成 PyTorch 安装并验证可用后,再安装项目的其他业务依赖。在执行 pip install -r requirements.txt 之前,先打开该文件,将其中的 torch、torchvision、torchaudio 等行注释掉,避免 pip 重新解析依赖时将其替换为错误版本。
2. 显存不足(CUDA Out of Memory)的紧急处置
论文作者通常在多卡高端算力集群(如 8×A100 或 8×H100)上进行实验,其默认配置文件中的 batch_size、image_size 或序列长度往往设得极大。消费级显卡(如 8G/16G/24G)直接运行原版代码通常会立即崩溃。
针对 OOM 的系统化改造三原则:
- 将批处理大小降至极小值:修改配置文件或运行参数,将
--batch_size改为1。先确保单张样本能够完整通过前向计算。 - 开启半精度推理与关闭梯度计算:许多旧项目在评估或预测时未显式添加
torch.no_grad(),导致张量在显存中不断累积计算图。使用torch.cuda.amp.autocast()能够直接减少约 50% 的显存占用。 - 清理显存缓存:在循环处理逻辑中显式调用
torch.cuda.empty_cache()。
# 显存安全的高效单样本推理范例代码
import torch

def safe_inference(model, input_tensor):
    # 确保模型置于评估模式,关闭 Dropout 和 BatchNorm 更新
    model.eval()

    # 强制关闭反向传播梯度追踪
    with torch.no_grad():
        # 启用自动混合精度 (AMP),显著降低显存开销
        with torch.cuda.amp.autocast(dtype=torch.float16):
            output = model(input_tensor.cuda())

    # 推理完毕后及时释放非必要缓存
    torch.cuda.empty_cache()
    return output.cpu()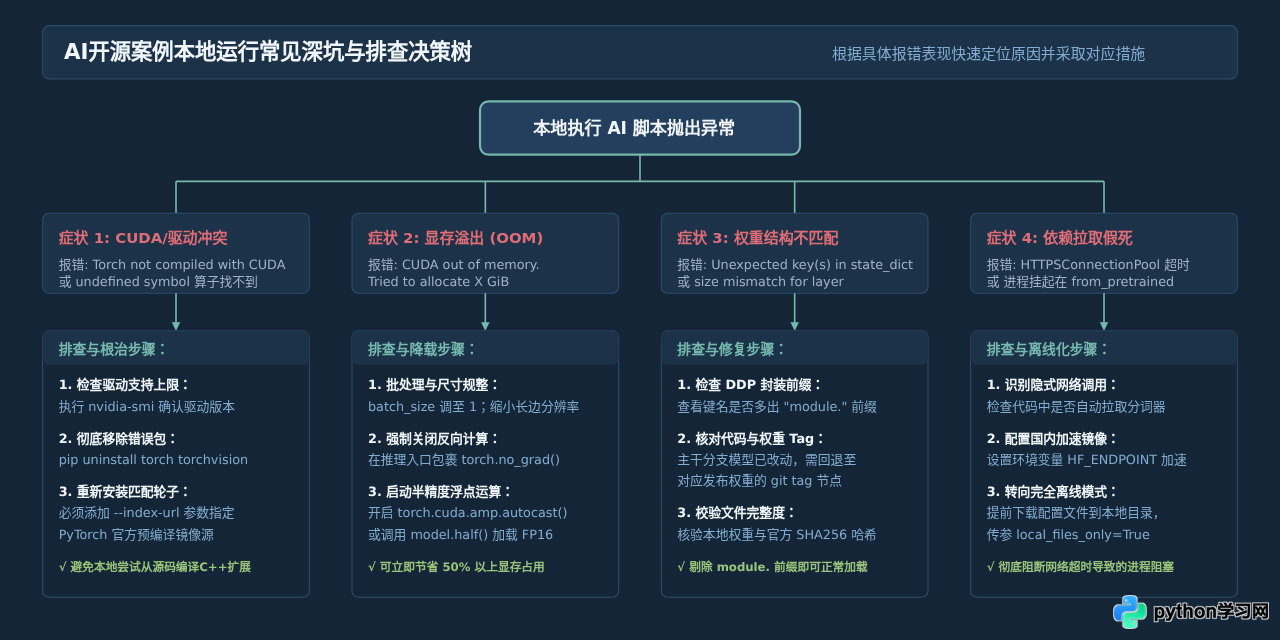
3. 多GPU训练权重在单卡或CPU上的加载陷阱
许多开源项目在训练时采用了 PyTorch 的 DistributedDataParallel (DDP),保存下来的 state_dict 中,所有权重张量的键名前都会自动带有 module. 前缀(例如 module.backbone.conv1.weight)。如果你直接在单卡或 CPU 推理代码中实例化模型并加载,会抛出令人困惑的尺寸或键名缺失错误:Missing key(s) in state_dict: "backbone.conv1.weight"。
通用的权重字典键名修复工具函数:
import torch

def load_weights_cleanly(model, weight_path):
    # 将权重映射至 CPU,防止跨设备加载异常
    state_dict = torch.load(weight_path, map_location="cpu")

    # 针对部分项目将 state_dict 嵌套在字典内部的情况进行提取
    if "model" in state_dict:
        state_dict = state_dict["model"]
    elif "state_dict" in state_dict:
        state_dict = state_dict["state_dict"]

    # 规范化清理 module. 前缀
    cleaned_dict = {}
    for k, v in state_dict.items():
        clean_key = k[7:] if k.startswith("module.") else k
        cleaned_dict[clean_key] = v

    # 执行非严格匹配加载,并捕获不匹配项
    missing_keys, unexpected_keys = model.load_state_dict(cleaned_dict, strict=False)
    if missing_keys:
        print(f"提示:缺失的权重参数列表: {missing_keys}")
    if unexpected_keys:
        print(f"提示:未预期的多余参数列表: {unexpected_keys}")

    return model
四、全流程复现检查清单与生命周期总结
将一个外部开源项目转化为团队内部可用、可维护的代码资产,需要遵循从准备、构建、冒烟测试到最终生产固化的完整生命周期。以下清单可作为每次引进新模型时的标准操作指引:
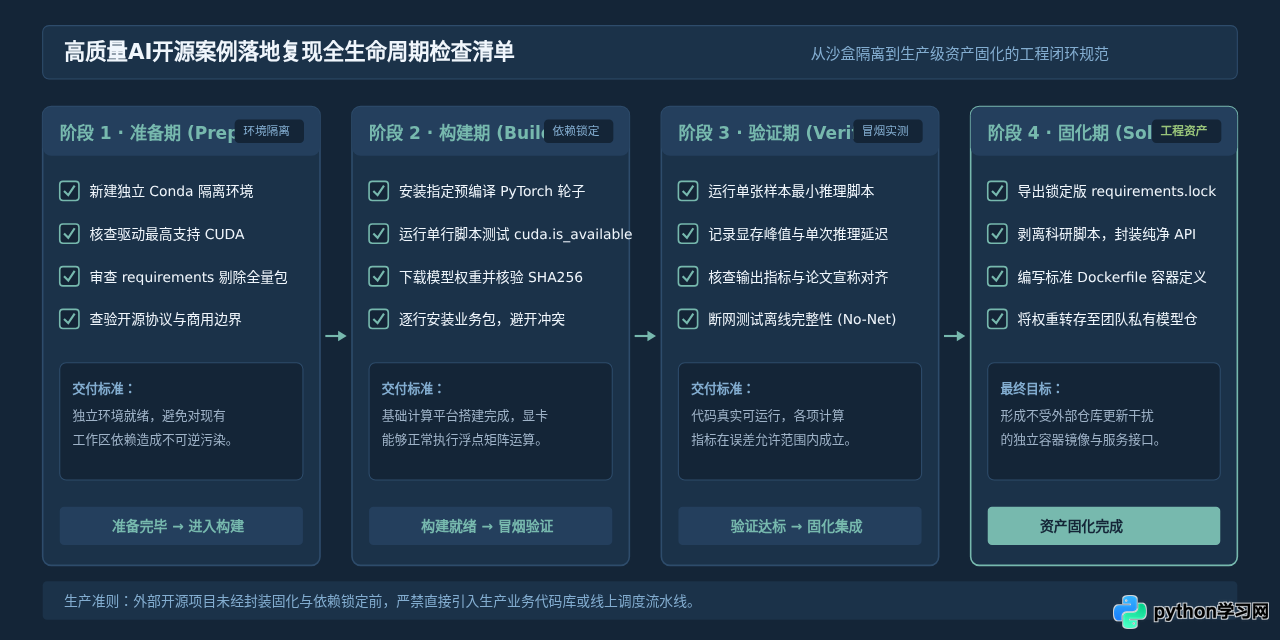
总结:筛选高质量的 Python 人工智能开源项目,实质上是在进行技术资产的风险控制。通过静态的四步漏斗迅速过滤掉缺乏维护的“僵尸代码”,再通过工程规范、文档质量与资产闭环三个维度锁定优质标的;在实机运行阶段,始终坚持沙盒隔离、先锁定 CUDA 预编译核心库、再降载进行单样本冒烟测试。遵循这套方法,可以最大程度避免因开源代码质量参差不齐而浪费大量研发时间,确保 AI 技术选型稳健落地。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









