

Python实现水仙花数:从基础逻辑到列表推导式
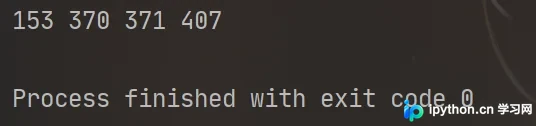
本文详解Python中水仙花数(阿姆斯特朗数)的实现方法。首先解释其定义:一个3位数,其各位数字的立方和等于该数本身。接着展示两种Python实现方案:一是通过常规循环与类型检查获取指定范围内的水仙花数;二是利用列表推导式直接生成所有满足条件的三位数。内容涵盖函数封装、参数校验及代码优化技巧,适合Python初学者参考。
2026-10-14
21
本文详解Python中水仙花数(阿姆斯特朗数)的实现方法。首先解释其定义:一个3位数,其各位数字的立方和等于该数本身。接着展示两种Python实现方案:一是通过常规循环与类型检查获取指定范围内的水仙花数;二是利用列表推导式直接生成所有满足条件的三位数。内容涵盖函数封装、参数校验及代码优化技巧,适合Python初学者参考。
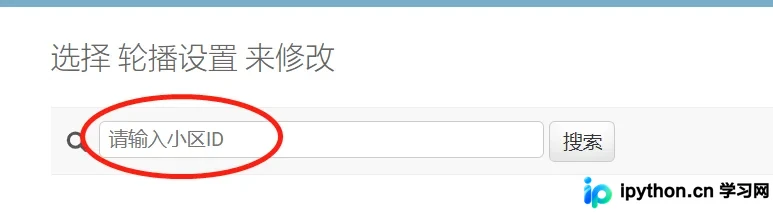
Django 后台默认搜索框缺少提示文字,体验不佳。本文介绍通过定制模板标签和继承 PlaceholderMixin 类,为 search_fields 添加自定义 placeholder 提示文字的方法。
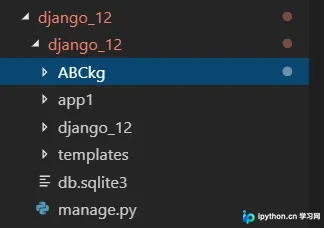
本文详细讲解如何在Django项目中创建并运行Scrapy爬虫,实现数据抓取后直接存入Django数据库。通过配置settings.py、编写爬虫逻辑、利用scrapy-djangoitem将Item映射为Django模型,并在Pipeline中调用save()方法,最终在Admin后台查看结果。
本文详解 Django 中执行原生 SQL 的三种主要方式:使用 raw() 方法处理模型映射、利用 extra() 扩展查询条件以及通过 connection.cursor() 直接操作数据库游标。文章重点解析了参数传递的安全规范及百分号转义等关键细节,帮助开发者在保持 ORM 便利性的同时灵活处理复杂查询。
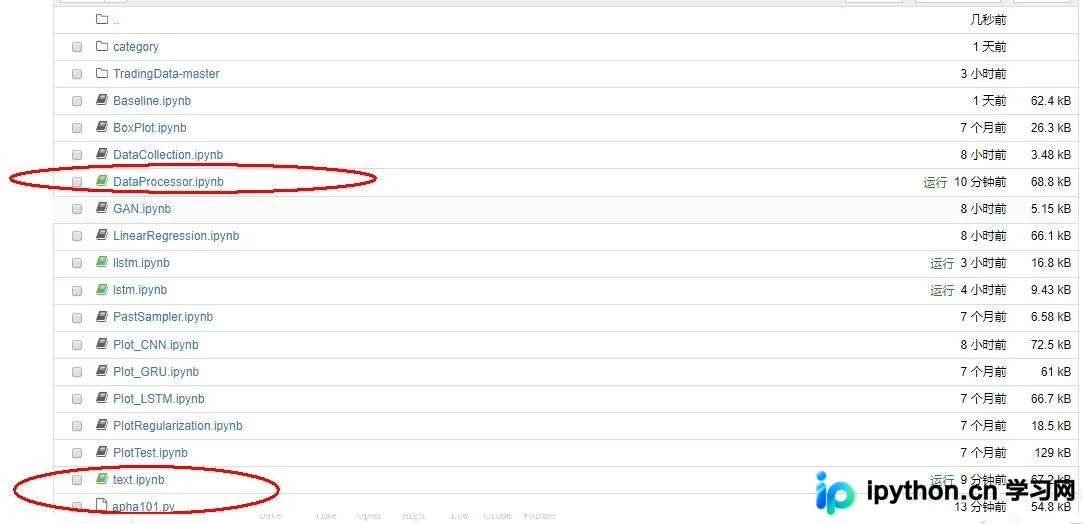
本文解决Jupyter Notebook中因路径包含特殊字符\v被错误翻译为\x0b导致的文件找不到问题,建议通过双斜杠修正路径。同时针对同目录.ipynb导入.py文件提示模块不存在的异常,提供重建Notebook实例的排查方法,帮助开发者快速恢复环境配置。
本文深入解析 Python 全局解释器锁(GIL)的起源、历史移除尝试及当前现状。从单核时代的引用计数机制到多核时代的性能瓶颈,探讨了为何 GIL 难以移除。分析了 Greg Stein 等早期尝试失败的原因,以及 Python 3.2 对 GIL 的优化。结论指出,鉴于庞大的 C 扩展生态和单线程性能考量,Python 移除 GIL 的可能性极低,开发者应通过多进程或异步编程规避其限制。
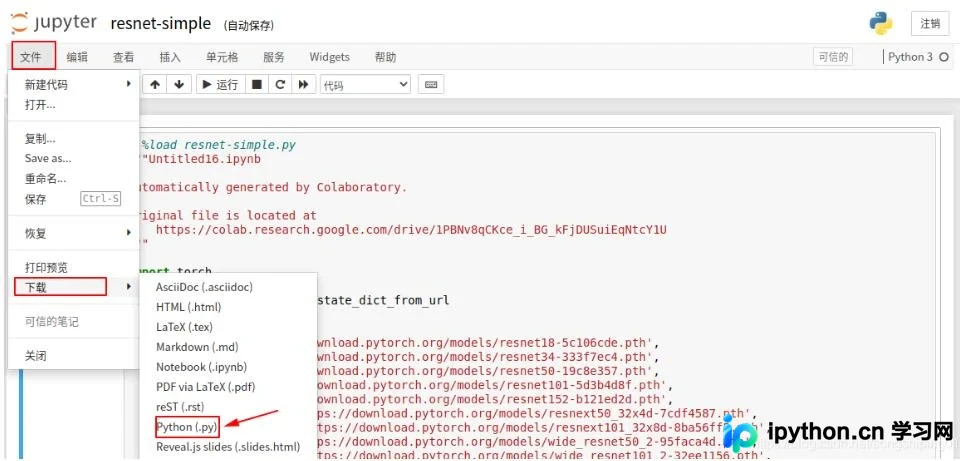
本文介绍在Jupyter Notebook中将.ipynb文件转换为标准.py脚本,以及将.py文件加载为.ipynb格式的方法。通过命令行工具nbconvert或Notebook内置的%load魔法命令,可实现两种格式的高效互转,便于代码复用与协作。
本文详细介绍如何利用Python实现基于空间相似度的K-means轨迹聚类。核心内容涵盖从Excel批量读取含经纬度、速度及方向的轨迹数据,定义并计算基于双向Hausdorff距离的多因素欧氏距离矩阵。通过融合空间、速度与方向权重生成综合距离,并采用非随机策略初始化聚类中心以优化结果。最后结合手肘法与SSE确定最佳聚类数,完成轨迹的高效分类与可视化分析。
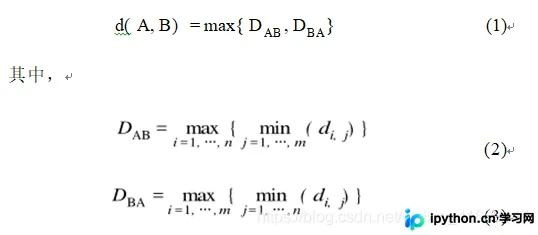
本文介绍如何使用Python通过B站开放API获取用户粉丝数。提供基础查询与带异常处理、定时轮询的监控脚本示例,涵盖requests库安装、UID配置及数据解析步骤,帮助开发者实现粉丝数量变化的自动检测。
本文详细介绍Python标准库shutil模块的核心功能,包括使用make_archive创建归档文件、通过unpack_archive解压归档包,以及执行快速文件复制、压缩和目录递归复制操作。文章结合具体代码示例,解析各函数的参数用法与路径处理,帮助开发者掌握高效的文件管理技巧。
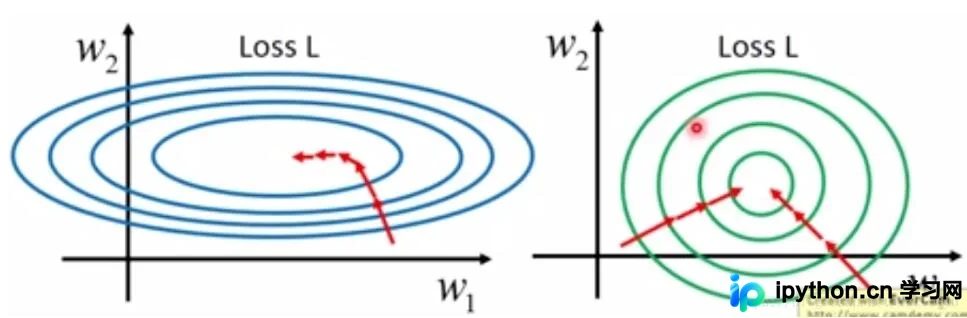
本文详解Python中常用的数据标准化方法,包括[0,1]最大最小归一化与Z-Score标准化。通过公式推导与代码实现,分析两者在加速梯度下降、防止梯度爆炸及处理异常值方面的差异,并明确树模型与距离模型对标准化的不同需求,帮助开发者选择合适的数据预处理策略。
本文详细解析Python中合并列表的八种常见方法,包括使用加号、itertools.chain、解包操作符、extend方法、列表推导式、heapq.merge、魔法方法__add__结合reduce以及yield from生成器。文章强调在团队协作中,代码简洁性与可读性优于炫技,建议根据具体场景(如是否需要排序、性能要求等)选择最合适的合并策略,并指出理解多种写法有助于阅读他人代码。