

Python3 数据标准化实战:Min-Max与Z-Score详解及适用场景

本文详解Python中常用的数据标准化方法,包括[0,1]最大最小归一化与Z-Score标准化。通过公式推导与代码实现,分析两者在加速梯度下降、防止梯度爆炸及处理异常值方面的差异,并明确树模型与距离模型对标准化的不同需求,帮助开发者选择合适的数据预处理策略。
数据标准化是机器学习与数据挖掘流程中的基础环节,也是进行深度学习研究时不可或缺的标准步骤。
实施数据标准化的核心目的在于解决特征向量中数据分布离散度过高的问题,避免绝对值较小的特征在计算中被绝对值较大的特征所掩盖。
此外,数据标准化还能有效加速模型训练过程,并有助于防止训练中出现梯度爆炸现象。
参考李宏毅教授视频中的对比图示,我们可以直观看到标准化前后的差异。
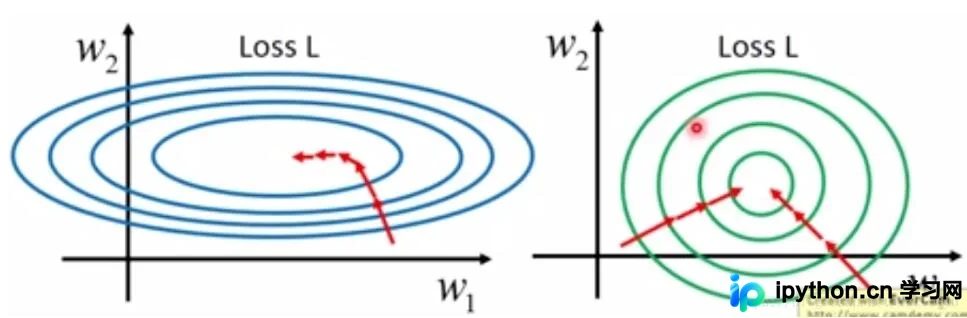
左侧图像展示了未进行数据标准化处理时的损失函数(loss)更新轨迹,右侧图像则展示了经过标准化处理后的情况。对比可见,标准化后的数据更容易迭代至最优解,且收敛速度显著加快。
一、[0, 1] 标准化
[0, 1] 标准化是最基础的数据缩放方法,其目标是将原始数据线性映射并压缩至0到1的区间内。
该方法的标准化计算公式如下:
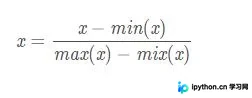
对应的代码实现方式如下:
def MaxMinNormalization(x, min, max):
  """[0,1] normaliaztion"""
  x = (x - min) / (max - min)
  return x
或者采用以下更简洁的实现方式:
def MaxMinNormalization(x):
  """[0,1] normaliaztion"""
  x = (x - np.min(x)) / (np.max(x) - np.min(x))
  return x
二、Z-score标准化
Z-score标准化是一种基于数据均值和方差进行缩放的方法。经过该处理后的数据服从均值为0、方差为1的正态分布。需要注意的是,该方法假设原始数据近似符合高斯分布,否则标准化效果可能不佳。
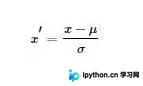
其标准化计算公式如下:
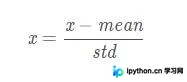
接下来,我们推导为何经过Z-score标准化后的数据均值为0且方差为1。
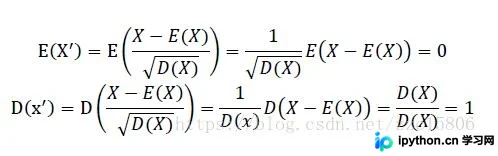
相关代码实现如下:
def ZscoreNormalization(x, mean_, std_):
  """Z-score normaliaztion"""
  x = (x - mean_) / std_
  return x
或者使用以下简化版本:
def ZscoreNormalization(x):
  """Z-score normaliaztion"""
  x = (x - np.mean(x)) / np.std(x)
  return x
补充阅读:Python数据预处理中标准化与归一化的深入理解
数据预处理
由于数据集中不同特征的量纲往往不一致,数值差异巨大,若不进行适当处理,可能会严重影响数据分析结果。因此,需对数据进行按比例缩放,使其落入特定区间,以便于综合评估。
常用的缩放方法主要有两种:
最大-最小规范化(Min-Max Normalization):对原始数据进行线性变换,将数据映射到[0, 1]区间。
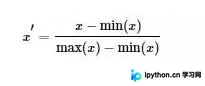
Z-Score标准化:将原始数据映射到均值为0、标准差为1的分布上。
为什么要进行标准化或归一化?
提升模型精度:经过标准化或归一化处理后,不同维度特征在数值上具有可比性,能显著提高分类器的准确性。
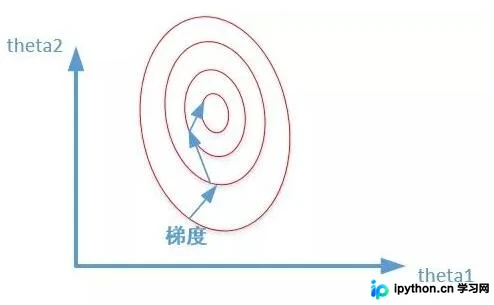
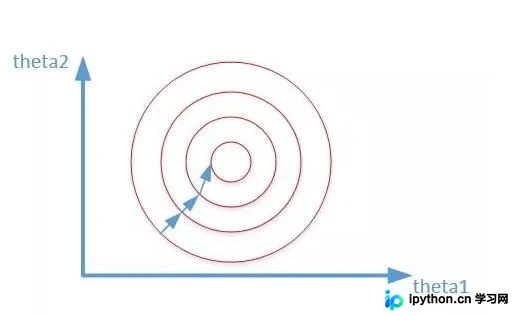
加速模型收敛:标准化或归一化后,最优解的寻优路径变得更加平缓,有助于更正确、快速地收敛到全局最优解。
具体效果如下图所示:
哪些机器学习算法需要标准化和归一化
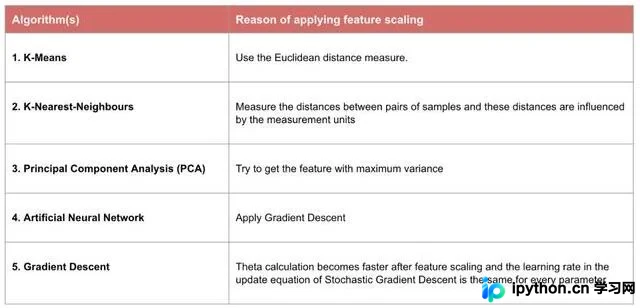
1)基于梯度下降和距离计算的模型必须进行归一化或标准化。若不进行缩放,收敛路径可能呈现Z字形下降,导致收敛缓慢且难以找到最优解。归一化能加快梯度下降求取最优解的速度,并可能提升精度。涉及的模型包括线性回归、逻辑回归、Adaboost、XGBoost、GBDT、SVM、神经网络等。此外,需要计算样本间距离的模型如KNN(K近邻)、KMeans(K均值聚类)也必须进行归一化。
2)概率模型和树形结构模型通常不需要归一化,因为它们关注的是变量的分布及变量间的条件概率,而非变量的具体数值大小,例如决策树和随机森林。
彻底理解标准化和归一化
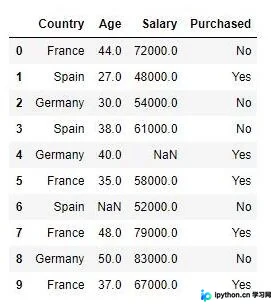
示例数据集包含一个自变量(已购买)和三个因变量(国家、年龄、薪水)。可以看出,薪水的取值范围远大于年龄。如果直接将原始数据用于机器学习模型(如KNN、KMeans),模型结果将完全由薪水主导。
#导入数据
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd
df = pd.read_csv('Data.csv')
缺失值均值填充及字符型变量处理
df['Salary'].fillna((df['Salary'].mean()), inplace= True)
df['Age'].fillna((df['Age'].mean()), inplace= True)
df['Purchased'] = df['Purchased'].apply(lambda x: 0 if x=='No' else 1)
df=pd.get_dummies(data=df, columns=['Country'])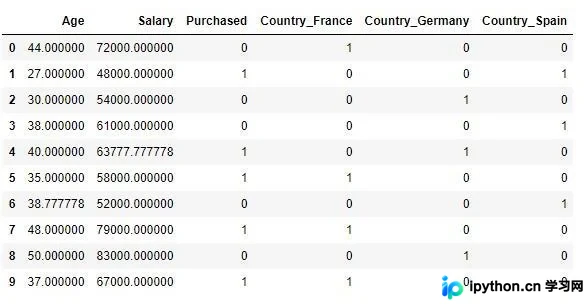
最大-最小规范化
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
scaler.fit(df)
scaled_features = scaler.transform(df)
df_MinMax = pd.DataFrame(data=scaled_features, columns=["Age", "Salary","Purchased","Country_France","Country_Germany", "Country_spain"])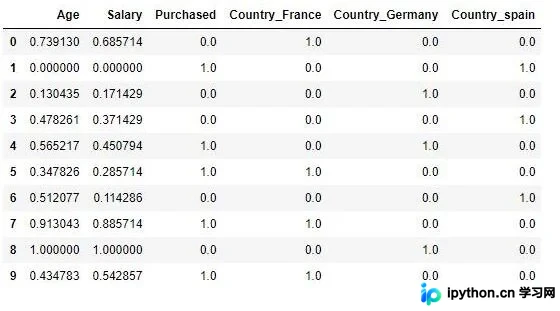
Z-Score标准化
from sklearn.preprocessing import StandardScaler
sc_X = StandardScaler()
sc_X = sc_X.fit_transform(df)
sc_X = pd.DataFrame(data=sc_X, columns=["Age", "Salary","Purchased","Country_France","Country_Germany", "Country_spain"])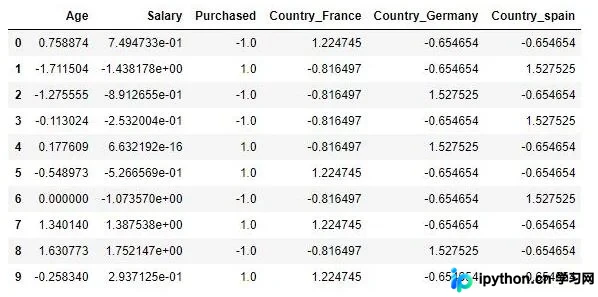
import seaborn as sns
import matplotlib.pyplot as plt
import statistics
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei']
fig,axes=plt.subplots(2,3,figsize=(18,12))
sns.distplot(df['Age'], ax=axes[0, 0])
sns.distplot(df_MinMax['Age'], ax=axes[0, 1])
axes[0, 1].set_title('归一化方差:% s '% (statistics.stdev(df_MinMax['Age'])))
sns.distplot(sc_X['Age'], ax=axes[0, 2])
axes[0, 2].set_title('标准化方差:% s '% (statistics.stdev(sc_X['Age'])))
sns.distplot(df['Salary'], ax=axes[1, 0])
sns.distplot(df_MinMax['Salary'], ax=axes[1, 1])
axes[1, 1].set_title('MinMax:Salary')
axes[1, 1].set_title('归一化方差:% s '% (statistics.stdev(df_MinMax['Salary'])))
sns.distplot(sc_X['Salary'], ax=axes[1, 2])
axes[1, 2].set_title('StandardScaler:Salary')
axes[1, 2].set_title('标准化方差:% s '% (statistics.stdev(sc_X['Salary'])))
从结果可以看出,归一化方法产生的标准差较小,数据更集中在均值附近。这是因为归一化的缩放是“拍扁”并统一至固定区间(仅由极值决定),而标准化的缩放更具“弹性”和“动态”,与整体样本分布密切相关。
因此,归一化对离群值(异常值)的处理能力较弱,而标准化对异常值具有较强的鲁棒性。在许多实际应用场景中,标准化的表现优于归一化。
以上为个人经验分享,希望能为大家提供参考。如有错误或考虑不周之处,欢迎指正。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









